
まず読み込み
最終更新
ローカルLLM用の機器選び:メモリ・速度・消費電力
必要なメモリと許容できる待ち時間でローカルLLM機器を選びます
ローカルLLM1は自分のコンピューターで質問、文書、コードを処理して回答を作るモデルです。機器選びでは格納メモリと応答時間が重要です。普段のPDFやコードを現在の機器で試し、不足箇所を見つけて2候補を比べます。
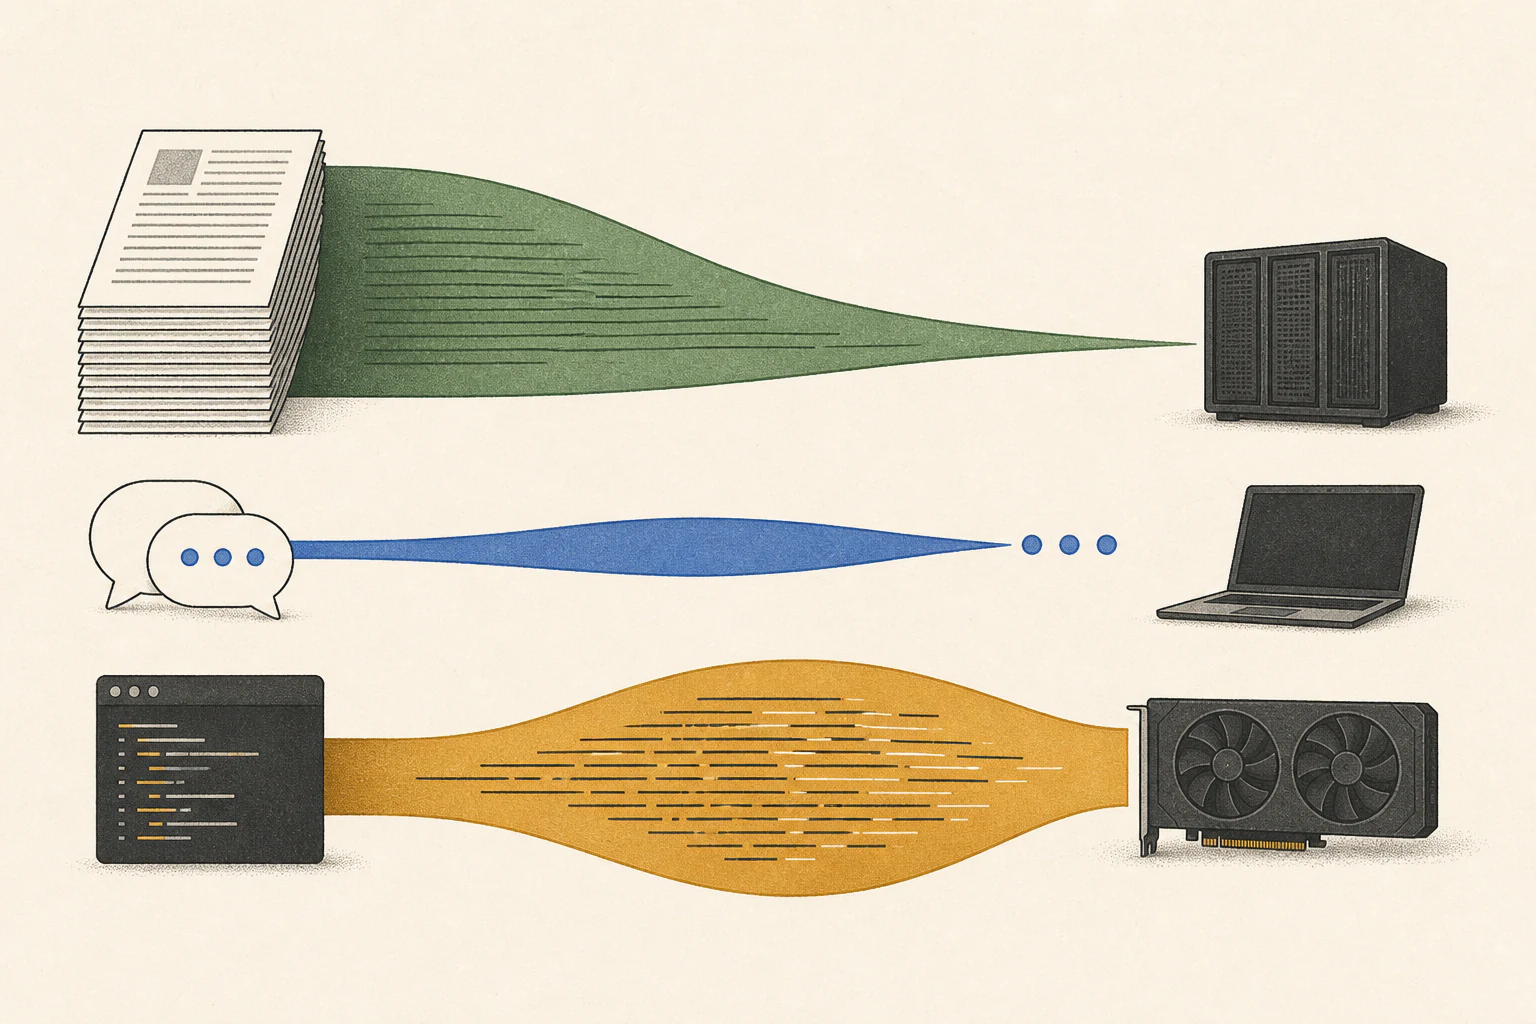
機器にモデルを読み込めなければ容量の問題です。読み込めて回答も正確なのに最初の文字まで時間がかかるなら入力処理の待ち時間を、回答開始後に文章がゆっくり続くなら生成速度を調べます。反対に、すぐ答えてもPDFの日付を誤ったりコードを壊したりするなら、まず依頼やモデルを見直します。GPU2を追加しても回答品質が自動的に上がるわけではありません。
購入前に現在のパソコンで2つの作業を試します
20ページの業務PDFから更新日と根拠を探し、ときどき関数の誤りを直すことが目的なら、その2つを最後まで処理できるかで機器を評価します。公開モデルをすべて動かす最高仕様を基準に始める必要はありません。同じPDFの質問と同じコード依頼を現在のパソコンで実行します。PDF回答では日付と根拠、コード修正では既存テストの合格を確認し、モデル名・量子化3・入力長も記録します。
作業ごとに重要な確認点は異なります。
| 作業 | 最初に確認する結果 | 詰まる場合に見る指標 |
|---|---|---|
| PDF要約・根拠検索 | 日付と根拠箇所が原文と一致するか | 長文入力の初回待ち時間とメモリ余裕 |
| 関数のバグ修正 | 依頼した修正がテストに通るか | 生成時間と修正の繰り返し量 |
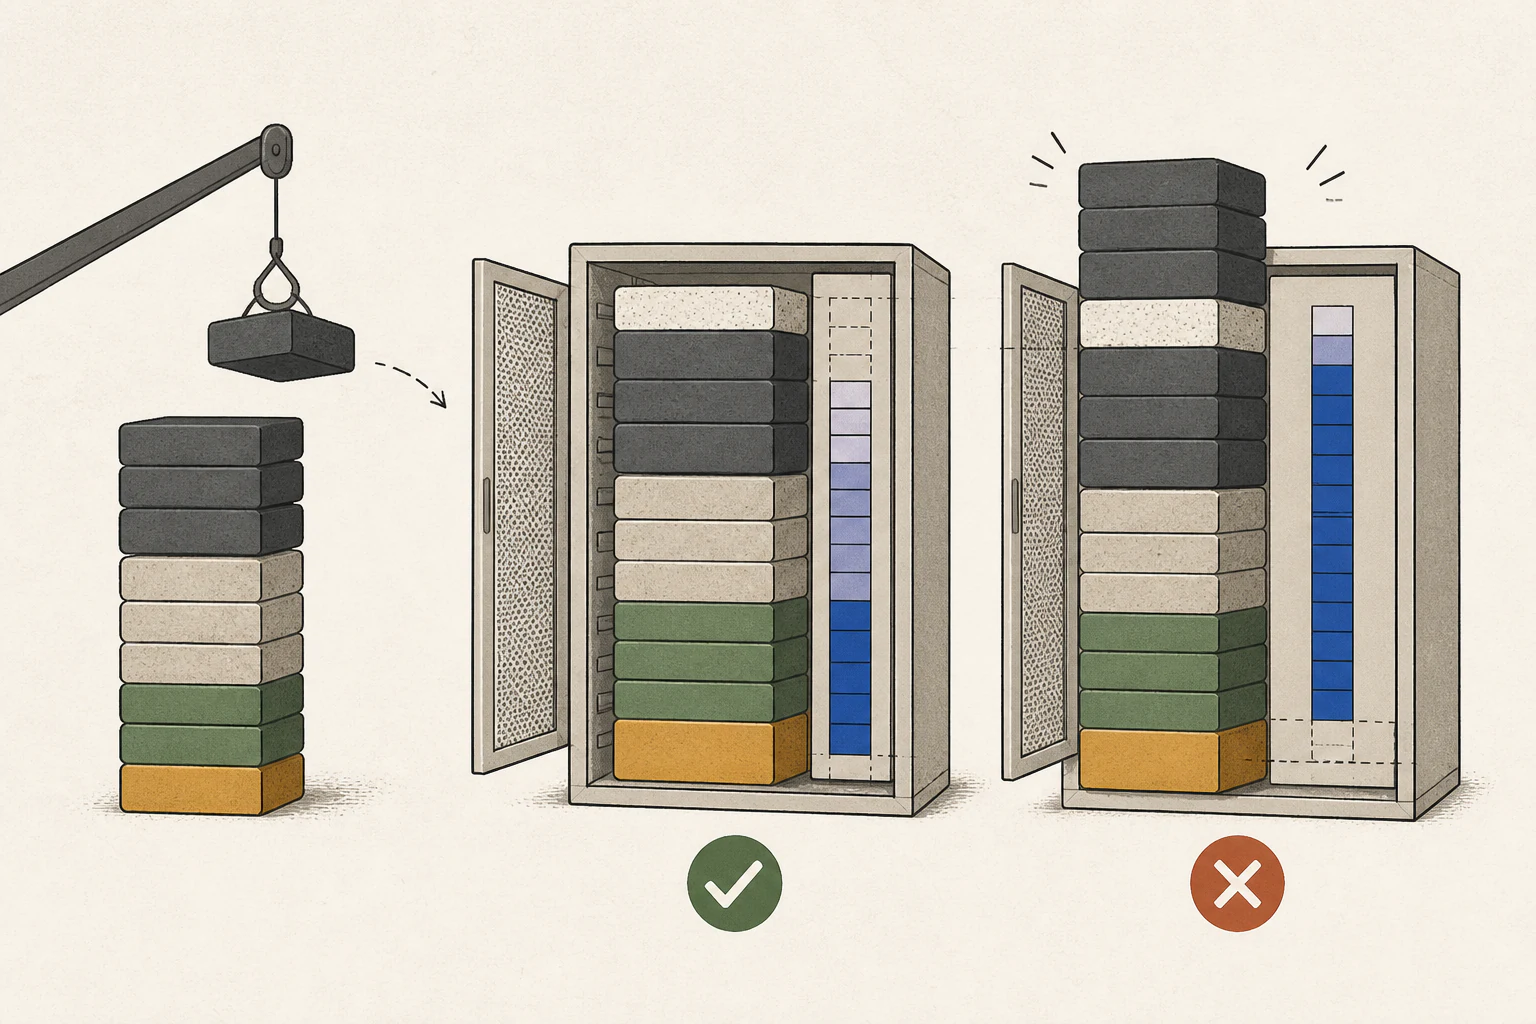
モデルファイルの読み込みと作業全体に必要なメモリは異なります
重みファイルをメモリに読み込んだ後も、実行環境の作業領域と入力・回答用のKV cache4を確保する必要があります。長文書は短い挨拶より多くの文脈を保持し、回答生成にも領域が必要です。そのため短い質問が成功しただけで、同じ構成が20ページのPDFも処理できるとは判断しません。モデル読み込み、文書入力、回答完了までの流れを確認します。
Macのユニファイドメモリ5はOSやアプリと共有され、ディスクリートGPUのVRAM6はシステムRAM7とは別です。どちらも32GBと表示されても、モデル専用に使える量が同じという意味ではありません。ブラウザーや文書ソフトを普段どおり開いておくなら、その分の余裕も残します。表示容量の全てをモデルに使えると計算せず、作業で確認します。
初回回答までの待ち時間と回答生成速度を分けて確認します
200万~300万ウォンの予算では現在のPCに追加する部品から検討します
現在のPCのGPUとVRAMを確認し、使うモデルと入力が収まるか調べます。グラフィックカードだけを追加できるかも確認します。電源容量とコネクター、ケースのカード長・厚さとスロット空間、マザーボードが対応するRAM規格と空きスロット、モデルファイル用のSSD10空き容量を調べます。
現在のPCを活用する見積もりと新しいシステムを買う見積もりを分け、同じ項目で比較します。アップグレード案にはGPUと、実際に交換が必要な電源・ケース・RAM・ストレージ・冷却の費用を加えます。新しいPCやMac案には本体とメモリ・SSDの構成も含めます。中古GPUは保証や返品条件も価格の横に記録します。市場価格は確定見積もりではなく、TCO計算に含まれない本体部品費用は別途加えます。
予算が200万~300万ウォンなら、両方の見積もりが予算内か確認し、同じモデル・量子化・入力長で予想待ち時間を比べます。例の比較URLはRTX 3090 24GBとMac mini M4 32GB、Qwen 3.8 27B、文脈4096を使います。VRAMとユニファイドメモリを数値だけで同じと見なさず、アプリがCUDA11またはmacOSに対応するかも確認します。どちらも予算を超えるならモデルや入力を小さくして試し、実際に不足した点を確かめてから再見積もりします。
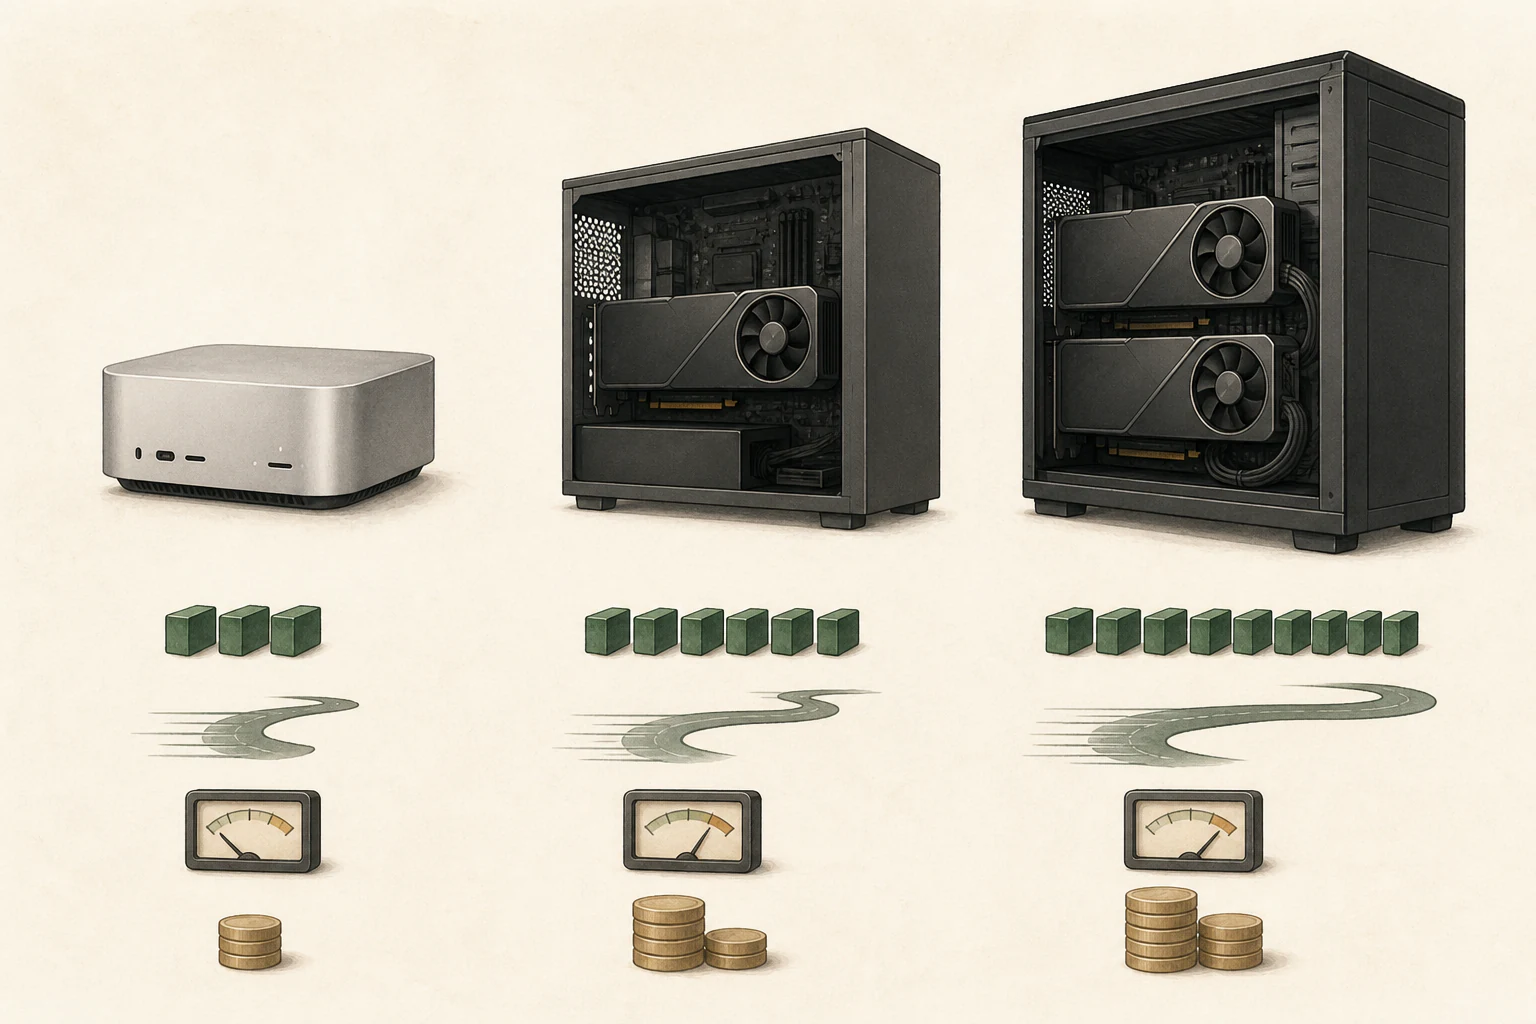
拡張しにくい機器では繰り返す作業を基準に余裕を決めます
購入後にメモリを増やしにくい機器なら、現在の作業と次に必ず試したい作業を書き出し、それぞれの容量要件を確認します。大型モデルを月に1回だけ試し、他の日は小さな文書モデルを使うなら、そのまれな試行に合わせて普段の機器を大型化する必要があるか考えます。「いつか使うかもしれない」と毎週繰り返し詰まる作業は、同じ購入理由ではありません。
一方、文書が増えるたびに同じ上限に当たり、入力を短くすると必要な根拠が消えるなら、作業を完了するためにメモリを増やす必要があるかもしれません。文書の種類と省かざるを得なかった内容を記録しておけば、次の構成を必要以上に大きくせずに繰り返す問題を解決できます。
同じ作業で2候補を最終確認します
候補を2つに絞ったら、最初に試したPDFとコードの依頼、モデルファイル、量子化、入力長を同じ条件にします。メモリ容量が大きい機器なら2つの作業が速く終わると決めつけず、初回応答の待ち時間、生成速度、作業結果を合わせて確認します。購入前にRAM、VRAMまたはユニファイドメモリ、SSDが見積もり対象の製品と一致するか確認します。
現在のパソコンで2つの作業を正確に終えられるなら、そのまま使えます。PDFを入れたときだけメモリが足りないならモデルと文脈が収まる構成を探し、回答は正しいのに待ち時間が長いなら同じモデルを実際に速くする構成を比較します。どの段階も詰まらないなら、残りの予算を使う必要はありません。
用語の注釈
大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るユニファイドメモリ — CPUとGPUが同じ物理メモリ領域を共有する構造です。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るシステムRAM — プログラムの実行中にデータを一時保存するシステムメモリです。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るSSD — フラッシュメモリを使うデータ保存装置です。電源を切ってもデータが保持されます。
本文に戻るCUDA — NVIDIA GPUで汎用計算を行うソフトウェア基盤です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- ローカルLLMは自分のコンピューターで質問、文書、コードを処理して回答を作るモデルです。機器選びでは格納メモリと応答時間が重要です。普段のPDFやコードを現在の機器で試し、不足箇所を見つけて2候補を比べます。
- 必要なメモリはどのくらいですか?
- 重みファイルをメモリに読み込んだ後も、実行環境の作業領域と入力・回答用のKV cacheを確保する必要があります。長文書は短い挨拶より多くの文脈を保持し、回答生成にも領域が必要です。そのため短い質問が成功しただけで、同じ構成が20ページのPDFも処理できるとは判断しません。モデル読み込み、文書入力、回答完了までの流れを確認します。