
실행 프로그램과 확장
최종 업데이트
LiLiCorr란? Bolt와 Super VL의 speculative decoding 경로
LiLiCorr는 target과 runtime별로 drafter 파일과 recipe가 달라요.
LiLiCorr는 여러 다음 토큰1 후보의 연결 관계를 점수화해 target 모델에 보낼 초안 경로를 고르는 speculative decoding2 drafter예요. 필요한 drafter 파일과 설정은 target·runtime3별로 달라요. Bolt는 llama.cpp용 GGUF4 조합, Super VL은 DGX Spark의 vLLM 조합을 사용하므로 각각의 파일 준비와 명령, 공개 지표를 나눠 설명합니다.
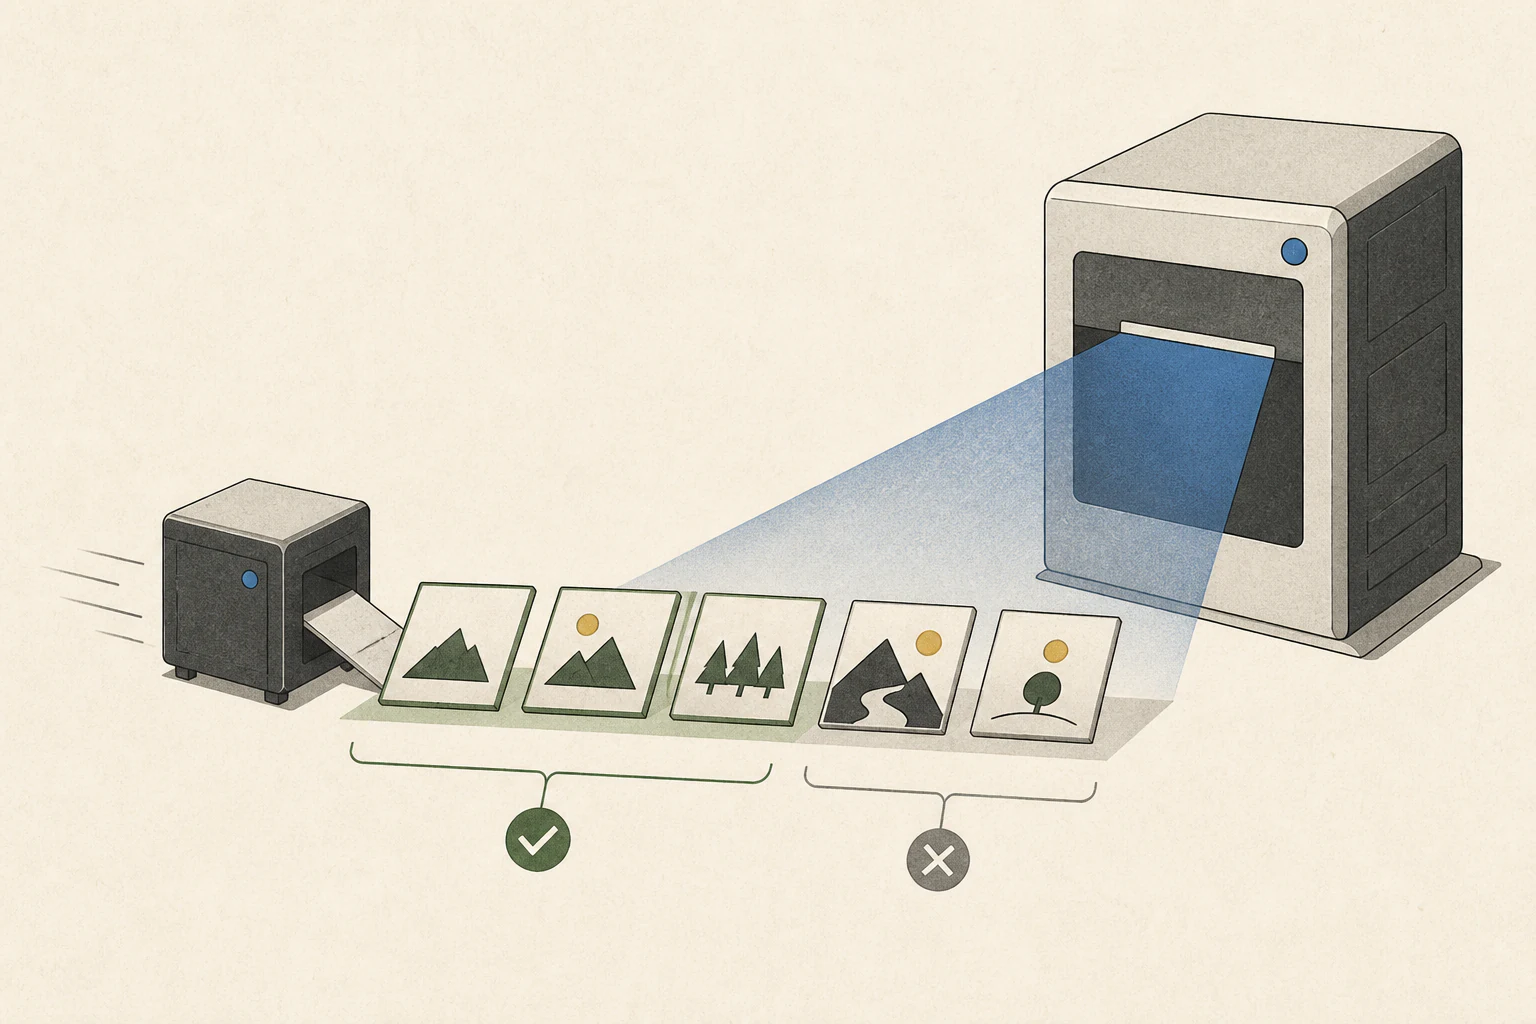
답변을 만들 때 target 모델이 토큰을 하나씩 계산하면 다음 토큰마다 반복 작업이 생겨요. Speculative decoding은 drafter가 후보를 먼저 제안하고 target이 후보 묶음을 검증해, 맞는 구간을 한 번에 받아들이는 방식이에요. LiLiCorr는 후보 사이의 연결성을 계산해 초안 경로를 고릅니다. NVIDIA LiLiCorr 연구
LiLiCorr라는 방법을 쓰더라도 target에 맞는 drafter 파일과 실행 recipe를 골라야 해요. Bolt는 llama.cpp용 GGUF target·drafter 조합을, Super VL은 DGX Spark vLLM용 NVFP45 target·LiLiCorr drafter 조합을 사용합니다. 두 경로의 파일 형식과 설정은 각 모델 카드에 맞춰 준비하세요.
LiLiCorr는 이어지는 후보를 골라요
병렬 초안 모델은 다음 토큰 후보를 여러 위치에서 한 번에 제안해요. LiLiCorr는 후보들 사이의 연결 점수를 계산해 target 모델이 검증할 경로를 골라요. LiLiCorr 방법 설명
속도 향상은 drafter와 target의 조합, 입력 문체, 동시 요청 수에 따라 달라져요. Bolt는 llama.cpp, Super VL은 vLLM으로 실행하므로 각각의 설정을 적용해요.
Bolt: llama.cpp에 GGUF drafter를 연결해요
Bolt 74B-A9B에서는 target GGUF와 LiLiCorr drafter GGUF를 함께 준비해요. llama.cpp server를 --spec-type draft-dflash와 --spec-draft-model 옵션으로 연결해 두 파일을 사용해요.
NVIDIA는 RTX Spark 128GB 또는 VRAM6 48GB 이상 GeForce RTX용 32GB recipe를 제시해요. 이 설정은 context 262,144, 동시 sequence 1개, draft 최대 7토큰을 사용해요.
RTX Spark 64GB 또는 VRAM 32GB 이상에는 context 65,536, 동시 sequence 1개, draft 최대 6토큰, Q8_0 KV cache7를 쓰는 28GB recipe를 안내해요. Bolt GGUF 모델 카드와 recipes
target GGUF와 LiLiCorr drafter GGUF를 내려받고, 아래 첫 코드의 경로를 실제 파일 위치로 바꿔 같은 셸에서 실행하세요. 두 환경 변수가 설정되면 다음 명령으로 파일을 연결할 수 있어요. context·cache·draft token 옵션은 선택한 GPU8에 맞는 모델 카드 recipe를 적용합니다.
export BOLT_GGUF="/absolute/path/to/target.gguf"
export LILICORR_GGUF="/absolute/path/to/lilicorr-drafter.gguf"llama-server -m "$BOLT_GGUF" \
--spec-type draft-dflash \
--spec-draft-model "$LILICORR_GGUF" \
--host 127.0.0.1Super VL: DGX Spark에서 vLLM LiLiCorr를 써요
DGX Spark(GB10)에서는 NVIDIA의 Super VL LiLiCorr profile을 사용해요. vLLM 컨테이너 안에서 NVFP4 target과 별도의 ...NVFP4-LiLiCorr drafter를 실행해요.
NVIDIA 설정은 동시 sequence 1개, draft 7토큰, GPU 메모리 사용률 0.75, batched tokens 8,192예요. vLLM recipe에는 이 DGX Spark LiLiCorr 경로와 RTX PRO 6000 native MTP9 경로가 따로 있어요. Super VL LiLiCorr 모델 카드
동일 target에는 native MTP 경로도 있어요. MTP는 target 내부 예측 head를 사용하고 LiLiCorr는 별도 drafter checkpoint10가 필요하므로, 명령의 speculative method와 모델 인자를 서로 바꿔 적용하지 마세요. 첫 요청은 짧은 텍스트로 API11 모델명을 확인하고, 이후 이미지 입력과 평소 동시 요청 수를 추가해 메모리와 응답 완료 시간을 기록해요.
공개 측정은 지표와 workload를 같이 읽어요
NVIDIA 연구는 같은 데이터로 학습한 vanilla DFlash와 비교해 LiLiCorr의 acceptance length가 9–19%, greedy decoding12 throughput13이 4–13% 높았다고 보고해요. Qwen3 4B·8B 등을 H100에서 시험한 결과예요.
Super VL LiLiCorr 카드의 SPEED-Bench는 draft length 7, 프롬프트14 880개, 동시 요청 64개, seed 3회 평균 조건에서 acceptance length 4.74(temperature 0)와 4.36(temperature 1)을 기록해요.
여기서 64는 벤치마크 부하예요. DGX Spark serving recipe는 --max-num-seqs 1을 설정해요. Acceptance length는 평균 수락 토큰 수를 뜻해요.
Bolt 공개 측정에는 별도의 노트북·런타임 결과가 있어요. RTX Spark가 들어간 128GB Surface Laptop Ultra에서 Windows 11 ARM과 llama.cpp로 Bolt IQ2_XXS + LiLiCorr를 실행해 AIPerf SPEED-Bench-Coding 83.99 TPS와 AA-AgentPerf Local 재생 600.80초를 기록했습니다. 이는 해당 Bolt 구성과 workload의 실측이에요. Bolt 측정 조건
용어 각주
토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기추측 디코딩 — 초안 모델·MTP 헤드·반복 문맥 조회가 출력 후보를 먼저 만들고, 본 모델이 후보를 검증해 확정하는 생성 기법입니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기GGUF — 모델 정보를 담는 파일 형식으로 llama.cpp 계열 도구에서 널리 사용됩니다.
본문으로 돌아가기NVFP4 — NVIDIA가 정의한 4비트 부동소수점 데이터 형식입니다. 지원 여부는 GPU 세대, 모델과 소프트웨어 구현에 따라 다릅니다.
본문으로 돌아가기VRAM — 그래픽카드의 GPU가 사용하는 메모리입니다. 모델 가중치와 계산 중간값을 저장합니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기MTP — 한 번에 여러 미래 토큰을 예측하도록 학습하는 목표 또는 이를 수행하는 모델 구성입니다. 추측 디코딩에서는 이 예측을 후보 토큰으로 제안할 수 있습니다.
본문으로 돌아가기체크포인트 — 학습된 모델의 가중치 등을 저장한 파일입니다. 같은 모델 계열도 버전이나 용도에 따라 다른 체크포인트를 쓸 수 있습니다.
본문으로 돌아가기API — 프로그램의 기능을 다른 코드에서 호출하기 위한 약속된 인터페이스입니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기프롬프트 — 모델에 보내는 입력문입니다. 생성 모델에서는 만들 결과를 설명하는 문장이 되어 출력의 구성과 내용을 크게 좌우합니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- LiLiCorr는 여러 다음 토큰 후보의 연결 관계를 점수화해 target 모델에 보낼 초안 경로를 고르는 speculative decoding drafter예요. 필요한 drafter 파일과 설정은 target·runtime별로 달라요. Bolt는 llama.cpp용 GGUF 조합, Super VL은 DGX Spark의 vLLM 조합을 사용하므로 각각의 파일 준비와 명령, 공개 지표를 나눠 설명합니다.
- 필요한 메모리는 어느 정도인가요?
- NVIDIA는 RTX Spark 128GB 또는 VRAM 48GB 이상 GeForce RTX용 32GB recipe를 제시해요. 이 설정은 context 262,144, 동시 sequence 1개, draft 최대 7토큰을 사용해요.
- 선택하지 않는 편이 좋은 경우는 언제인가요?
- 동일 target에는 native MTP 경로도 있어요. MTP는 target 내부 예측 head를 사용하고 LiLiCorr는 별도 drafter checkpoint가 필요하므로, 명령의 speculative method와 모델 인자를 서로 바꿔 적용하지 마세요. 첫 요청은 짧은 텍스트로 API 모델명을 확인하고, 이후 이미지 입력과 평소 동시 요청 수를 추가해 메모리와 응답 완료 시간을 기록해요.
- 조건과 출처는 어디서 확인하나요?
- RTX Spark 64GB 또는 VRAM 32GB 이상에는 context 65,536, 동시 sequence 1개, draft 최대 6토큰, Q8_0 KV cache를 쓰는 28GB recipe를 안내해요. [Bolt GGUF 모델 카드와 recipes](https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF/blob/main/README.md)