
実行プログラムと拡張機能
最終更新
LiLiCorrとは?BoltとSuper VLのspeculative decoding
LiLiCorrではtargetとruntimeごとにdrafterファイルとrecipeが異なります。
LiLiCorrは次トークン1候補間のつながりを評価し、ターゲットモデルに渡すドラフト経路を選ぶspeculative decoding2用ドラフターです。必要なdrafterファイルと設定はtarget・runtime3ごとに異なります。Boltはllama.cpp用GGUF4の組み合わせ、Super VLはDGX SparkのvLLM用の組み合わせを使うため、ファイル準備、コマンド、公開指標を分けて説明します。
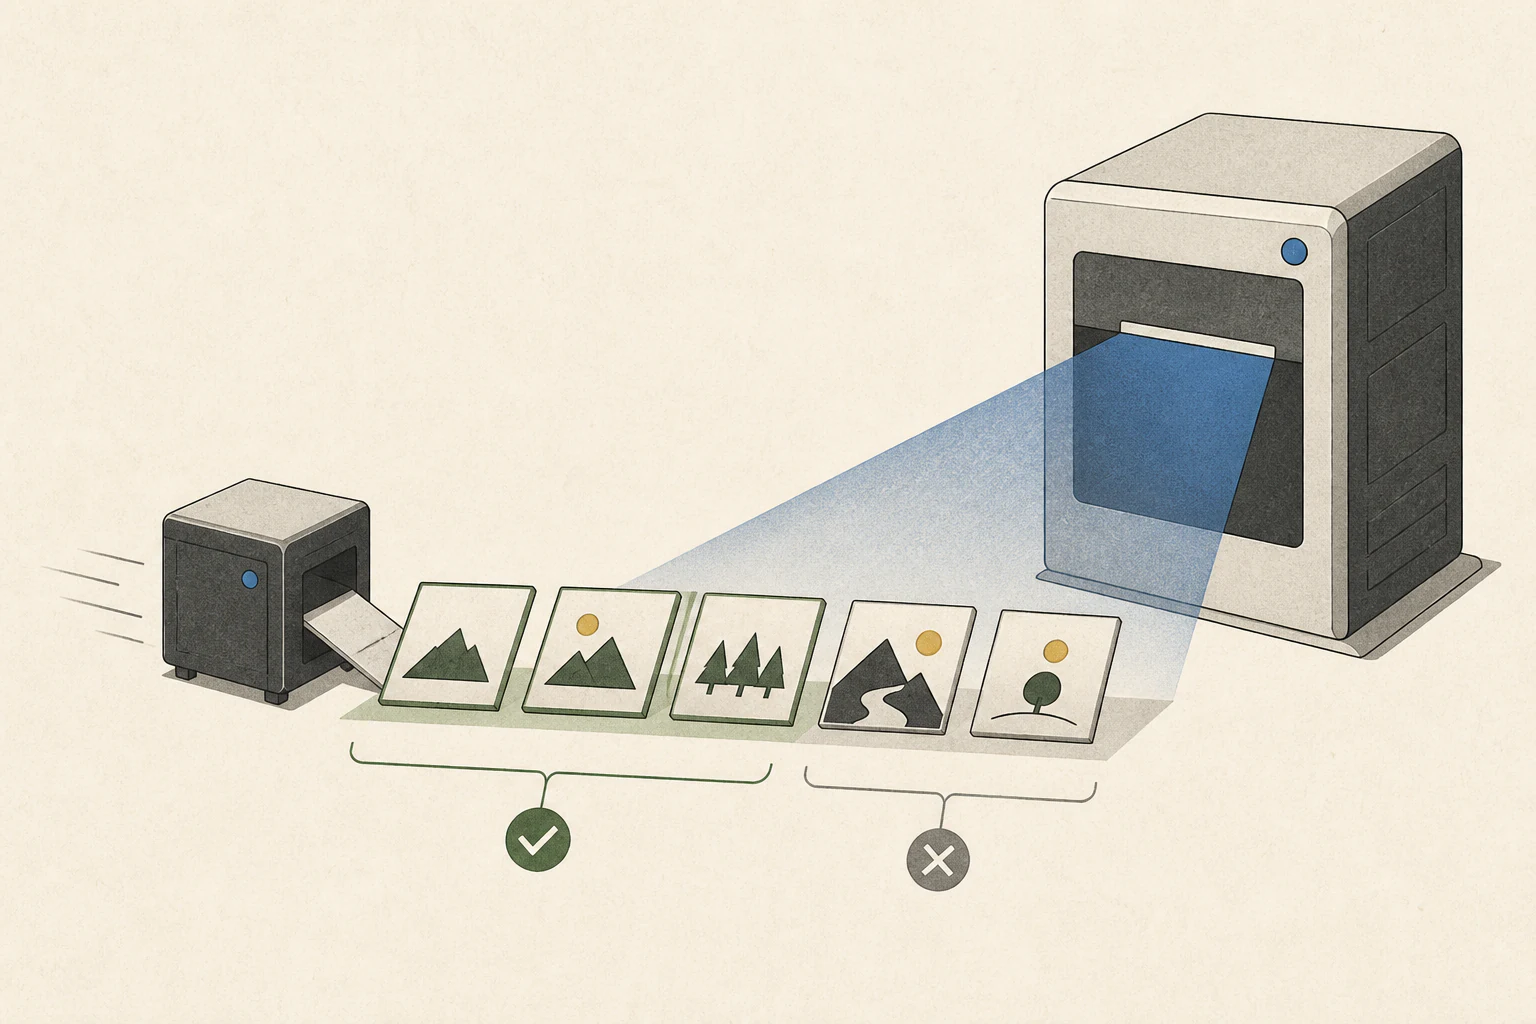
ターゲットモデルが1トークンずつ回答を生成すると、次のトークンごとに計算を繰り返します。speculative decodingではドラフターが候補を先に提案し、ターゲットが候補のまとまりを検証して、一致した部分をまとめて受け入れます。LiLiCorrは候補間のつながりを評価してドラフト経路を選びます。NVIDIA LiLiCorr研究
LiLiCorrを使う場合も、targetに合うdrafterファイルと実行recipeを選びます。Boltはllama.cpp用のGGUF target・drafter、Super VLはDGX SparkのvLLM用NVFP45 target・LiLiCorr drafterを使います。各モデルカードに合うファイル形式と設定を用意してください。
LiLiCorrはつながる候補を選ぶ
並列ドラフトモデルは複数の位置で次トークンの候補を一度に提案します。LiLiCorr は候補間のつながりを採点し、target モデルが検証する経路を選びます。LiLiCorr の手法
速度向上の度合いは drafter と target の組み合わせ、入力文体、同時リクエスト数によって変わります。Bolt は llama.cpp、Super VL は vLLM で動かすため、それぞれの設定を使います。
Bolt:llama.cppでGGUFドラフターを指定
Bolt 74B-A9B では target GGUF と LiLiCorr drafter GGUF の両方を用意します。--spec-type draft-dflash と --spec-draft-model オプションで llama.cpp server に接続します。
NVIDIA は RTX Spark 128GB または VRAM6 48GB 以上の GeForce RTX 向けに 32GB recipe を提示しています。この設定は context 262,144、同時 sequence 1 件、draft 最大 7 トークンです。
RTX Spark 64GB または VRAM 32GB 以上には、context 65,536、sequence 1 件、draft 最大 6 トークン、Q8_0 KV cache7 を使う 28GB recipe が案内されています。Bolt GGUF モデルカードと recipes
target GGUFとLiLiCorr drafter GGUFをダウンロードします。最初のコードのパスを実際のファイル位置に置き換え、同じshellで実行してください。両方の環境変数を設定したら、次のコマンドでファイルを組み合わせます。context・cache・draft tokenの設定はGPU8に合うモデルカードのrecipeを適用してください。
export BOLT_GGUF="/absolute/path/to/target.gguf"
export LILICORR_GGUF="/absolute/path/to/lilicorr-drafter.gguf"llama-server -m "$BOLT_GGUF" \
--spec-type draft-dflash \
--spec-draft-model "$LILICORR_GGUF" \
--host 127.0.0.1Super VL:DGX SparkでvLLM LiLiCorrを使う
DGX Spark(GB10)では NVIDIA の Super VL LiLiCorr profile を使用します。vLLM コンテナ内で NVFP4 target と別個の ...NVFP4-LiLiCorr drafter を実行します。
NVIDIA の設定は、同時 sequence 1 件、draft 7 トークン、GPU メモリ使用率 0.75、batched tokens 8,192 です。vLLM recipe では、この DGX Spark LiLiCorr 経路と RTX PRO 6000 の native MTP9 経路が別々に記載されています。Super VL LiLiCorr モデルカード
同じターゲットにはnative MTP経路もあります。MTPはターゲット内部の予測headを使い、LiLiCorrには別のドラフターcheckpoint10が必要です。speculative methodとモデル引数を混同しないでください。短いテキスト要求でAPI11モデル名を確認してから画像入力や通常の同時リクエスト数を加え、メモリ使用量と完了時間を記録します。
指標とworkloadを合わせて読む
NVIDIA の研究では、同じデータで学習した vanilla DFlash と比べて、LiLiCorr の acceptance length が 9~19%、greedy decoding12 throughput13 が 4~13% 高かったと報告されています。Qwen3 4B・8B などを H100 で比較した結果です。
Super VL LiLiCorr カードの SPEED-Bench では、draft length 7、プロンプト14 880 件、同時リクエスト 64 件、3 seed の平均で、acceptance length は temperature 0 で 4.74、temperature 1 で 4.36 でした。
ここでの 64 はベンチマークの負荷です。DGX Spark の serving recipe は --max-num-seqs 1 を設定します。Acceptance length は平均受理トークン数を意味します。
Boltには別のノートPC実測があります。RTX Spark搭載の128GB Surface Laptop UltraでWindows 11 ARMとllama.cppを使い、Bolt IQ2_XXS + LiLiCorrはAIPerf SPEED-Bench-Codingで83.99 TPS、AA-AgentPerf Local replayで600.80秒でした。この値はそのBolt構成とworkloadの結果です。Bolt測定条件
用語の注釈
トークン — モデルが入力や出力を分けて処理する単位です。
本文に戻る投機的デコーディング — ドラフトモデル、MTPヘッド、反復文脈の検索が出力候補を先に作り、メインモデルが検証して確定する生成手法です。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るGGUF — モデル情報を格納するファイル形式で、llama.cpp系のツールで広く使われます。
本文に戻るNVFP4 — NVIDIAが定義した4ビット浮動小数点データ形式です。対応状況はGPU世代、モデル、ソフトウェア実装によって異なります。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るMTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るスループット — 一定時間に処理・生成した作業量です。トークン/秒やリクエスト/秒など、単位を合わせて比較します。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- LiLiCorrは次トークン候補間のつながりを評価し、ターゲットモデルに渡すドラフト経路を選ぶspeculative decoding用ドラフターです。必要なdrafterファイルと設定はtarget・runtimeごとに異なります。Boltはllama.cpp用GGUFの組み合わせ、Super VLはDGX SparkのvLLM用の組み合わせを使うため、ファイル準備、コマンド、公開指標を分けて説明します。
- 必要なメモリはどのくらいですか?
- NVIDIA は RTX Spark 128GB または VRAM 48GB 以上の GeForce RTX 向けに 32GB recipe を提示しています。この設定は context 262,144、同時 sequence 1 件、draft 最大 7 トークンです。
- 選ばないほうがよいのはどのような場合ですか?
- 同じターゲットにはnative MTP経路もあります。MTPはターゲット内部の予測headを使い、LiLiCorrには別のドラフターcheckpointが必要です。speculative methodとモデル引数を混同しないでください。短いテキスト要求でAPIモデル名を確認してから画像入力や通常の同時リクエスト数を加え、メモリ使用量と完了時間を記録します。
- 条件と出典はどこで確認できますか?
- RTX Spark 64GB または VRAM 32GB 以上には、context 65,536、sequence 1 件、draft 最大 6 トークン、Q8_0 KV cache を使う 28GB recipe が案内されています。[Bolt GGUF モデルカードと recipes](https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF/blob/main/README.md)