
실행 프로그램과 확장
최종 업데이트
RTX 3090 48GB 개조, 인수 전에 확인할 것
개조는 용량을 늘리지만 936GB/s 대역폭과 디코드 속도는 그대로예요.
48GB 개조는 메모리 칩을 실제로 바꾸는 작업이고, 드라이버가 49152MiB로 보고하는지가 첫 관문이에요. 부팅과 화면 출력이 되더라도 고용량 할당이나 장시간 부하에서 실패할 수 있어서, 인수 전에 정해진 검사를 돌리고 리포트를 남겨야 합니다. 대역폭은 24GB 모델과 같아서 토큰1 생성이 빨라지지는 않고, 큰 모델을 한 장에 올릴 수 있다는 점이 이득이에요.
48GB 개조는 메모리 칩 교체 작업이에요
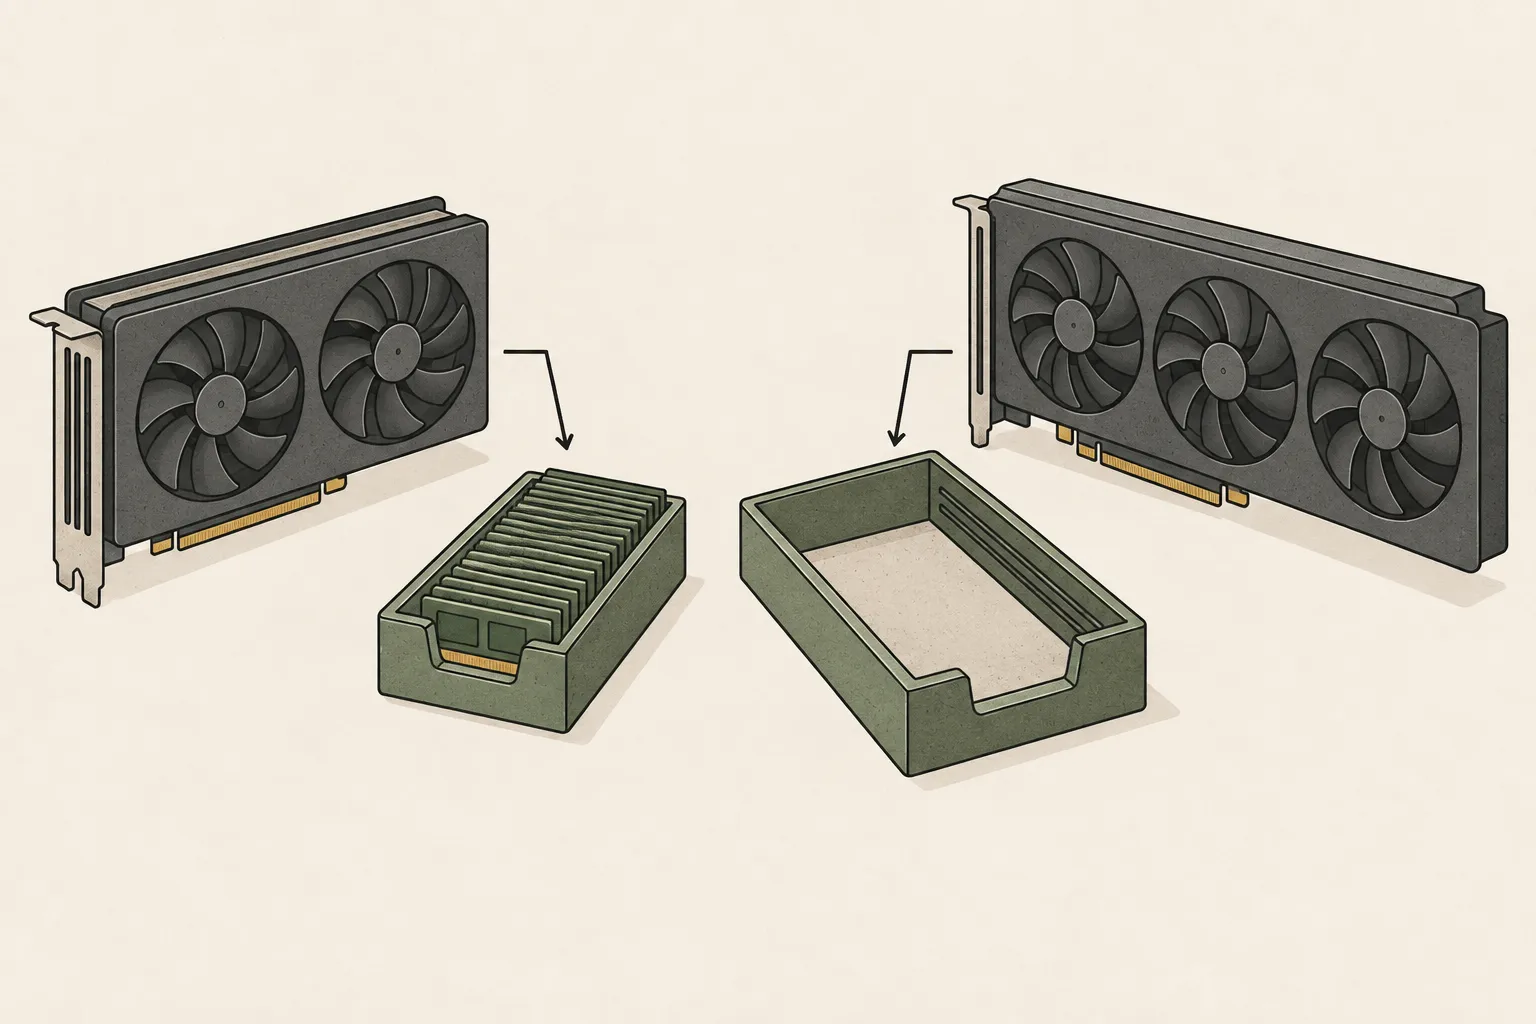
부팅 성공은 합격 증거가 아니에요
인수 전 검사 항목
검사 도구는 카드 이름에 3090이 들어가는지, VRAM이 약 49152MiB로 보고되는지, PyTorch CUDA가 같은 크기를 보는지, 연산 능력이 3090급인 8.6인지, 기본 설정에서 목표 메모리의 92%까지 쓰기가 되는지를 확인해요. PCIe 링크, VBIOS, 드라이버, 전력, 온도, 사용률도 함께 기록합니다.
OS 로그 검사도 항목이에요. Linux에서는 NVIDIA·Xid·PCIe 커널 오류를, Windows에서는 NVIDIA·Display·WHEA·PCIe 시스템 이벤트를 확인합니다. 로그를 읽을 권한이 없어 확인하지 못한 항목은 통과로 처리하지 않고 사람이 다시 보게 만듭니다.
| 검사 항목 | 기준 |
|---|---|
| GPU 이름 | 3090 포함 |
| VRAM | 약 49152MiB |
| 연산 능력 | 8.6 |
| 메모리 쓰기 | 기본 92%, 스트레스 95% |
| OS 로그 | NVIDIA·Xid·WHEA·PCIe 오류 없음 |
검사 실행과 판정
작업장에서는 짧은 검사를 먼저 돌리고, 인수용으로는 스트레스를 길게 잡아요. 검사 도구는 --stress-seconds 1800 --vram-fraction 0.95처럼 시간과 할당 비율을 지정할 수 있고, --expected-memory-mib 49152 --memory-tolerance-mib 1024로 기대 용량과 허용 오차를 바꿀 수 있습니다. 리포트는 reports/에 마크다운과 JSON으로 남아요.
판정은 세 가지예요. 실패나 경고가 없으면 ACCEPT, 강한 실패는 없지만 사람이 봐야 할 항목이 있으면 REVIEW, 필수 검사가 하나라도 실패하면 REJECT입니다. REJECT는 인수하지 말고, REVIEW는 PCIe 경고·온도·권한 문제를 확인한 뒤 결정하세요.
chmod +x install.sh gpu-validator.sh
./install.sh
./gpu-validator.sh --quick
./gpu-validator.sh --stress-seconds 1800 --vram-fraction 0.95
# 재부팅 후 같은 카드에서 다시 확인
./gpu-validator.sh --quick
용량은 늘고 속도는 그대로예요
개조의 이득은 하나예요. 24GB에 들어가지 않던 모델을 한 장에 올릴 수 있습니다. 24GB 두 장을 텐서 병렬7로 묶는 방법과 달리 카드 사이 통신이 필요 없고, 각 카드에 나눠 담느라 생기는 동기화 비용도 없어요. 대신 전력과 발열은 한 장에 몰립니다.
속도를 기대하면 실망해요. 사이트에 공개한 3090 측정에서도 디코드는 350W 68.9 tok/s, 250W 51.0 tok/s로 전력 상한에 따라 달라졌지, 메모리 용량이 속도를 바꾸지는 않았어요. 개조 카드도 같은 대역폭 위에 서 있습니다.
개조 카드에 남는 위험
개조 카드는 제조사 보증 대상이 아니에요. 드라이버나 커널을 올린 뒤 메모리 보고가 달라지는 사례가 나올 수 있고, 그때는 같은 검사를 다시 돌려야 합니다. 판매자 보증 문구가 “정상 동작”이 아니라 “49152MiB 보고와 스트레스 통과”처럼 검사 결과를 가리키는지 확인하세요.
중고로 되팔 때도 같은 리포트가 필요해요. 검사 기록을 남겨 두면 인수자와 판매자 양쪽 모두 조건을 확인할 수 있습니다. 판매 전에도 같은 검사를 돌려 두면 조건을 그대로 제시할 수 있어요.
용어 각주
토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기PyTorch — AI 모델을 만들고 실행하는 소프트웨어 프레임워크입니다. 모델과 함께 호환되는 PyTorch 버전 및 하드웨어 지원도 확인해야 합니다.
본문으로 돌아가기메모리 대역폭 — 메모리와 프로세서 사이에서 단위 시간에 전송할 수 있는 데이터 양입니다. 보통 초당 바이트(B/s)로 나타냅니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기CUDA — NVIDIA GPU에서 범용 계산을 실행하기 위한 소프트웨어 플랫폼입니다.
본문으로 돌아가기VRAM — 그래픽카드의 GPU가 사용하는 메모리입니다. 모델 가중치와 계산 중간값을 저장합니다.
본문으로 돌아가기텐서 병렬 — 모델 층 안의 행렬과 연산을 여러 장치로 분할해 함께 계산하는 방식입니다. 부분 결과를 모으기 위해 장치 간 통신이 필요합니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- 48GB 개조는 메모리 칩을 실제로 바꾸는 작업이고, 드라이버가 49152MiB로 보고하는지가 첫 관문이에요. 부팅과 화면 출력이 되더라도 고용량 할당이나 장시간 부하에서 실패할 수 있어서, 인수 전에 정해진 검사를 돌리고 리포트를 남겨야 합니다. 대역폭은 24GB 모델과 같아서 토큰 생성이 빨라지지는 않고, 큰 모델을 한 장에 올릴 수 있다는 점이 이득이에요.
- 필요한 메모리는 어느 정도인가요?
- 48GB 개조는 소프트웨어 설정이 아니라 카드의 GDDR6X 칩을 교체하는 물리 작업이에요. 성공하면 드라이버가 메모리 용량을 `49152MiB`로 보고하고, PyTorch 같은 프레임워크도 같은 크기를 봅니다. 커널 모듈로 연산률을 여는 언락과는 완전히 다른 종류의 작업이에요.
- 선택하지 않는 편이 좋은 경우는 언제인가요?
- 개조의 이득은 하나예요. 24GB에 들어가지 않던 모델을 한 장에 올릴 수 있습니다. 24GB 두 장을 텐서 병렬로 묶는 방법과 달리 카드 사이 통신이 필요 없고, 각 카드에 나눠 담느라 생기는 동기화 비용도 없어요. 대신 전력과 발열은 한 장에 몰립니다.