
실행 프로그램과 확장
최종 업데이트
3090 언락하면 로컬 LLM이 빨라질까? 프리필·배치·디코드
한 요청의 디코드보다 프리필·동시 요청·파인튜닝에서 차이가 날 수 있어요.
RTX 3090의 BF161 언락은 행렬 연산 처리량2을 올리지만, 한 요청의 토큰3 생성은 메모리 대역폭4에 묶여 있어요. 긴 문서를 한 번에 읽는 프리필5, 여러 요청을 묶는 배치, LoRA6 파인튜닝은 연산 비중이 커서 영향이 나타날 수 있어요. 다만 3090 자체의 공개 측정값이 아직 없어서, 기대치를 정하고 직접 재는 것이 먼저예요.
디코드는 연산이 아니라 대역폭이 병목이에요
토큰을 하나씩 만들 때 모델은 매 단계마다 가중치를 메모리에서 읽어요. RTX 3090의 936GB/s 대역폭은 이 읽기를 기다리는 시간을 정하지, BF16 행렬 연산 유닛의 처리량이 속도를 정하지 않습니다. 그래서 언락으로 연산률이 올라도 한 요청의 tok/s는 거의 그대로예요.
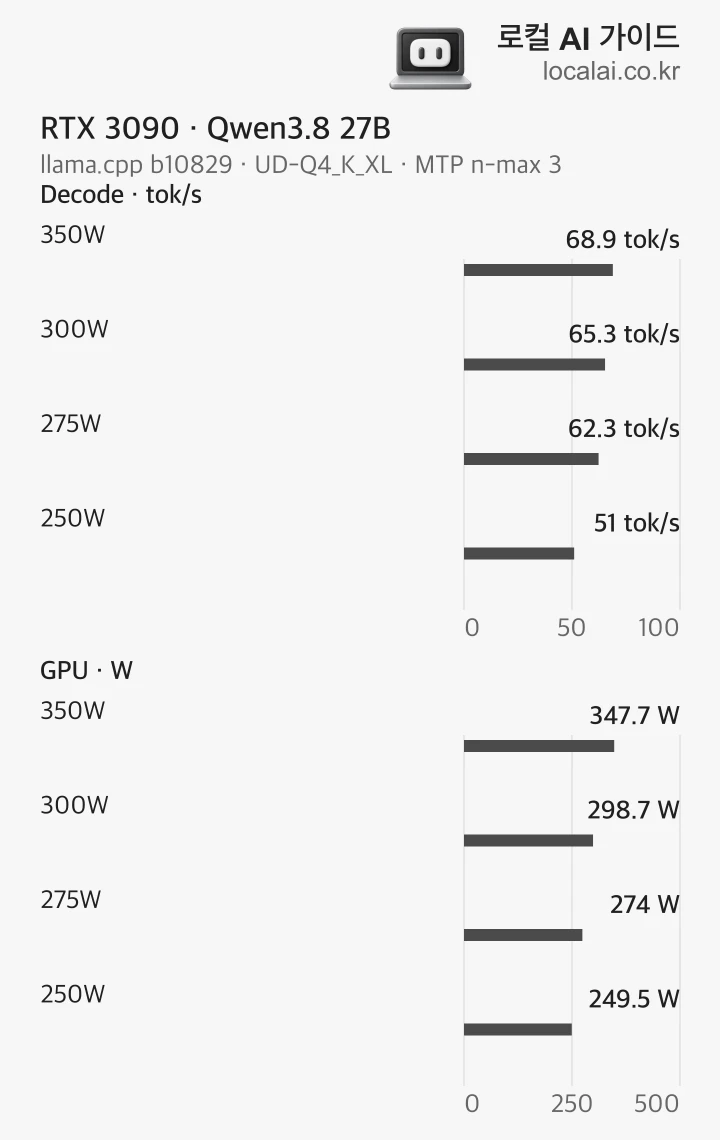
사이트에 공개한 3090 측정도 같은 방향이에요. Qwen3.8 27B UD-Q4_K_XL, MTP7 n-max 3 조건에서 350W일 때 68.9 tok/s, 250W일 때 51.0 tok/s였어요. 전력 상한을 낮추면 느려지지만, 이는 연산이 아니라 클록과 전력의 문제입니다.
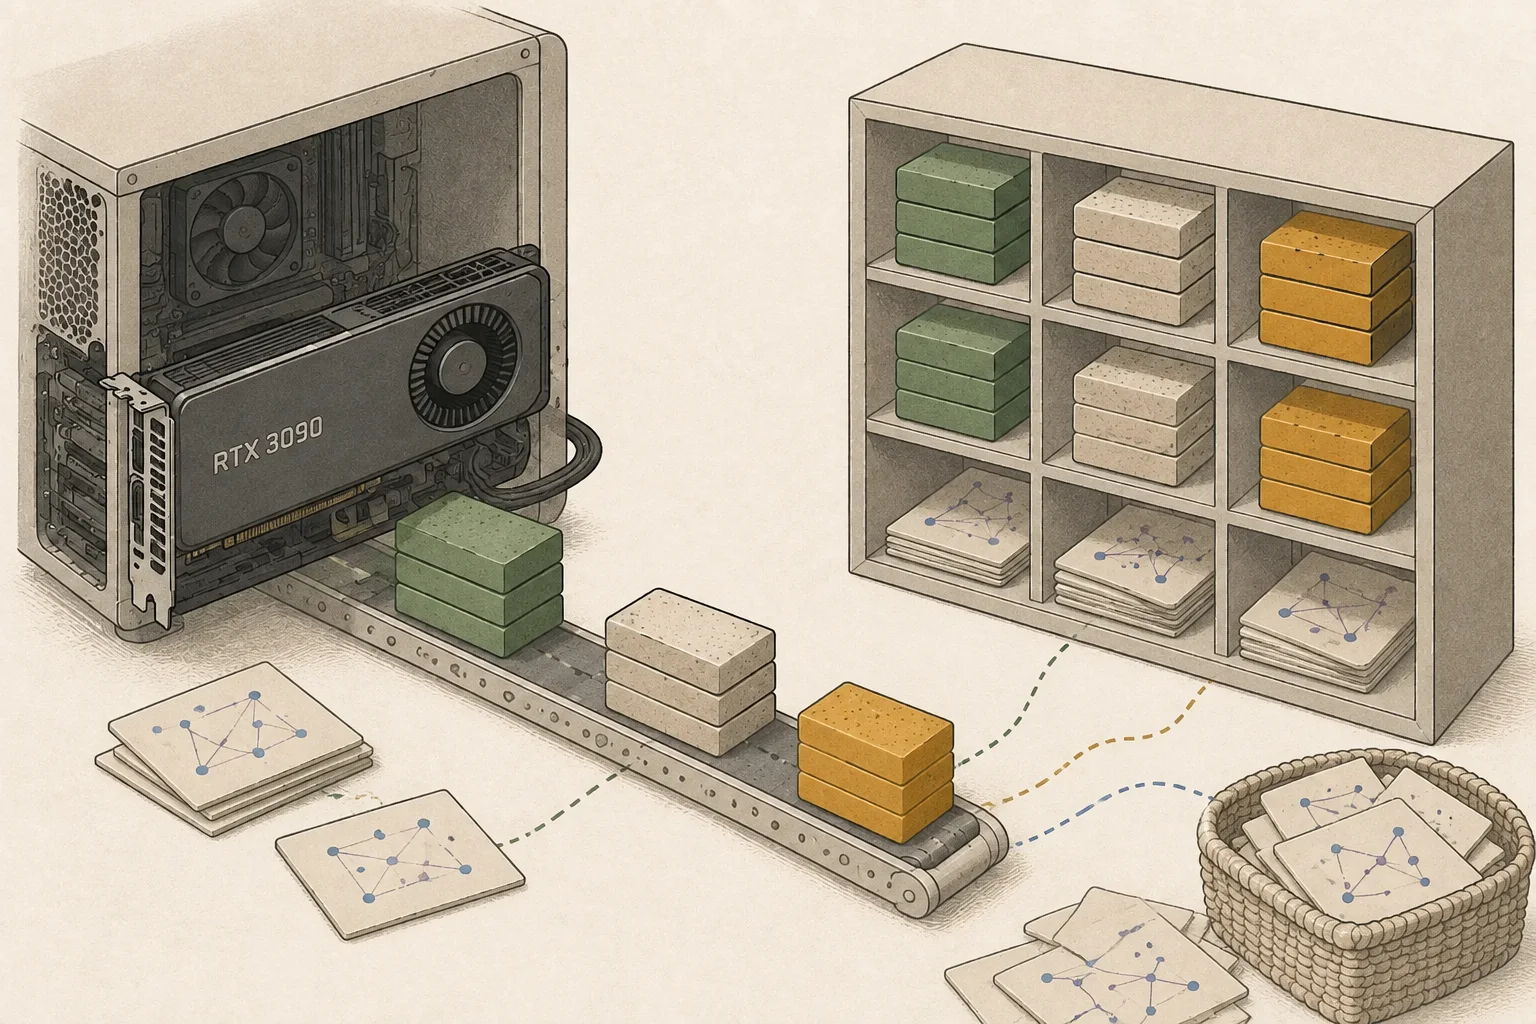
프리필은 연산 병목이라 달라질 수 있어요
동시 요청과 배치에서 차이가 커져요
여러 요청을 동시에 처리하면 같은 가중치를 여러 번 재사용해 대역폭 부담이 줄고, 연산 비중이 커져요. 이때는 BF16 처리량이 전체 처리량을 좌우할 수 있습니다. vLLM처럼 연속 배칭을 쓰는 서버에서 언락의 효과가 더 크게 나타날 수 있는 이유예요.
반대로 한 사람이 한 번에 한 요청만 보내는 환경에서는 배치가 만들어지지 않아 이 이점이 거의 없어요. 서버 운영자인지, 개인 PC 사용자인지에 따라 기대치가 달라집니다.
파인튜닝과 이미지 생성은 별도로 봐요
LoRA 파인튜닝은 BF16 행렬 곱을 많이 쓰기 때문에 언락의 이득이 이론적으로 가장 큰 작업이에요. 하지만 3090의 24GB VRAM10이 배치 크기11와 시퀀스 길이를 제한해서, 연산률보다 메모리가 먼저 걸립니다. 큰 배치를 돌리는 사람일수록 효과를 볼 여지가 있어요.
이미지 생성은 모델·해상도·스텝 수에 따라 연산과 메모리 비중이 달라져요. FP1612 행렬 곱이 많은 구간에서는 도움이 될 수 있지만, 고해상도에서는 VRAM과 대역폭이 먼저 걸립니다. 이미지 생성의 전후 차이는 모델·해상도·스텝 수 조합마다 달라지므로, 쓰는 설정에서 그대로 재는 편이 빠릅니다.
측정은 전력을 고정하고 전후를 비교해요
먼저 같은 모델·양자화·문맥 길이·전력 상한에서 기준선을 재세요. 그다음 언락 후 콜드 부팅으로 같은 조건을 반복합니다. 디코드13만 재면 차이가 거의 보이지 않으니, 프리필 시간과 동시 요청 처리량을 함께 기록해야 해요.
| 작업 | 병목 | 기대 |
|---|---|---|
| 한 요청 디코드 | 메모리 대역폭 | 거의 없음 |
| 긴 문서 프리필 | 행렬 연산 | 런타임 커널에 따라 다름 |
| 동시 요청 | 행렬 연산 | 배치가 클수록 큼 |
| LoRA 파인튜닝 | 행렬 연산, VRAM | VRAM이 먼저 걸림 |
그래서 사야 하나
언락은 이미 가진 3090의 연산 여유를 확인하는 실험이에요. 새로 카드를 사는 이유로는 약하고, 디코드가 목적이라면 5090이나 48GB 개조처럼 다른 선택지를 봐야 합니다. 3090의 강점은 24GB 용량과 가격이지 연산률이 아니에요.
판단은 측정에서 나와요. 같은 카드에서 전후를 재고 나서 결정하세요.
용어 각주
BF16 — 모델 수치를 저장하고 계산하는 16비트 부동소수점 형식입니다. FP32와 같은 폭의 지수부를 써 넓은 값 범위를 표현합니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기메모리 대역폭 — 메모리와 프로세서 사이에서 단위 시간에 전송할 수 있는 데이터 양입니다. 보통 초당 바이트(B/s)로 나타냅니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기LoRA — 기본 모델의 동작을 조정하는 작은 추가 가중치를 학습·적용하는 방식입니다. 기본 모델에 어댑터를 함께 적용하며, 스타일 조정이나 적은 단계의 생성 등에 쓰입니다.
본문으로 돌아가기MTP — 한 번에 여러 미래 토큰을 예측하도록 학습하는 목표 또는 이를 수행하는 모델 구성입니다. 추측 디코딩에서는 이 예측을 후보 토큰으로 제안할 수 있습니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기양자화 — 모델의 가중치나 계산값을 더 적은 비트로 표현해 저장 공간과 메모리 사용량을 줄이는 방법입니다. 표현 단계가 거칠어져 정확도에도 영향을 줄 수 있습니다.
본문으로 돌아가기VRAM — 그래픽카드의 GPU가 사용하는 메모리입니다. 모델 가중치와 계산 중간값을 저장합니다.
본문으로 돌아가기배치 크기 — 한 번의 처리 묶음에 함께 넣는 입력 또는 요청의 수입니다.
본문으로 돌아가기FP16 — 16비트 부동소수점 수치 형식입니다. BF16과 비트 수는 같지만 지수부와 유효숫자 배분이 다릅니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- RTX 3090의 BF16 언락은 행렬 연산 처리량을 올리지만, 한 요청의 토큰 생성은 메모리 대역폭에 묶여 있어요. 긴 문서를 한 번에 읽는 프리필, 여러 요청을 묶는 배치, LoRA 파인튜닝은 연산 비중이 커서 영향이 나타날 수 있어요. 다만 3090 자체의 공개 측정값이 아직 없어서, 기대치를 정하고 직접 재는 것이 먼저예요.
- 필요한 메모리는 어느 정도인가요?
- 토큰을 하나씩 만들 때 모델은 매 단계마다 가중치를 메모리에서 읽어요. RTX 3090의 936GB/s 대역폭은 이 읽기를 기다리는 시간을 정하지, BF16 행렬 연산 유닛의 처리량이 속도를 정하지 않습니다. 그래서 언락으로 연산률이 올라도 한 요청의 tok/s는 거의 그대로예요.