
実行プログラムと拡張機能
最終更新
3090アンロックでローカルLLMは速くなる?プリフィル・バッチ・デコード
1リクエストのデコードより、プリフィル・同時リクエスト・ファインチューニングで差が出る可能性があります。
RTX 3090のBF161アンロックは行列演算の処理量を上げますが、1リクエストのトークン2生成はメモリ帯域に縛られます。長い文書を一度に読むプリフィル3、複数リクエストをまとめるバッチ、LoRA4ファインチューニングは演算比率が高く、影響が出る可能性があります。ただし3090自体の公開測定値はまだないため、期待値を決めて自分で測るのが先です。
デコードは演算ではなく帯域がボトルネックです
1トークンずつ生成するとき、モデルは各段階で重みをメモリから読みます。RTX 3090の936GB/sがこの読み出し待ちを決め、BF16行列演算ユニットの処理量が速度を決めるわけではありません。演算率が上がっても1リクエストのtok/sはほとんど変わりません。
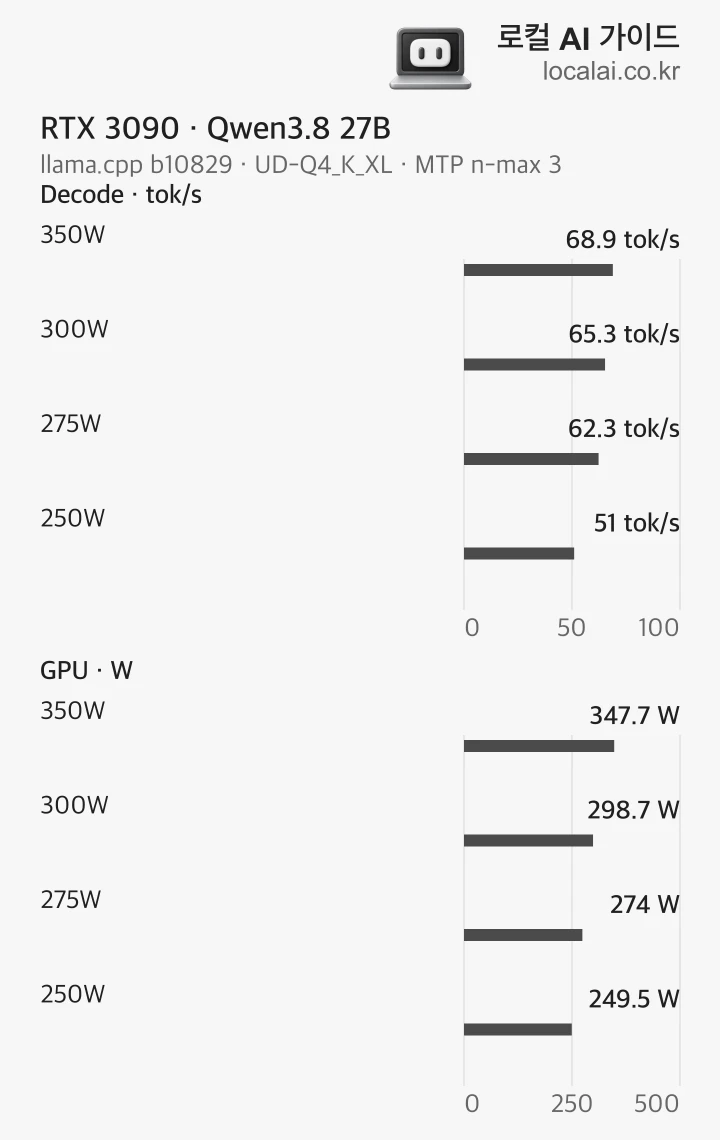
当サイトで公開した3090の測定も同じ方向です。Qwen3.8 27B UD-Q4_K_XL、MTP5 n-max 3の条件で、350W時に68.9 tok/s、250W時に51.0 tok/sでした。電力上限を下げると遅くなりますが、これは演算ではなくクロックと電力の問題です。
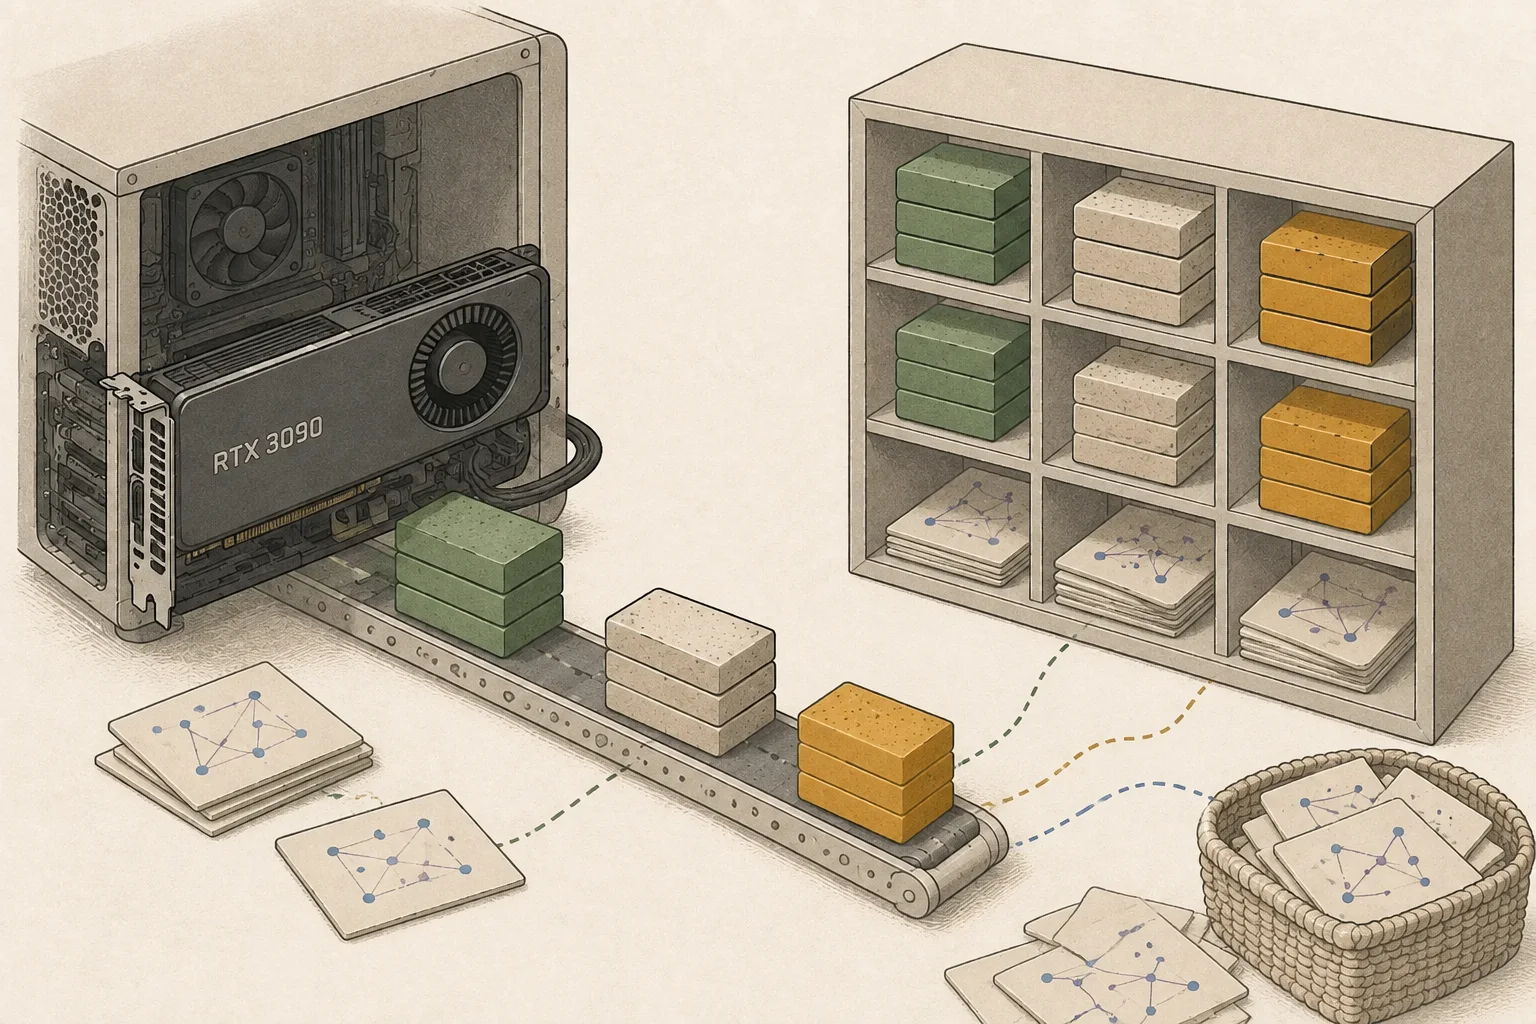
プリフィルは演算ボトルネックで変わる可能性があります
同時リクエストとバッチで差が広がります
複数リクエストを同時に処理すると同じ重みを再利用でき、帯域負担が減って演算比率が上がります。そのときはBF16処理量が全体の処理量を左右し得ます。連続バッチングを使うvLLMのようなサーバーでアンロックの効果が大きく出る理由です。
逆に1人が1件ずつしか送らない環境ではバッチが形成されず、この利点はほとんどありません。サーバー運用者か個人PC利用者かで期待値が変わります。
ファインチューニングと画像生成は別に見ます
電力固定で前後を比較して測ります
同じモデル・量子化・文脈長11・電力上限で基準線を測り、アンロック後にコールドブートで同じ条件を繰り返します。デコード12だけでは差がほとんど見えないため、プリフィル時間と同時リクエスト処理量も記録します。
| 作業 | ボトルネック | 期待 |
|---|---|---|
| 1リクエストのデコード | メモリ帯域 | ほぼなし |
| 長文プリフィル | 行列演算 | ランタイムのカーネル次第 |
| 同時リクエスト数 | 行列演算 | バッチが大きいほど大きい |
| LoRAファインチューニング | 行列演算、VRAM | VRAMが先に制約 |
それで買うべきか
アンロックはすでに持っている3090の演算余裕を確認する実験です。新しく買う理由としては弱く、デコードが目的なら5090や48GB改造など別の選択肢を見るべきです。3090の強みは24GBの容量と価格で、演算率ではありません。
判断は測定から出ます。同じカードで前後を測ってから決めてください。
用語の注釈
BF16 — モデルの数値に使う16ビット浮動小数点形式です。指数部はFP32と同じ幅で、同程度に広い値の範囲を表せます。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るLoRA — 基本モデルの動作を調整する小さな追加の重みを学習・適用する方法です。基本モデルとアダプターを組み合わせ、画風の調整や少ないステップでの生成などに使います。
本文に戻るMTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るバッチサイズ — 1回の処理単位にまとめる入力またはリクエストの数です。
本文に戻るFP16 — 16ビット浮動小数点形式です。BF16とビット幅は同じですが、指数部と仮数部の配分が異なります。
本文に戻るコンテキスト長 — 1回のリクエストでモデルが扱える入力と生成内容のトークン範囲です。上限や実際のメモリ使用量はモデルと実行設定によります。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- RTX 3090のBF16アンロックは行列演算の処理量を上げますが、1リクエストのトークン生成はメモリ帯域に縛られます。長い文書を一度に読むプリフィル、複数リクエストをまとめるバッチ、LoRAファインチューニングは演算比率が高く、影響が出る可能性があります。ただし3090自体の公開測定値はまだないため、期待値を決めて自分で測るのが先です。
- 必要なメモリはどのくらいですか?
- 1トークンずつ生成するとき、モデルは各段階で重みをメモリから読みます。RTX 3090の936GB/sがこの読み出し待ちを決め、BF16行列演算ユニットの処理量が速度を決めるわけではありません。演算率が上がっても1リクエストのtok/sはほとんど変わりません。