
実行プログラムと拡張機能
最終更新
RTX 3090 48GB改造:受け取る前に確認すること
改造で増えるのは容量で、936GB/sの帯域幅とデコード速度はそのままです。
48GB改造はメモリチップを実際に交換する作業で、ドライバーが49152MiBと報告するかが最初の関門です。起動と画面出力ができても、大容量の割り当てや長時間負荷で失敗することがあるため、受け取る前に決められた検査を実行し、レポートを残す必要があります。帯域幅は24GBモデルと同じでトークン1生成は速くなりませんが、大きなモデルを1枚に載せられる点が利点です。
48GB改造はメモリチップの交換作業です
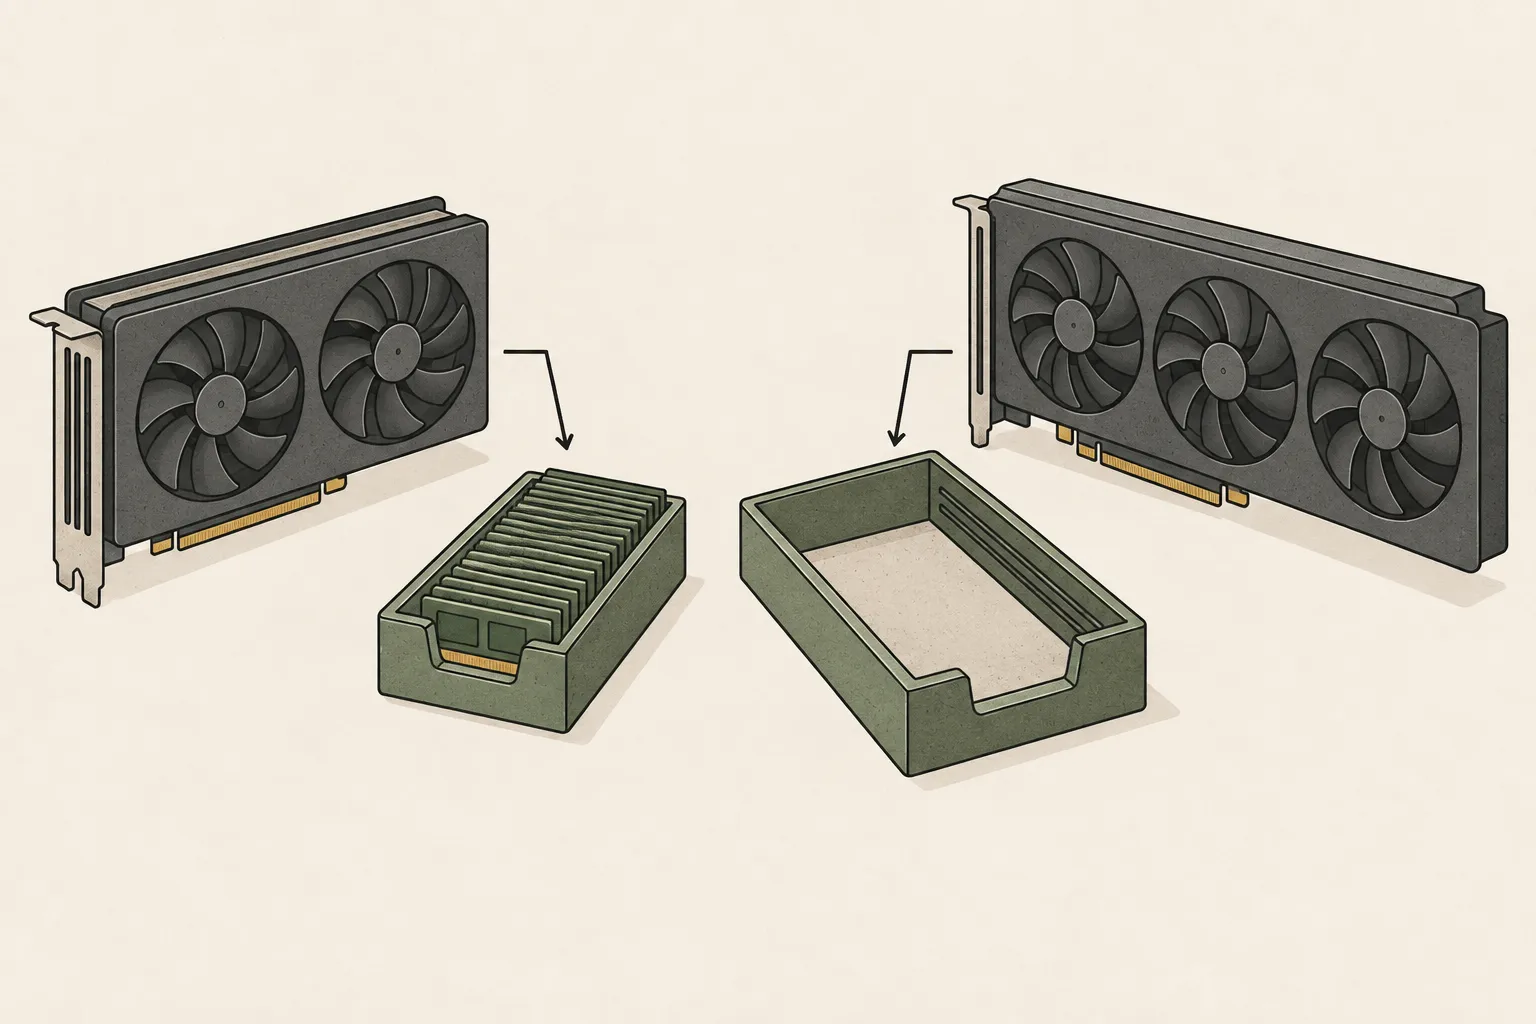
起動成功は合格の証拠ではありません
受け取り前の検査項目
ツールは、GPU7名に3090が含まれるか、VRAMが約49152MiBと報告されるか、PyTorch CUDAが同じサイズを見るか、演算能力が3090相当の8.6か、既定設定で目標メモリの92%まで書き込めるかを確認します。PCIeリンク、VBIOS、ドライバー、電力、温度、使用率も記録します。
OSログの確認も項目です。LinuxではNVIDIA・Xid・PCIeのカーネルエラーを、WindowsではNVIDIA・Display・WHEA・PCIeのシステムイベントを確認します。ログを読む権限がなく確認できなかった項目は通過扱いにせず、人による再確認に回します。
| 検査項目 | 基準 |
|---|---|
| GPU名 | 3090を含む |
| VRAM | 約49152MiB |
| 演算能力 | 8.6 |
| メモリ書き込み | 既定92%、ストレス95% |
| OSログ | NVIDIA・Xid・WHEA・PCIeエラーなし |
検査の実行と判定
作業場では短い検査を先に実行し、受け取り用にはストレスを長めに取ります。ツールは--stress-seconds 1800 --vram-fraction 0.95のように時間と割り当て比率を指定でき、--expected-memory-mib 49152 --memory-tolerance-mib 1024で期待容量と許容誤差を変更できます。レポートはreports/にMarkdownとJSONで残ります。
判定は三つです。失敗も警告もなければACCEPT、強い失敗はないが人が確認すべき項目があればREVIEW、必須検査が一つでも失敗すればREJECTです。REJECTは受け取らず、REVIEWはPCIe警告・温度・権限の問題を確認してから決めます。
chmod +x install.sh gpu-validator.sh
./install.sh
./gpu-validator.sh --quick
./gpu-validator.sh --stress-seconds 1800 --vram-fraction 0.95
# 재부팅 후 같은 카드에서 다시 확인
./gpu-validator.sh --quick
容量は増え、速度はそのままです
改造の利点は一つです。24GBに収まらなかったモデルを1枚に載せられます。24GBを2枚でテンソル並列8にする方法と違い、カード間通信が不要で、分割による同期コストもありません。代わりに電力と発熱は1枚に集中します。
速度を期待すると裏切られます。当サイトで公開した3090の測定でも、デコードは350Wで68.9 tok/s、250Wで51.0 tok/sと電力上限に従い、メモリ容量が速度を変えることはありませんでした。改造カードも同じ帯域幅の上にあります。
改造カードに残るリスク
改造カードはメーカー保証の対象外です。ドライバーやカーネルを更新した後にメモリ報告が変わる例もあり、その場合は同じ検査をやり直す必要があります。販売者の保証文言が「正常動作」ではなく「49152MiBの報告とストレス通過」のように検査結果を示しているか確認してください。
中古で売るときも同じレポートが必要です。検査記録を残せば、引き取り手と販売者の双方が同じ条件を確認できます。売る前にも同じ検査を回しておけば、条件をそのまま示せます。
用語の注釈
トークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るPyTorch — AIモデルを作成・実行するソフトウェアフレームワークです。モデルと合わせて、対応するPyTorchの版やハードウェアも確認します。
本文に戻るメモリ帯域幅 — メモリとプロセッサー間で単位時間に転送できるデータ量です。通常はバイト毎秒(B/s)で表します。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るCUDA — NVIDIA GPUで汎用計算を行うソフトウェア基盤です。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るテンソル並列 — モデルの層内の行列や演算を複数の装置に分割して計算する方式です。部分結果をまとめるために装置間通信が必要です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- 48GB改造はメモリチップを実際に交換する作業で、ドライバーが49152MiBと報告するかが最初の関門です。起動と画面出力ができても、大容量の割り当てや長時間負荷で失敗することがあるため、受け取る前に決められた検査を実行し、レポートを残す必要があります。帯域幅は24GBモデルと同じでトークン生成は速くなりませんが、大きなモデルを1枚に載せられる点が利点です。
- 必要なメモリはどのくらいですか?
- 48GB改造はソフトウェア設定ではなく、カードのGDDR6Xチップを交換する物理作業です。成功するとドライバーがメモリ容量を`49152MiB`と報告し、PyTorchなどのフレームワークも同じサイズを認識します。カーネルモジュールで演算率を開くアンロックとは全く別の作業です。
- 選ばないほうがよいのはどのような場合ですか?
- 改造の利点は一つです。24GBに収まらなかったモデルを1枚に載せられます。24GBを2枚でテンソル並列にする方法と違い、カード間通信が不要で、分割による同期コストもありません。代わりに電力と発熱は1枚に集中します。