
実行プログラムと拡張機能
最終更新
2×3090のNVLink:推論で実際にどれだけ変わるか
推論ではNVLinkは約5%の差で、既定の構成はブリッジなしでも動作します。
RTX 3090はNVLink 3.0コネクターを備えていますが、ブリッジを実際に取り付ける必要があり、多くの消費者構成にはありません。2×3090のvLLMテンソル並列1のコミュニティ測定では、NVLinkが85.0対81.1 tok/sと約5%先行し、p95は239.1対277.6秒と安定していました。マルチGPU2の既定経路はPCIeで、P2Pは無効のまま動作します。
NVLinkブリッジがする仕事
RTX 3090はGA102ベースのNVLink 3.0に対応し、1組のカードが112.5Gbit/sのリンクを4本束ねて合計112.5GB/sの双方向(方向あたり56.25GB/s)で通信できます。PCIe 4.0 x16が方向あたり約32GB/sであるのと比べると、カード間の専用経路ははるかに広いです。
3090にNVLinkコネクターがあることと、ブリッジが装着されていることは別の話です。まとめ資料には「ブリッジを物理的に取り付ける必要があり、多くの消費者構成にはない」と書かれています。ブリッジがなければマルチカード構成はPCIeで動作します。
実測:TP=2でのNVLinkの有無
2×3090でvLLMのテンソル並列(TP=2)を使い、同じモデルを回したコミュニティ測定があります。Devstral Small 2505 Q8_0、コード生成プロンプト350件、応答平均約1650トークン4の条件で、NVLinkありが85.0 tok/s、PCIeのみが81.1 tok/sでした。差は約5%です。
より目立つのはテール遅延です。95パーセンタイルの応答時間はNVLinkありが239.1秒、なしが277.6秒で、NVLinkの方が安定していました。平均処理量より長いリクエストのばらつきが重要な用途なら、この差に意味があります。測定者は、推論だけが目的ならブリッジよりVRAM5やカードに使う方がよいと結論づけています。
| 構成 | 処理量 | p95応答 |
|---|---|---|
| NVLinkあり | 85.0 tok/s | 239.1秒 |
| PCIeのみ | 81.1 tok/s | 277.6秒 |
既定はPCIeでP2Pは無効です
2×3090の運用資料によると、既定のデュアル・マルチカード経路はPCIe専用でP2Pは無効です。NCCL_P2P_DISABLE=1でカスタムオールリデュースも無効になっており、調整なしでどの消費者構成でも安定して動く側を既定にしています。
同じ資料には、PCIeでもP2Pを有効にするとワークロード次第で数%から20%程度まで伸び得ると書かれています。強調されているのは順序です。まず既定のPCIe経路で正常動作を確認し、その後トポロジーを読み、P2Pを有効にして比較すると問題を切り分けやすくなります。
P2Pが有効かを確認する3層
P2Pは一つの問いではなく三つが重なっています。第一にドライバーがGPU間の直接アクセスを許可したか、第二にNCCL6がその経路を実際の転送に使うか、第三にvLLMのカスタムオールリデュースカーネルが追加で有効かです。これらを混同すると「P2Pは有効なのに速くならない」理由を説明できなくなります。
vLLM側のゲートはNVLinkという名前で検査しますが、その検査は高コストな条件をふるい落とすための事前フィルターです。そのため3枚以上のPCIe構成では、完全接続のNVLinkメッシュではないという理由でカスタムオールリデュースは設計上無効になります。設定ミスではなく意図された動作で、その構成でもP2Pの利得はNCCL層に流れ得ます。
| 層 | 確認方法 |
|---|---|
| ドライバー | nvidia-smi topo -p2p rwがOKか |
| NCCL | NCCL_P2P_LEVELの設定とドライバーの許可 |
| vLLMカスタムオールリデュース | 起動ログの無効通知を確認 |
TP=2を有効にする条件とコスト
vLLMのテンソル並列は重みをカード数で分割して載せる方式です。カードごとに確保できるKVキャッシュ7の空間が増える代わりに、同期のオーバーヘッドが大きくなり得るとvLLMのドキュメントは説明しています。文脈長8と同時リクエスト数を合わせて調整して初めて実際の利得が出ます。
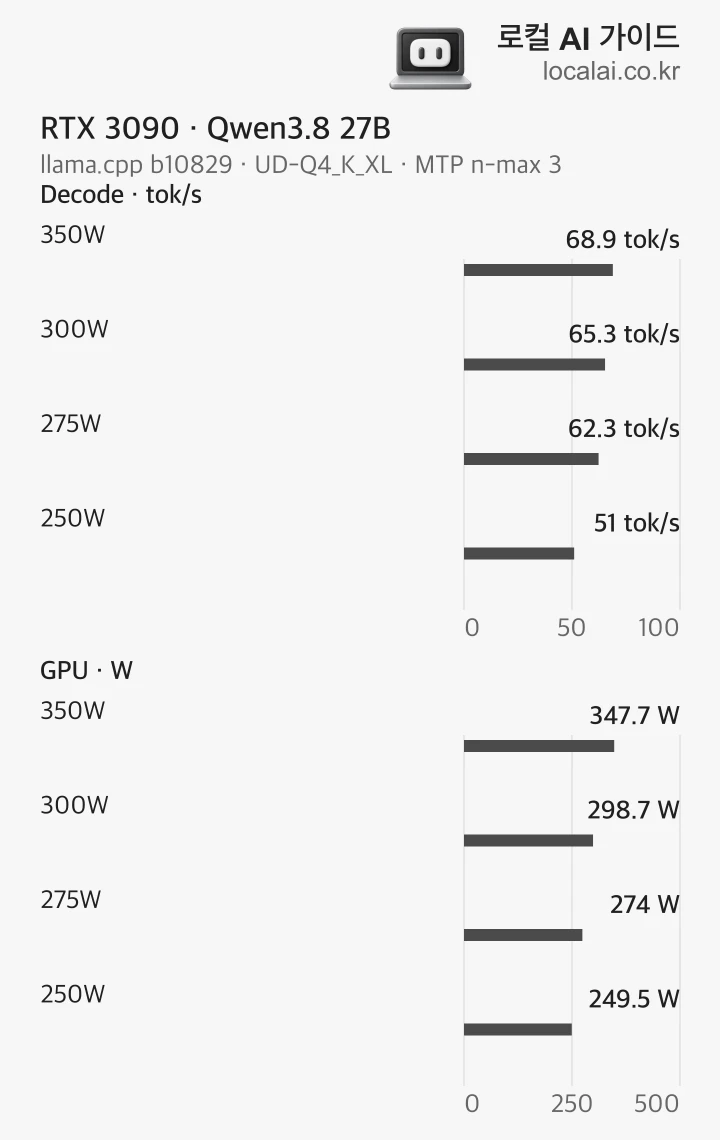
チャンクプリフィル9を有効にすると、演算ボトルネックのプリフィルと帯域ボトルネックのデコード10を分けて混ぜ、両方の資源を使えます。電力はカードごとにかかるため、2枚なら合計電力とケース内の発熱も見る必要があります。上のチャートのように、3090は電力上限を下げるとデコードも落ちます。
nvidia-smi topo -m
nvidia-smi topo -p2p rw

CUDA_VISIBLE_DEVICES=0,2 CUDA_DEVICE_ORDER=PCI_BUS_ID \
vllm serve /models/model.gguf \
  --tensor-parallel-size 2 \
  --max-num-seqs 4 --max-model-len 64000 \
  --gpu-memory-utilization 0.95 \
  --max-num-batched-tokens 16384 --enable-chunked-prefill \
--quantization ggufそれでブリッジを買うべきか
推論が目的なら、ブリッジは最後に検討する項目です。測定で得られたのは約5%の処理量とより良いテールで、それより大きな差は24GBを2枚に分けて載せられるモデルか、1枚でより大きなモデルを載せるかで生まれます。2枚使う場合はまず既定のPCIe経路で正常動作を確認してください。
学習やファインチューニングのようにカード間通信が動き続ける作業は話が別です。NVLinkの帯域の利点は推論より学習で大きく出るというのが一般的な評価で、上の測定も推論では差が5%にとどまったと結論づけています。用途が推論か学習かを先に決めてから判断してください。
用語の注釈
テンソル並列 — モデルの層内の行列や演算を複数の装置に分割して計算する方式です。部分結果をまとめるために装置間通信が必要です。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るNCCL — 複数のNVIDIA GPU間でデータの交換や集約を行う集団通信ライブラリです。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るコンテキスト長 — 1回のリクエストでモデルが扱える入力と生成内容のトークン範囲です。上限や実際のメモリ使用量はモデルと実行設定によります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- RTX 3090はNVLink 3.0コネクターを備えていますが、ブリッジを実際に取り付ける必要があり、多くの消費者構成にはありません。2×3090のvLLMテンソル並列のコミュニティ測定では、NVLinkが85.0対81.1 tok/sと約5%先行し、p95は239.1対277.6秒と安定していました。マルチGPUの既定経路はPCIeで、P2Pは無効のまま動作します。