
메모리와 모델
최종 업데이트
turbovec: RAG 인덱스가 먹는 램을 8분의 1로
벡터를 4비트로 압축해 검색해요
RAG1를 만들면 벡터가 램을 차지해요. turbovec은 그 벡터를 2비트나 4비트로 압축해 같은 머신에 더 많이 넣어요. 학습 단계가 없고 삭제가 빨라서 계속 바뀌는 인덱스에 맞고, 대신 그래프 인덱스는 아니에요.
벡터 인덱스도 램을 먹어요
메모리 계산부터 해봐요
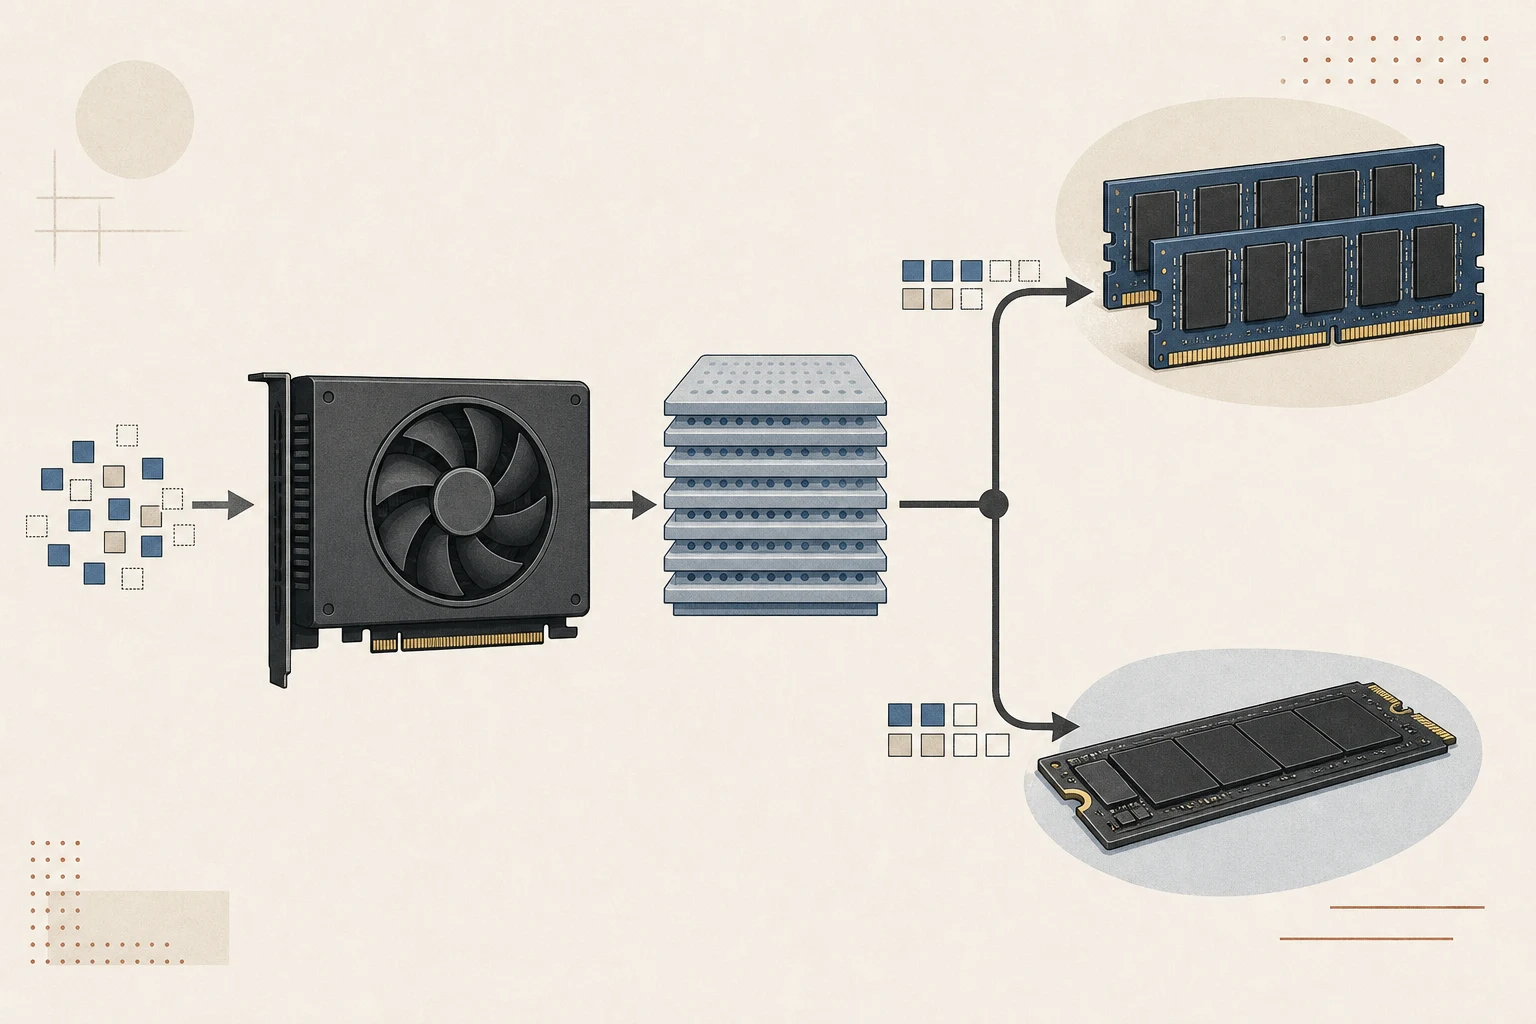
float32는 차원당 4바이트, 4비트는 0.5바이트, 2비트는 0.25바이트예요. 이론값으로는 8배와 16배가 되는데, README는 실제 측정값으로 7.8배와 15.5배를 적어요.
100K 벡터 1536차원 기준으로 float32가 586MB, 4비트가 75MB, 2비트가 38MB예요. 인덱스 크기를 이 비율로 미리 잡아 두면 램 부족을 피할 수 있어요.
좌우로 밀어 표 전체를 비교하세요.
| 저장 방식 | 차원당 바이트 | 100K·1536 | 원본 대비 |
|---|---|---|---|
| float32 | 4바이트 | 586MB | 1배 |
| 4비트 모드 | 0.5바이트 | 75MB | 7.8배 작음 |
| 2비트 모드 | 0.25바이트 | 38MB | 15.5배 작음 |
설치하고 인덱스를 만들어요
pip으로 설치하고 넘파이 배열을 그대로 넣어요. 넣은 벡터는 바로 검색되고, 따로 학습시키는 단계가 없어요.
입력은 2차원 float32여야 해요. 다른 타입은 조용히 바꾸지 않고 오류를 내서, 형 변환 실수를 일찍 잡아 줘요.
돌려주는 점수는 내적이에요. 코사인 유사도를 쓰려면 넣기 전에 벡터를 정규화해야 해요.
import numpy as np
from turbovec import TurboQuantIndex

vectors = np.load("embeddings.npy").astype(np.float32)  # (n, 1536)
index = TurboQuantIndex(dim=1536, bit_width=4)
index.add(vectors)

scores, slots = index.search(vectors[:1], k=5)
index.sync("index.tv")
속도와 정확도를 같이 봐요
4비트 검색은 FAISS보다 3.8~5.1배 빨라요. ARM에서 4.0배, x86에서 4.9배로, 두 환경 모두에서 앞서요.
정확도는 recall@1로 보면 4비트가 0.959와 0.981, FAISS가 0.966과 0.971이에요. 1536차원과 3072차원 결과예요.
2비트는 0.901과 0.931로 내려가요. 차원이 낮으면 더 떨어져서 GloVe 200차원은 0.572예요. 압축 폭을 정할 때 이 값을 봐야 해요.
좌우로 밀어 표 전체를 비교하세요.
| 측정 항목 | 4비트 모드 | 2비트 모드 | FAISS |
|---|---|---|---|
| 검색 속도 | 3.8~5.1배 | 1.8~2.5배 | 기준 |
| recall@1 (1536/3072) | 0.959 / 0.981 | 0.901 / 0.931 | 0.966 / 0.971 |
| recall@1 (GloVe 200) | 0.860 | 0.572 | 0.842 |
100K 임베딩, k=64, 1,000개 질의, 5회 중앙값, GCP c4a-standard-8(ARM)과 c3-standard-8(x86)에서 측정한 값이에요.
넣고 지우는 일이 잦으면 더 유리해요
학습 단계가 없어서 벡터를 넣는 즉시 검색돼요. 문서를 계속 수집하는 파이프라인에서도 다시 색인하지 않아도 돼요.
삭제는 마이크로초 단위예요. FAISS는 삭제할 때마다 코드를 다시 정리해서 0.19초에서 1.03초가 걸려요.
저장은 바뀐 부분만 써요. 인덱스가 커도 저장이 밀리초 단위로 끝나고, 중간에 끊겨도 마지막 저장 지점까지 살아 있어요.
검색에 필터를 넘길 수 있어요
허용된 id 목록을 같이 넘기면 그 안에서만 찾아요. 권한이나 시간 조건을 인덱스 밖에서 정하고 검색에 넘기는 구조예요.
id로 관리하려면 IdMapIndex를 써요. 슬롯 번호 대신 직접 정한 번호로 넣고 지워서, 다른 시스템의 키와 맞추기 쉬워요.
from turbovec import IdMapIndex

index = IdMapIndex(dim=1536, bit_width=4)
index.add_with_ids(vectors, ids)

allowed = np.array([1001, 1003, 1042], dtype=np.uint64)
scores, ids = index.search(query, k=10, allowlist=allowed)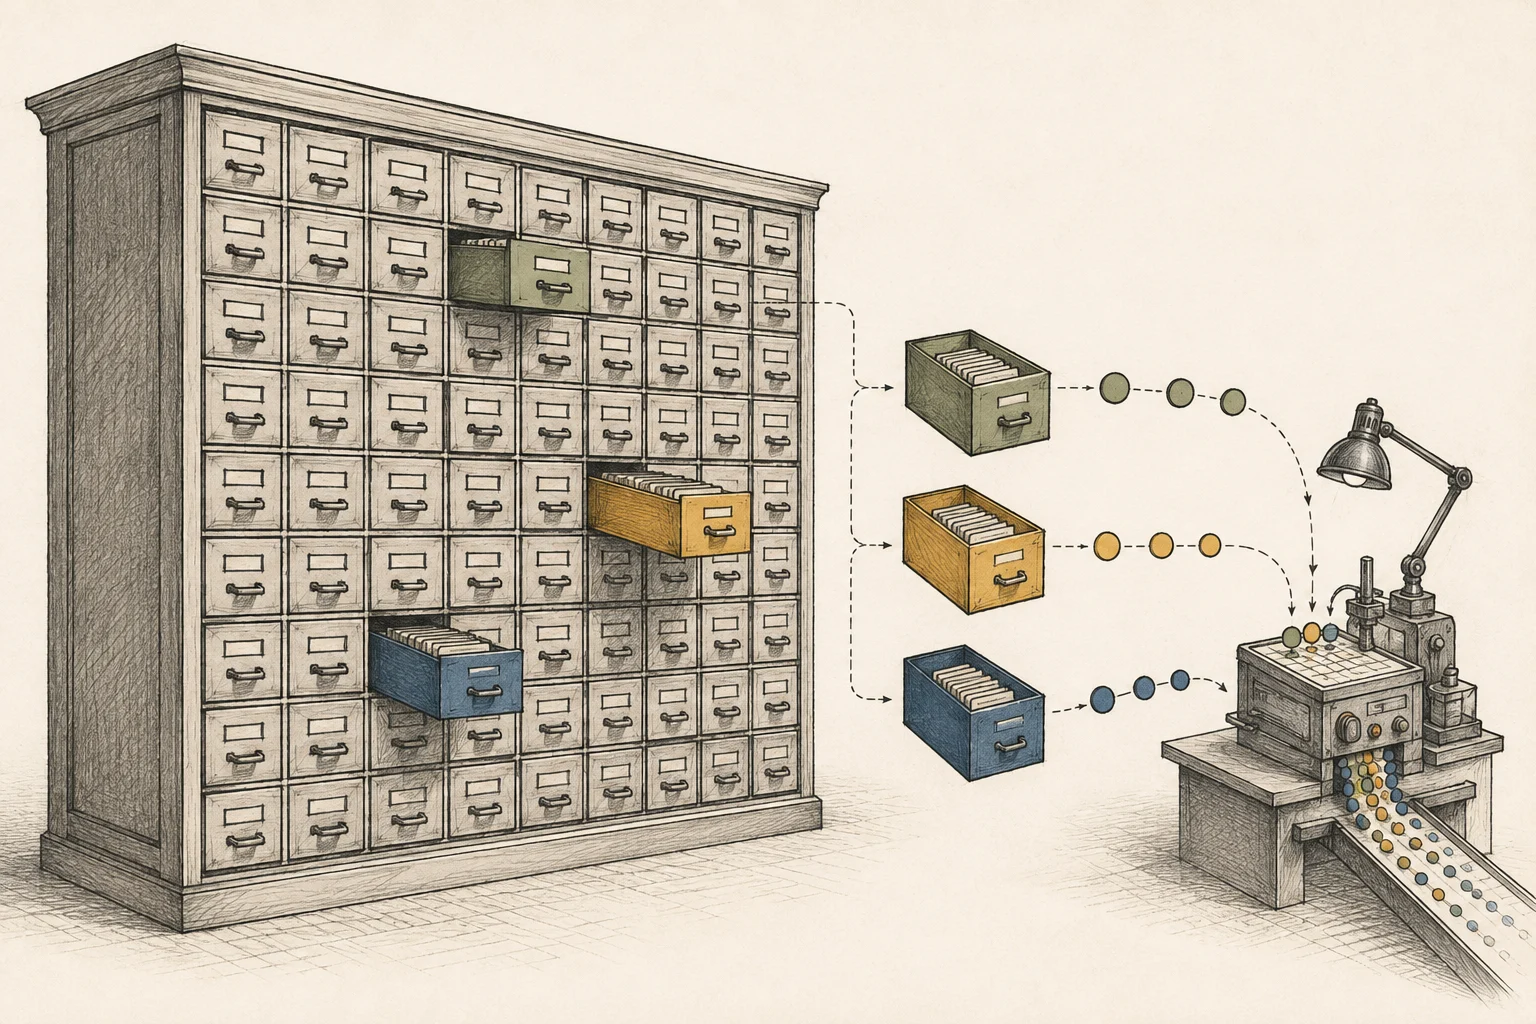
RAG 스택에 그대로 끼워요
LangChain, LlamaIndex, Haystack, Agno용 저장소가 따로 있어요. 각 프레임워크의 메모리 저장소와 같은 인터페이스라 교체하듯 붙어요.
임베딩 모델을 로컬에서 돌리면 인덱스까지 전부 오프라인으로 돌아요. turbovec 자체는 프로세스 밖으로 나가지 않아요.
언제 쓰면 안 되는지
그래프 인덱스가 필요한 작업에는 권장하지 않아요. turbovec은 모든 벡터를 훑어서 코퍼스가 커지면 비용이 선형으로 늘어요. 100K에서 8코어 기준 0.13~0.25ms이고, 수억 개 뒤에서 엄격한 지연을 요구하는 자리에는 HNSW나 IVF가 맞아요.
정확한 float 결과가 필요해도 안 돼요. 양자화4는 손실이 있어서 4비트에서 상위 1개가 정답과 96~98% 일치해요. 자기 데이터 일부로 리콜을 확인하는 편이 안전해요.
서버가 필요해도 안 돼요. 네트워크 API5나 복제, 멀티테넌시는 없고, 그런 기능이 있는 스택에 끼워 넣는 부품이에요.
차원은 8의 배수여야 하고 16,384를 넘으면 안 돼요. 비트 폭은 2와 4만 지원해요.
용어 각주
검색 증강 생성 — 질문과 관련된 자료를 검색해 모델 입력에 추가한 뒤, 그 문맥을 바탕으로 답변을 생성하는 방식입니다.
본문으로 돌아가기FP32 — 32비트 부동소수점 수치 형식입니다. BF16보다 값 하나에 더 많은 메모리를 쓰며 수치를 더 세밀하게 표현할 수 있습니다.
본문으로 돌아가기파이프라인 — 입력부터 결과까지 이어지는 처리 단계의 묶음입니다. 각 단계에서 서로 다른 모델이나 도구를 사용할 수 있습니다.
본문으로 돌아가기양자화 — 모델의 가중치나 계산값을 더 적은 비트로 표현해 저장 공간과 메모리 사용량을 줄이는 방법입니다. 표현 단계가 거칠어져 정확도에도 영향을 줄 수 있습니다.
본문으로 돌아가기API — 프로그램의 기능을 다른 코드에서 호출하기 위한 약속된 인터페이스입니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- RAG를 만들면 벡터가 램을 차지해요. turbovec은 그 벡터를 2비트나 4비트로 압축해 같은 머신에 더 많이 넣어요. 학습 단계가 없고 삭제가 빨라서 계속 바뀌는 인덱스에 맞고, 대신 그래프 인덱스는 아니에요.
- 선택하지 않는 편이 좋은 경우는 언제인가요?
- 그래프 인덱스가 필요한 작업에는 권장하지 않아요. turbovec은 모든 벡터를 훑어서 코퍼스가 커지면 비용이 선형으로 늘어요. 100K에서 8코어 기준 0.13~0.25ms이고, 수억 개 뒤에서 엄격한 지연을 요구하는 자리에는 HNSW나 IVF가 맞아요.