
メモリとモデル
最終更新
turbovec:RAGインデックスのメモリを8分の1に
ベクトルを4ビットに圧縮して検索します
RAG1ではベクトルがメモリを占めます。turbovecは2ビットか4ビットに圧縮して同じマシンに多く載せます。学習段階がなく削除も速いため更新の多いインデックスに向きますが、グラフインデックスではありません。
ベクトルインデックスもメモリを食べます
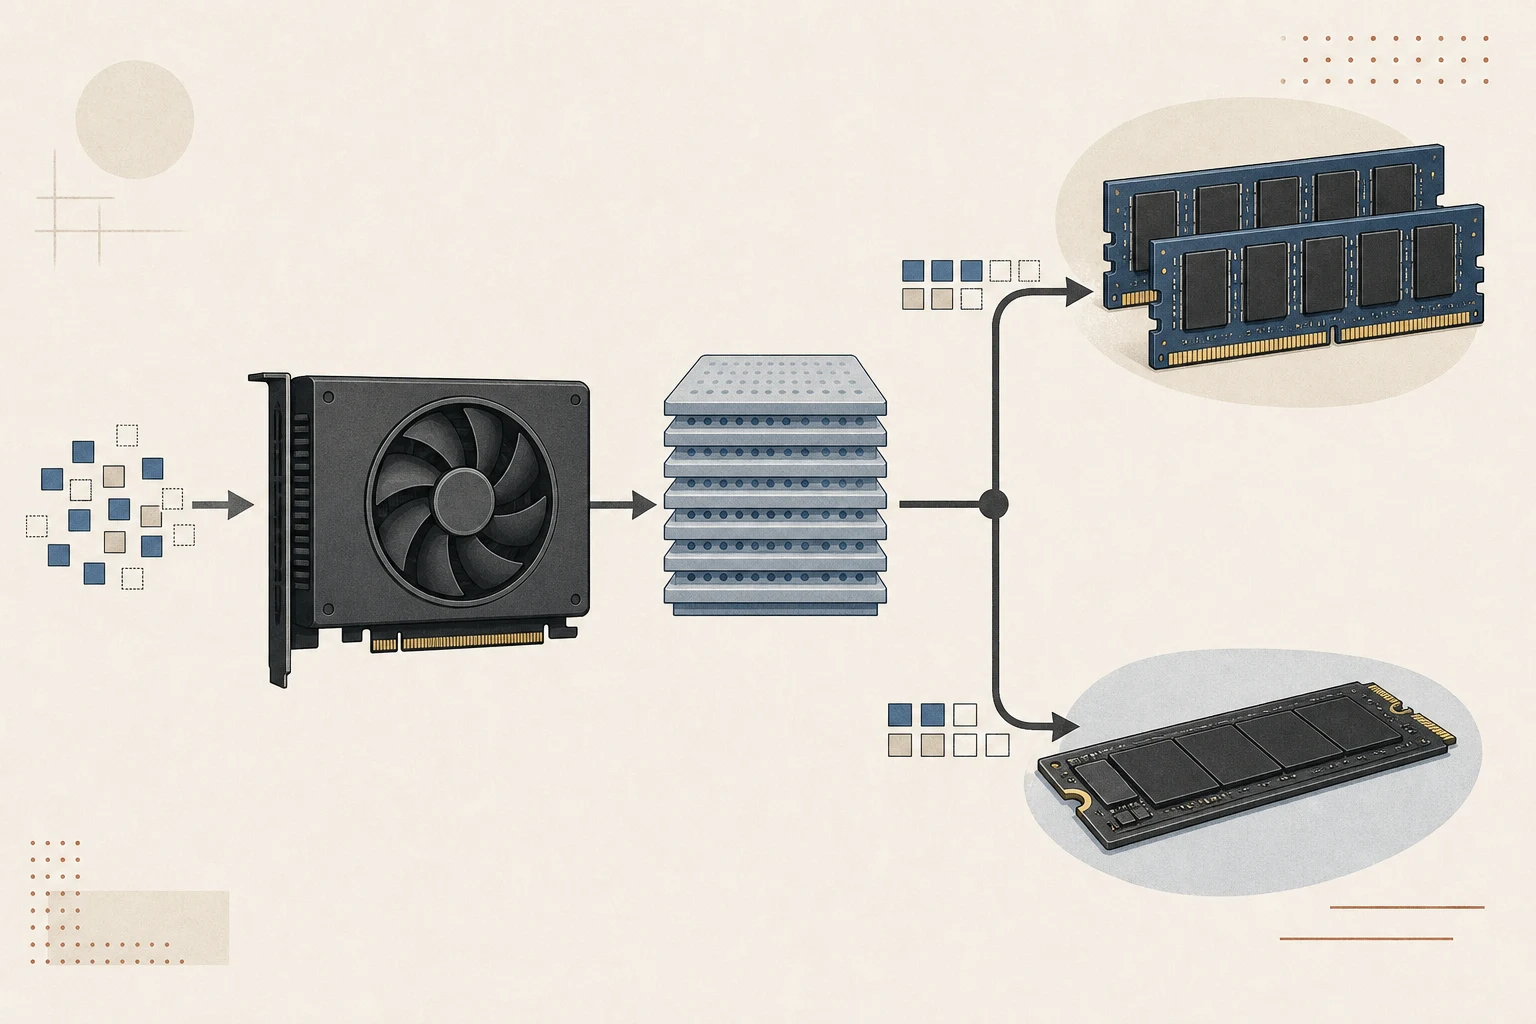
まずメモリの計算をします
float32は次元あたり4バイト、4ビットは0.5、2ビットは0.25なので計算上は8倍と16倍です。READMEは実測で7.8倍と15.5倍と書いています。
10万件・1536次元でfloat32が586MB、4ビットが75MB、2ビットが38MBです。この比率で見積もればメモリ不足を避けられます。
左右にスクロールして各項目を比較できます。
| 方式 | 次元あたり | 100K·1536 | float32比 |
|---|---|---|---|
| float32 | 4バイト | 586MB | 1倍 |
| 4ビットモード | 0.5バイト | 75MB | 7.8倍小さい |
| 2ビットモード | 0.25バイト | 38MB | 15.5倍小さい |
導入してインデックスを作ります
pipで導入し、NumPy配列をそのまま渡します。入れたベクトルはすぐ検索でき、学習の段階はありません。
入力は2次元float32である必要があります。他の型は黙って変換せずエラーになるため、変換ミスを早く見つけられます。
返るスコアは内積です。コサイン類似度を使うなら入れる前に正規化します。
import numpy as np
from turbovec import TurboQuantIndex

vectors = np.load("embeddings.npy").astype(np.float32)  # (n, 1536)
index = TurboQuantIndex(dim=1536, bit_width=4)
index.add(vectors)

scores, slots = index.search(vectors[:1], k=5)
index.sync("index.tv")
速度と精度を一緒に見ます
4ビット検索はFAISSより3.8〜5.1倍速いです。ARMで4.0倍、x86で4.9倍と両方で上回ります。
recall@1は4ビットが0.959と0.981、FAISSが0.966と0.971です。1536次元と3072次元の結果です。
2ビットは0.901と0.931に下がります。次元が低いとさらに落ち、GloVe 200次元は0.572です。幅を決めるときはこの値を見ます。
左右にスクロールして各項目を比較できます。
| 測定項目 | 4ビットモード | 2ビットモード | FAISS |
|---|---|---|---|
| 検索速度 | 3.8〜5.1倍 | 1.8〜2.5倍 | 基準 |
| recall@1 (1536/3072) | 0.959 / 0.981 | 0.901 / 0.931 | 0.966 / 0.971 |
| recall@1 (GloVe 200) | 0.860 | 0.572 | 0.842 |
10万件の埋め込み、k=64、1000クエリ、5回の中央値をGCP c4a-standard-8(ARM)とc3-standard-8(x86)で測定した値です。
追加と削除が多いほど有利です
学習段階が無いため、入れたベクトルは即座に検索できます。文書を集め続けるパイプラインでも再インデックスは不要です。
削除はマイクロ秒単位です。FAISSは削除のたびにコードを整理するため0.19〜1.03秒かかります。
保存は変わった部分だけを書きます。インデックスが大きくてもミリ秒で終わり、途中で切れても最後の保存地点までは残ります。
検索にフィルタを渡せます
許可したid一覧を渡すとその中だけを探します。権限や時間条件をインデックスの外で決めて検索に渡す形です。
idで管理するならIdMapIndexを使います。スロット番号ではなく自分で決めた番号で出し入れするため、他システムのキーと合わせやすいです。
from turbovec import IdMapIndex

index = IdMapIndex(dim=1536, bit_width=4)
index.add_with_ids(vectors, ids)

allowed = np.array([1001, 1003, 1042], dtype=np.uint64)
scores, ids = index.search(query, k=10, allowlist=allowed)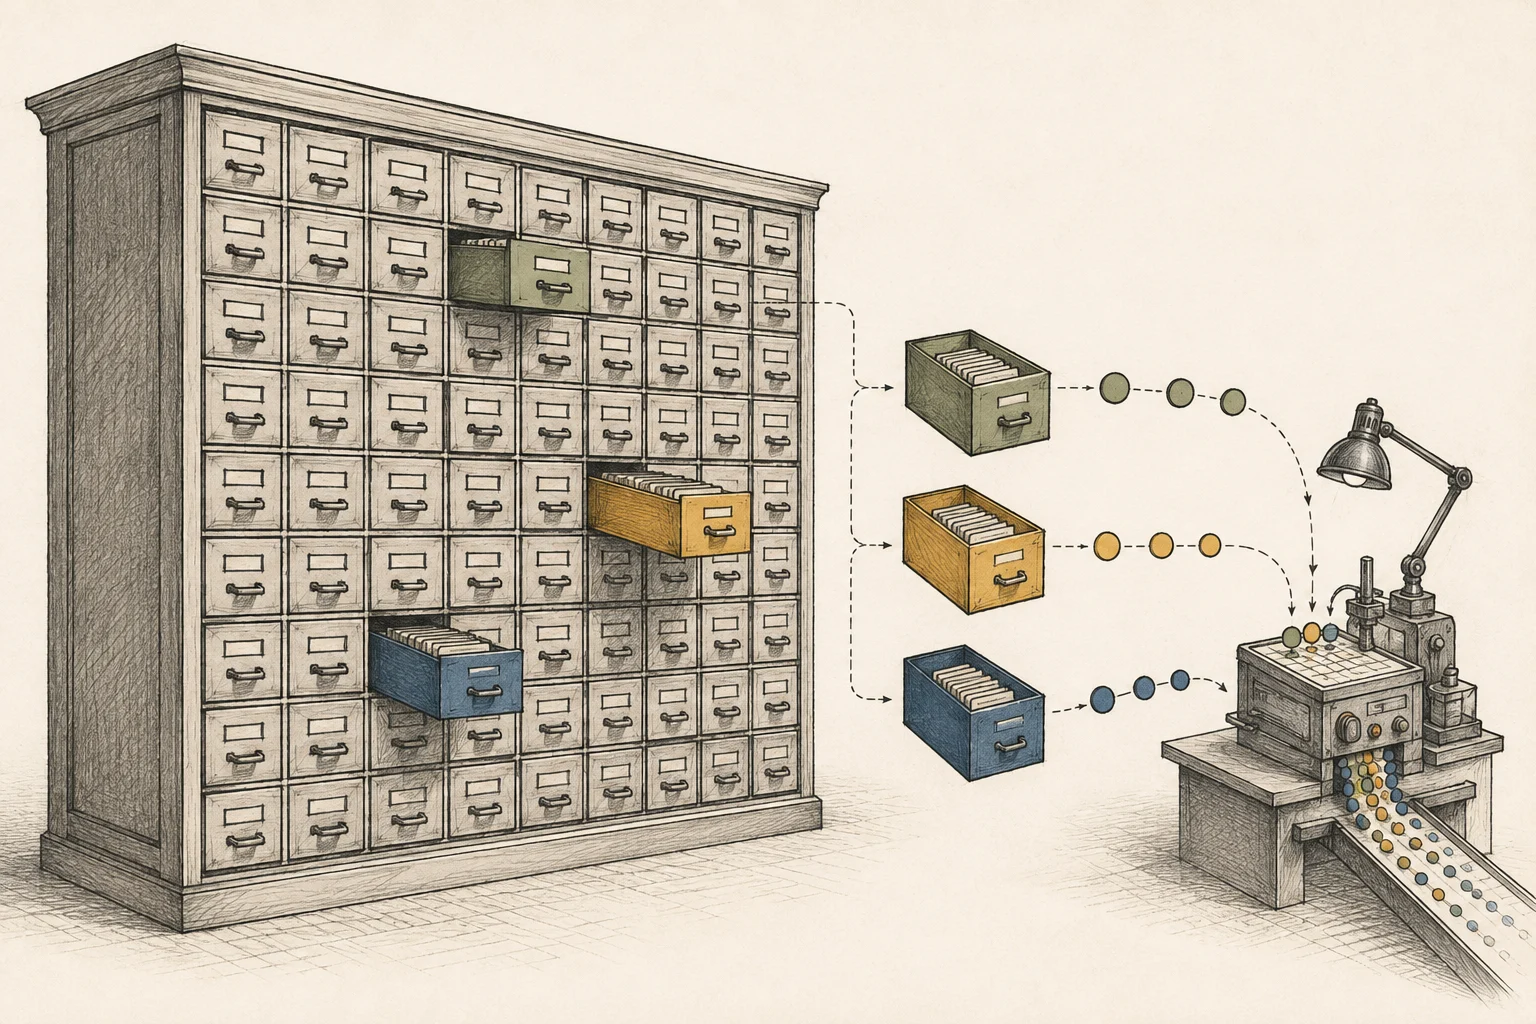
RAGスタックにそのまま入ります
LangChain、LlamaIndex、Haystack、Agno向けのストアがあり、各フレームワークのメモリ内ストアと同じインターフェースなので差し替えるように入ります。
埋め込みモデルをローカルで動かせばインデックスまで全てオフラインで動きます。turbovec自体はプロセスの外に出ません。
使わない方がよい場合
用語の注釈
検索拡張生成 — 質問に関連する資料を検索してモデル入力に加え、その文脈をもとに回答を生成する方式です。
本文に戻るFP32 — 32ビット浮動小数点形式です。BF16より値あたりのメモリを多く使い、数値をより細かく表現できます。
本文に戻るパイプライン — 入力から出力まで続く処理段階のまとまりです。段階ごとに異なるモデルやツールを使うことがあります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- RAGではベクトルがメモリを占めます。turbovecは2ビットか4ビットに圧縮して同じマシンに多く載せます。学習段階がなく削除も速いため更新の多いインデックスに向きますが、グラフインデックスではありません。
- 選ばないほうがよいのはどのような場合ですか?
- グラフインデックスが必要な用途には勧めません。全ベクトルを走査するため件数に比例して費用が増えます。10万件では8コアで0.13〜0.25msで、数億件の背後で厳しい遅延が要る場所にはHNSWやIVFが適します。