モデル別実行レシピ
Gemma 4 26B-A4B MTP:単一リクエストと複数リクエストで変わる速度
MTPの効果は、リクエスト数によって異なって見えます。
Gemma 4 26B-A4Bは総パラメータ25.2B、トークン1ごとの活性パラメータ約3.8BのMoE2モデルです。活性数は計算規模を示すもので、3.8B分の重みだけで動くという意味ではありません。MTP3では補助ドラフターが候補トークンを提案し、ターゲットモデルが検証します。単一リクエストと複数リクエストを分けて測定してください。
3.8Bが活性化するからといって3.8Bモデルではありません
長い設計書を読んで変更点を探す作業をGemma 4 26B-A4Bに任せると、モデル名とともに「活性パラメータ3.8B」という数字が目に入ります。この数字は、各トークンの計算で活性化される専門家の規模を示します。runtime4は約25.2Bの全重みにアクセスし、context用のKV cache5も確保する必要があります。活性数だけを見て約4GBのメモリで動くとは判断できません。
元のレシピでは、LM StudioなどのアプリでQ4のデスクトップ変換版を読み込み、context 8K、同時リクエスト1件で実行しました。これは比較用の基準であり、すべてのマシンに最適な設定ではありません。モデルファイルが収まっても、長い文書の処理にはOS、runtime、他のアプリ、KV cache用のメモリが必要です。まずtarget単体を読み込み、実際の文書に関する質問を1件完了できることを確認してから、assistantを追加します。
Googleが2026年5月に発表したGemma 4 MTP drafterは、この実行経路に追加する選択肢です。targetとdrafterは対応するGemmaの組み合わせである必要があり、assistant checkpoint6は小型の汎用Gemmaチャットモデルとは役割が異なります。アプリがassistant checkpointとMTPに対応していなければ、ファイルをダウンロードしただけでは高速化されません。
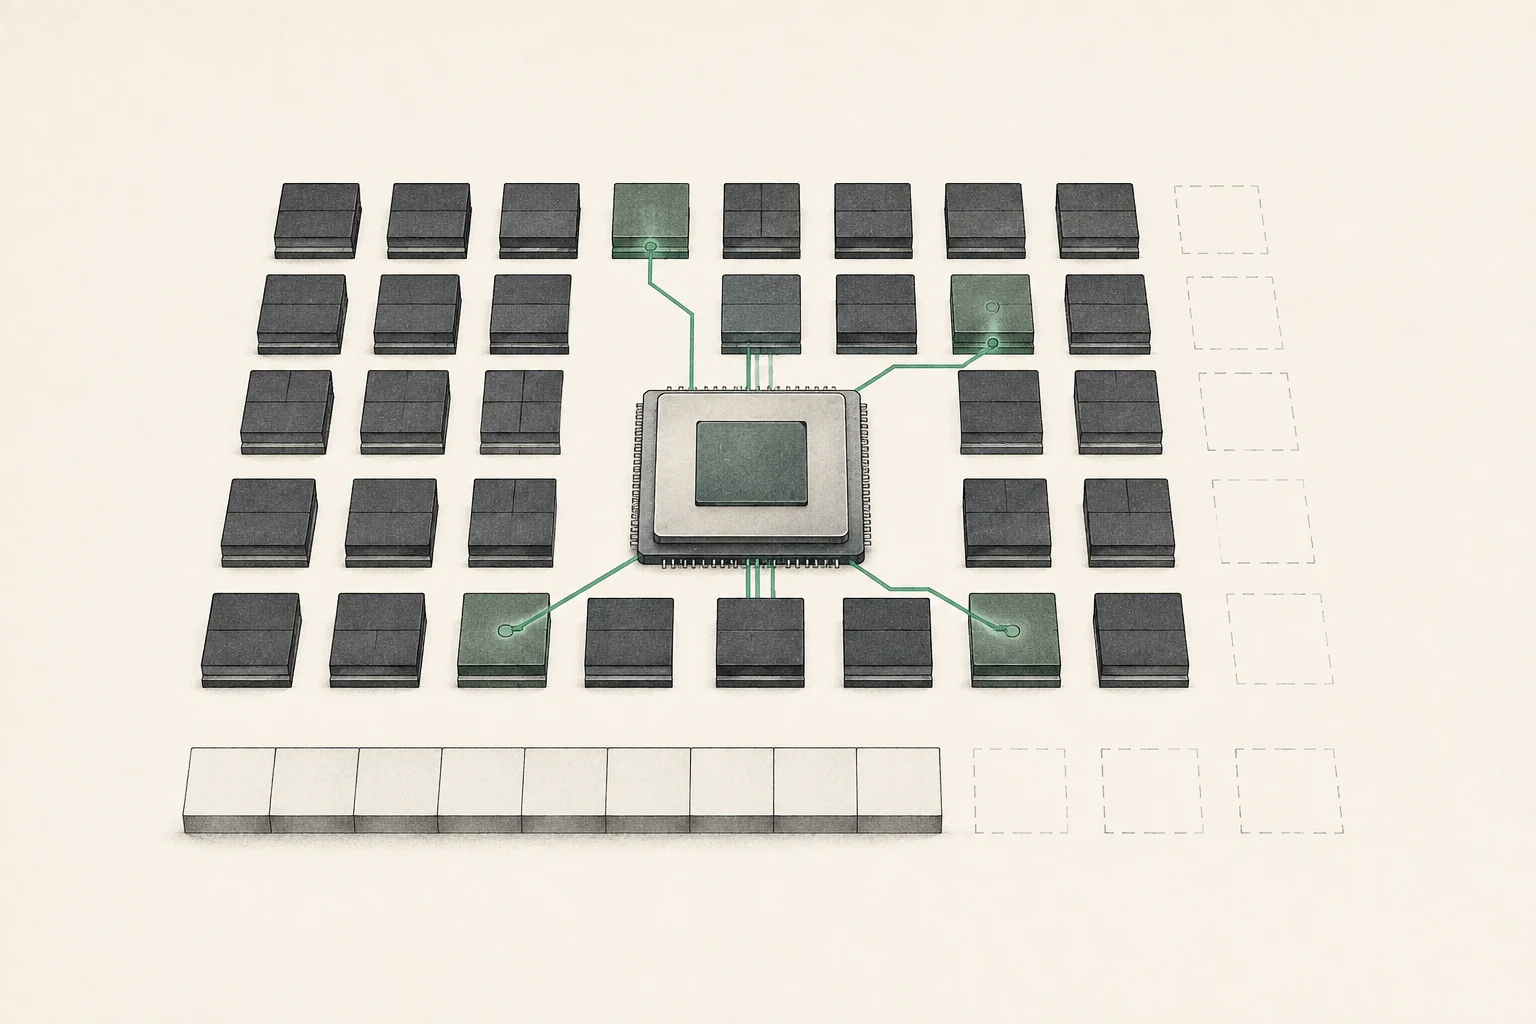
MTPは次のトークンを提案し、ターゲットが検証します
通常の生成では、target modelが次のトークンを1つずつ計算します。MTPでは4層のassistant drafterが後続トークンを提案し、targetがその候補を検証します。候補が一致すれば、targetの1回の処理で複数トークンを確定でき、decode7遅延を短縮できる可能性があります。候補が誤っていれば破棄し、targetのトークンから生成を続けます。検証なしにdrafterが答えを書き上げる方式ではありません。
短縮効果はタスクごとに異なります。多くの候補が採用されるdrafterなら効果が期待できますが、候補が頻繁に却下されるとdraft計算とメモリが増える一方、短縮幅は小さくなります。長い入力の処理(prefill8)が待ち時間の大半を占める場合、MTPが短縮するのはdecode部分だけなので、応答全体への影響は限られます。そのため、文書の読み込み時間と最初のトークン後の生成時間を分けて測定します。
単一リクエストの条件と複数リクエストを同時処理する条件は分けて比較してください。Googleは2026年5月の発表で、Apple Siliconのbatch 1ではrouting challengeがあり、batch 4~8では最大約2.2倍の改善を観測したと報告しています。これは発表された実験条件での結果であり、Macで1人が1件質問する場合や、別のアプリ・量子化9での保証ではありません。自分の環境を測る際はbatchサイズ、promptと出力token数、runtime、モデルファイルを記録します。
| 測定区間 | この区間で確認すること | 合わせて記録する条件 |
|---|---|---|
| モデル読み込み | targetとassistantをメモリに載せられるか | cold start、重みの精度、ピークメモリ |
| Prefill / TTFT | 設計書を読み、最初のtokenを出すまでの時間 | 入力token数、warm/cold prefix、context |
| Decode | 最初のtoken後、回答が続く速度 | 出力長、採用token数、temperature |
| リクエスト全体 | 開始から完了までの実時間 | batch、同時実行数、warmupと反復回数 |
MTPの効果を評価するときは、待ち時間の段階を分けて確認します。
モデル読み込み
- この区間で確認すること
- targetとassistantをメモリに載せられるか
- 合わせて記録する条件
- cold start、重みの精度、ピークメモリ
Prefill / TTFT
- この区間で確認すること
- 設計書を読み、最初のtokenを出すまでの時間
- 合わせて記録する条件
- 入力token数、warm/cold prefix、context
Decode
- この区間で確認すること
- 最初のtoken後、回答が続く速度
- 合わせて記録する条件
- 出力長、採用token数、temperature
リクエスト全体
- この区間で確認すること
- 開始から完了までの実時間
- 合わせて記録する条件
- batch、同時実行数、warmupと反復回数
MLX-VLMで単一リクエストの基準を作る
この実習ではApple Silicon上の`mlx10-vlm`を使い、同じBF1611 targetと対応するBF16 assistant drafterを比較します。両方のファイルを用意できるメモリが必要です。以前のLM Studio Q4基準との比較ではなく、MLX-VLM内で同じtargetにMTPを加えた場合の差を切り分けます。まず対応バージョンをインストールし、terminalでtarget単体の出力と応答を確認します。
初回実行にはモデルのダウンロードと読み込み時間が含まれる場合があります。完了ログが表示され、応答が生成されたら、同じpromptと256 token上限でtarget単体を3回実行します。その後drafterを追加し、同じ条件で繰り返します。コマンドに`--draft-kind mtp`があるだけでは、モデルの組み合わせが対応していることや実行成功の証明にはなりません。ログでdrafterの読み込みと生成統計を確認してください。
正常に動けば両方の実行で回答が得られ、MTPログにdraft acceptanceなどの情報が表示されるはずです。temperature 0でも出力が異なる場合、どちらも自然な回答に見えても差を隠さないでください。まずruntimeのversion、checkpoint、prompt template、ログを確認します。提供元の効率報告と、自分の環境での実測は分けて記録します。
python -m pip install -U mlx-vlm
mlx_vlm.generate --model mlx-community/gemma-4-26B-A4B-it-bf16 --prompt "Design note: The Northstar launch moves from May 12 to May 19. The API freeze remains May 5. Summarize the changed date and the unchanged milestone." --max-tokens 256 --temperature 0
mlx_vlm.generate --model mlx-community/gemma-4-26B-A4B-it-bf16 --draft-model mlx-community/gemma-4-26B-A4B-it-assistant-bf16 --draft-kind mtp --draft-block-size 6 --prompt "Design note: The Northstar launch moves from May 12 to May 19. The API freeze remains May 5. Summarize the changed date and the unchanged milestone." --max-tokens 256 --temperature 0
単一リクエストとbatchを分けて試す
target単体とMTPを、1回に1リクエストずつ実行します。同じ文書と出力上限を使い、warm状態で少なくとも3回リクエストします。初回のファイル読み込み時間を、別経路のwarm計測と混ぜないでください。中央値、回答の抜け、採用token数、ピークメモリを記録します。decodeのtoken/秒だけでは、長い入力のprefill差が見えないことがあります。
次に同じサーバーへ複数リクエストを同時に送ります。batchサイズを増やす際はprompt、出力長、リクエスト数のいずれかだけを変え、モデルファイルとdraft block sizeは固定します。目的が1人の応答性なら、同時リクエストの結果を主指標にしないでください。複数アプリが共有するサーバーでは、個々の遅延と総throughput12の両方を記録し、1件の待ち時間が長くなる問題も見落とさないようにします。
単一リクエストの遅延がほとんど変わらなくても、複数リクエストを処理するサーバーの総完了数は変わることがあります。逆にthroughputが上がっても、各リクエストの待ち時間は長くなる場合があります。対象のworkloadに合った指標を選び、結論は実際に試したリクエスト構成に限定してください。
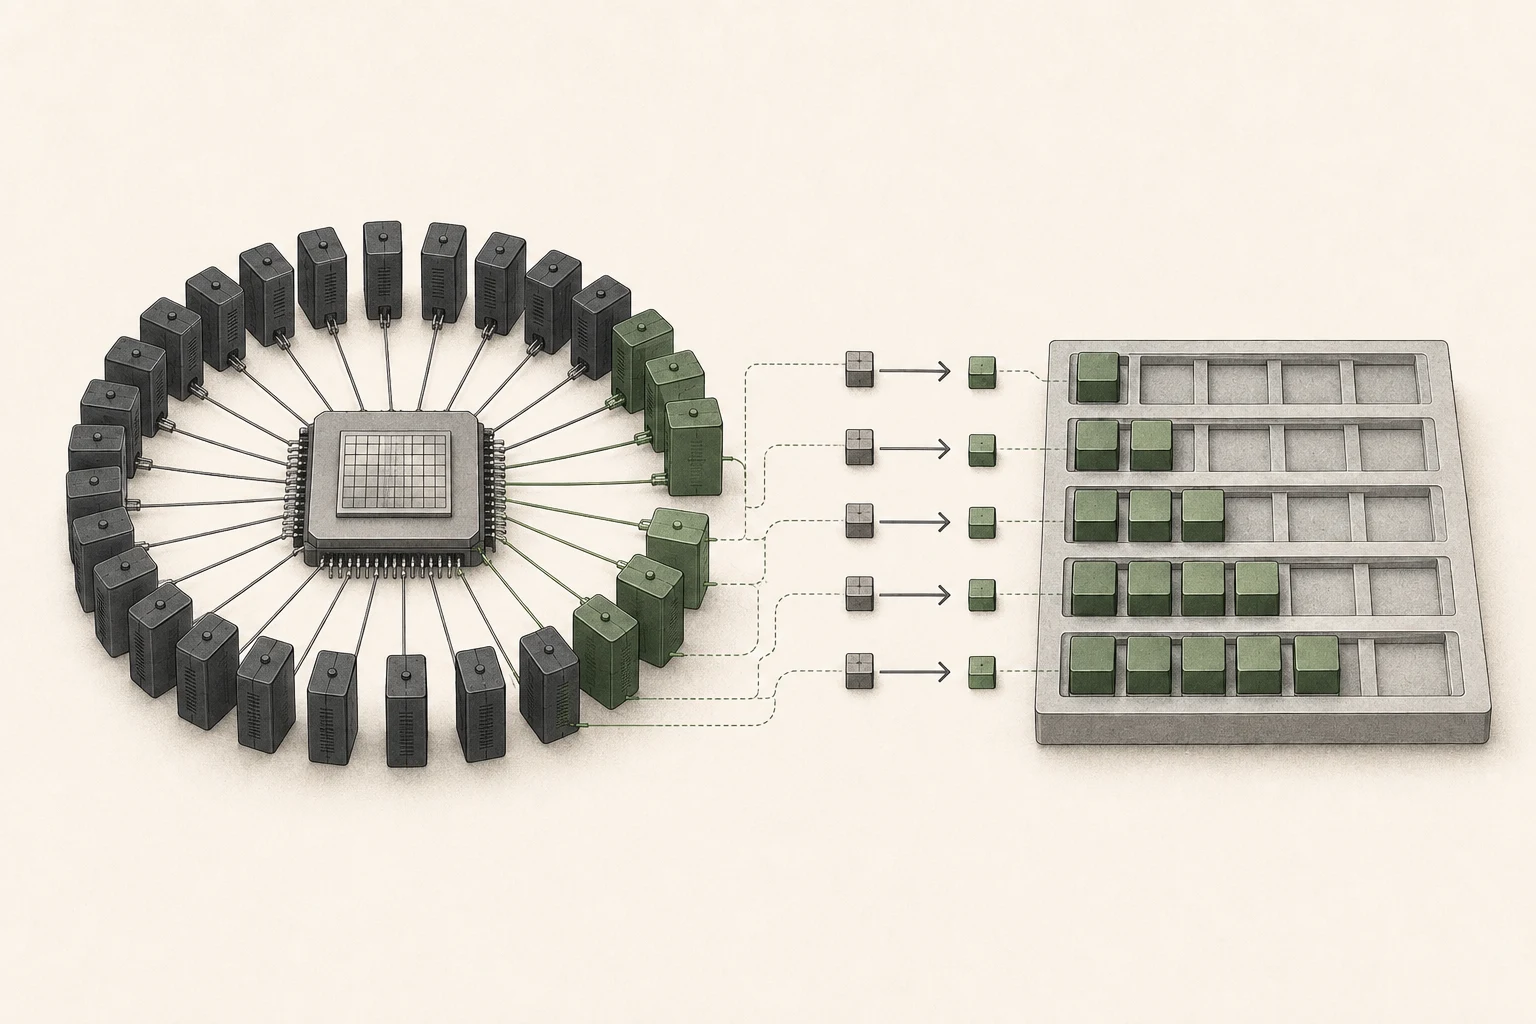
QATとMTPのどちらを先に試すか決める
Gemma 4のQATとMTPは異なる課題を解決します。QAT checkpointは重み表現を変えて圧縮効率を高め、必要なメモリを抑えます。MTPはassistantが候補を提案し、token生成の遅延を減らす方法です。QAT targetでMTPを使うには、両方に対応するtarget/drafterの組み合わせを確認してください。名前に「QAT」や「MTP」とあるだけで、任意の組み合わせが互換になるわけではありません。
target自体がマシンに読み込めない場合は、MTPを試す前に重みの精度と利用可能なメモリを見直します。targetが安定して動く一方、長い回答生成が主な待ち時間ならMTPを試す価値があります。長い入力のために最初のtokenが遅い場合は、入力処理とcacheを先に確認します。drafterの追加で応答が遅くなったりメモリが圧迫されたりするなら、そのworkloadではtarget単体が適しています。
選択する際は、26Bの全重みが文書やアプリと一緒に安定して収まるか、1人の利用か複数リクエストか、入力処理と回答生成のどちらがボトルネックかを順に確認します。MTPは必要な重みや検証計算をなくしません。target単体で十分に回答でき、同時利用者も1人なら現状の構成を維持できます。同じMacに複数リクエストが届き、batch 4~8で完了が速くなったなら、そのworkloadではMTPを使い続ける根拠になります。
公式発表と実行資料
MTPの仕組みとApple Siliconでのbatch結果は、Googleの2026年5月の発表に記載された条件に基づきます。実行例はMLX-VLMが公開するモデルの組み合わせとCLI13形式に従っています。本ガイドではデバイス別の新たな速度測定は行っていません。
用語の注釈
トークン — モデルが入力や出力を分けて処理する単位です。1トークンが1文字や一定の時間に相当するわけではありません。
本文に戻るMoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻るMTP — 複数の将来トークンを予測する学習方式またはモデル構成です。生成速度への効果は実装や実行条件によります。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあり、GPUランタイムライブラリと完成したサービングアプリは別の構成要素です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るデコード — LLMでは入力処理後に出力トークンを生成する段階です。VAEやオーディオコーデックでは、圧縮表現や符号化データから元の形式を復元する処理を指すことがあります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻る量子化 — モデルの数値を少ないビット数で表す方法です。メモリ使用量のほか、精度や実行速度も変わることがあり、影響は形式と実装によります。
本文に戻るMLX — Appleが開発する機械学習フレームワークです。Apple siliconでは統合メモリとMetalを活用し、別途Linux向けの実行経路も提供します。対応モデルや機能はMLXを使うツールごとに異なります。
本文に戻るBF16 — モデルの数値を保存・計算する16ビット浮動小数点形式です。利用可否はハードウェアと実行環境によります。
本文に戻るスループット — 一定時間に処理・生成した作業量です。トークン/秒やリクエスト/秒など、単位を合わせて比較します。
本文に戻るCLI — Command-Line Interfaceの略です。ターミナルにコマンドを入力してプログラムを操作する方式です。
本文に戻る
実行レシピ
機器別の設定
1人で使う場合
使う機器を選ぶと、起動コマンドと調整できる設定が表示されます。
プロファイル
Apple MacBook Pro M5 Pro (64GB)
メモリに収まる推奨ランタイム: LM Studio (MLX 4ビット(GGUF Q4_K_Mとは別形式)) · ドキュメントに基づくランタイム設定
インストール後の初回実行や、毎日安定して使いたいときに
プロファイルのコンテキスト長
16,384 トークン
ランタイムのドキュメントに基づく初期設定です。下の手順に沿って調整し、速度を比べてください。
デコード速度の推定値
26.9 ~ 65.4 tok/s
1人で使う場合の推定値
最初のトークンまでの推定時間
8.8 ~ 21.5秒
プリフィル: 765 ~ 1,861 tok/s
推定メモリ使用量
約 16.34GB / 56GB
残余の余裕:少ない 39.7GB
サーバーアドレス
http://127.0.0.1:1234
ローカルのみ · 127.0.0.1
推定値は、計算ツールが推奨する量子化・高速化設定と 16,384トークンを基準にしています。上記の実行設定を測定した値ではありません。
このプロファイルの設定
| 設定値 | この設定にする理由 |
|---|---|
| モデルの重みMLX 4ビット(GGUF Q4_K_Mとは別形式) | MLXモデルのディレクトリを使います。Q4_K_MのGGUFとはファイル形式が異なります。 |
| 入力長の確認16,384 | lms loadのcontext-length設定と、実際に読み込まれたコンテキスト長を合わせて確認します。 |
| KVキャッシュモデル設定で確認 | この起動コマンドではKVキャッシュの精度を指定していません。 |
| プリフィルのバッチサイズランタイム設定で確認 | llama.cppのbatch-sizeとubatch-sizeを、MLXの設定値としてそのまま使わないでください。 |
| 同時リクエスト数1 | 1件のリクエストの速度を測ります。複数リクエストを合わせた処理量とは分けて確認します。 |
| メモリの余裕2GB以上 | モデルの読み込み後に、実際のメモリ使用量とスワップの有無を確認します。 |
MBP M5 Pro 64GB 実行コマンド(LM Studio)
# lms ls에서 확인한 MLX 4비트 모델 식별자를 입력
MODEL_ID=""
lms ls
: "${MODEL_ID:?MLX 모델 식별자를 입력하세요}"
lms load "$MODEL_ID" --gpu=max --context-length=16384
lms server start --port 1234起動後の確認
- 01起動ログで、モデルの読み込み完了と実際のコンテキスト長を確認します。
- 02ウォームアップ後はリクエストを1件ずつ送ります。同じ長さの異なる入力を3つ使い、キャッシュを再利用しない初回の処理時間を記録します。
- 03同じ入力を繰り返した結果は、キャッシュ再利用の記録として分けます。初回入力の結果と混ぜないでください。
- 04プリフィルtok/s、デコードtok/s、ピークメモリをまとめて記録し、その後は一項目ずつ変更します。
変わる点と注意点
- コンテキスト長と同時リクエスト数を控えめにしているため、機器の最大処理量より低い結果になることがあります。
1つずつ調整
高速化の手順
複数の値を一括で変更すると原因を特定するのが難しいです。
- STEP 1
基準値を保存
初回入力とキャッシュ再利用を分け、それぞれ3回記録します。プリフィル、デコード、ピークメモリを一緒に比較します。
とき: エラーがある場合やメモリの余裕が2GB未満の場合は、次の段階へ進まないでください。
- STEP 2
プリフィルのチャンクサイズを調整
1,024 → 2,048 → 4,096の順に増やし、長い入力のTTFTとピークメモリを比べます。
とき: TTFTが短くならない場合やピークメモリが急増する場合は、直前の値へ戻します。
- STEP 3
KVキャッシュ調整
コンテキスト長を確保したいときだけ、同じ質問でQ8キャッシュとF16/BF16の基準値を比較します。
とき: 出力に差が出る場合や、必要なコンテキスト長をすでに確保できている場合は、標準の精度を維持します。
- STEP 4
MTP・投機的デコーディング
対応モデルだけで有効にし、コードと通常の文章を分けて、採用率と実際のデコードtok/sを測定します。
とき: 3回の中央値が基準値より良くならなければ、無効に戻します。
- STEP 5
コンテキスト拡張
実際に必要な長さまで段階的に2倍ずつ伸ばし、入力途中の情報を見つけられるかと、スワップの有無を確認します。
とき: 情報を探す精度が落ちたり、スワップ・メモリ圧縮が始まったりしたら、一段階短くします。
自分の機器の測定記録を送る
同じ条件で3回以上測定したJSONを読み込んでください。送信ボタンを押すまでは、このブラウザ内でのみ確認します。
受け付けるのは機器・モデル・実行条件と測定値だけです。プロンプト・回答・元のログ・ファイルパスは含めないでください。
記録ファイルがなければ、起動中のローカルサーバーと測定ツールで作成できます。Node.js 20以上が必要です。結果の自動送信は行いません。
内容を確認したユーザーの投稿記録です。このサイトが直接測定した結果とは区別しています。
設定の問題を報告
この設定でどこにつまずいたかを教えてください。報告を読めるのは管理者だけです。
報告する設定 · MBP M5 Pro 64GB · Gemma 4 26B-A4B (MoE) · バランス
変更履歴
サイトの説明を変更した記録です。インストール済みのエンジンやモデルのバージョンを自動で確認した結果ではありません。
Macのモデル形式と実行設定を訂正
MacのMLX実行経路をGGUF Q4_K_Mと区別し、エンジン名・モデル形式・コマンドの表記を揃えました。コマンドで指定していないKVキャッシュ精度とプリフィルのバッチ設定は、モデル・ランタイム設定で確認する案内に変更しました。
コマンドは同じなのにバッチだけが大きくなるように見えていたMLX速度プロファイルも削除しました。
初回入力とキャッシュ再利用の記録を分離
検証手順を変更し、初めて読む入力と同じ入力を繰り返した結果を別々に記録するようにしました。キャッシュの効果を初回プリフィル処理量や機器の差に含めません。
機器・プロファイルの保存と再表示を追加
実行可能なプロファイルを機器の選択と一緒にこのブラウザに最大5件保存し、ガイド一覧から再び開けるようにしました。保存後に公開設定が変わったりプロファイルの提供が終了したりした場合は、実行前の再確認を案内します。
実行エンジンの説明へのリンクを追加
設定に表示されるエンジン名から、該当する実行プログラムの説明へ移動できるようにしました。エンジンを特定できない経路に、推測で別のプログラムをリンクすることはありません。