
まず読み込み
最終更新
録音を外部に送らず韓国語で文字起こしする:whisper.cppの始め方
whisper.cppで韓国語の録音をローカル文字起こしします
whisper.cppは録音ファイルを入力として音声をテキストに変換するプログラムです。韓国語には英語専用の.enモデルではなく多言語モデルを選び、パソコン上で処理して、文字起こしを録音と照合し名前・数値・日付を確認します。まずファイル1件を最後まで処理し、繰り返す作業で処理時間と確認時間を測ってから機器の必要性を判断できます。
会議後に担当者や日付を探すため録音を最初から聞き直す代わりに、文字起こしで単語を検索して該当箇所へ戻れます。文字起こしは録音を置き換える要約ではなく、聞き直す場所を探す索引として扱うのが適切です。「金曜日」を検索しても曜日を聞き違えていることがあり、「見積もり」が見つかっても数値と単位は音声で確認する必要があります。
たとえば、毎週の韓国語会議から「ヘソル案は金曜日までに共有します」「見積もりの数値は再確認します」といった発言を探す場面を想像します。これは文字起こしと確認手順を説明するための例です。ファイル準備、音声処理、重要な表現を録音と照合する時間を記録すれば、繰り返す価値があるか判断できます。
韓国語音声に合う多言語モデルを選びます
baseとbase.enのように似た名前のファイルでも、対応言語が異なる場合があります。.en付きは英語専用なので、韓国語を含む会議にはbase、small、mediumなどの多言語モデルを使います。まず普段の録音から5分を切り出し、smallで試します。「ヘソル」「金曜日」「見積もりの数値」などを基準語にすると、一般的な文だけでは見落としやすい名前や日付の認識も確認できます。
この短い区間は候補を絞るテストであり、長い会議全体の精度を保証するものではありません。固有名詞を繰り返し誤るなら、同じ音声と基準語を使いmediumのような大型多言語モデルと比較します。大型モデルは保存容量や実行メモリも多く必要になる場合があるため、誤りが特定の会社名に限られるか、人が確認できるかも判断します。
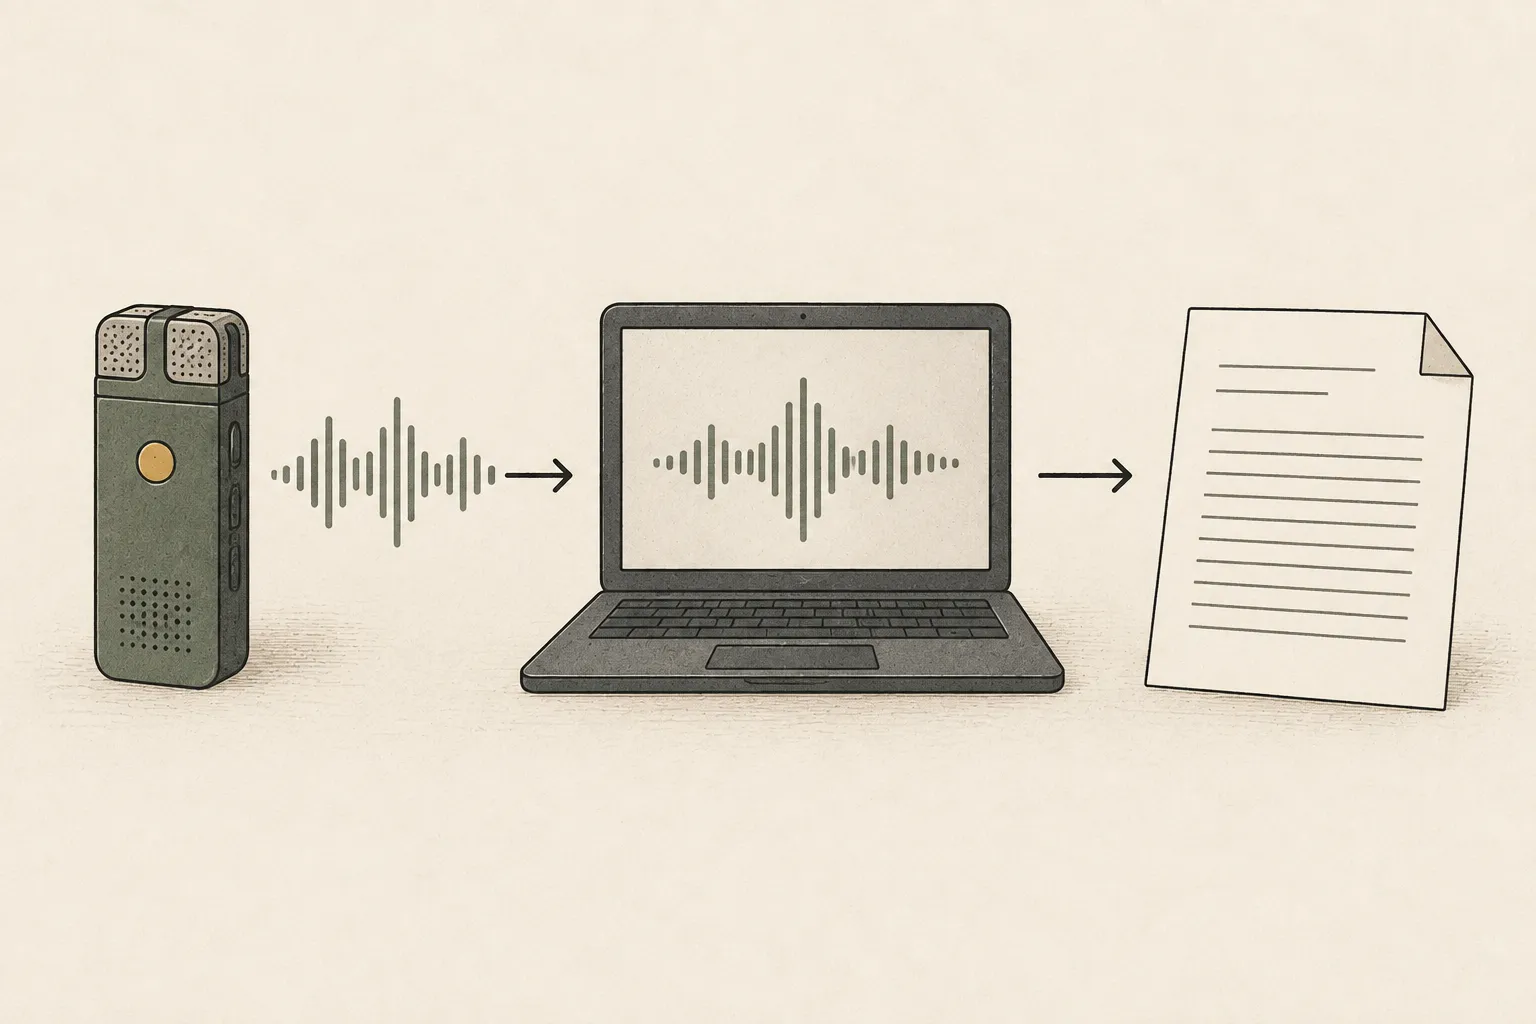
プログラムをビルドし、モデルを準備して最初のファイルを文字起こしします
whisper.cppのリポジトリを用意し、そのフォルダーで以下を実行します。最初の2行はビルド、最後は多言語smallのダウンロードで、インターネット接続が必要になる場合があります。ビルドエラーは公式のOS別ツールと実行ファイルの位置を確認します。
外部アップロードが許可されない環境では、重みを準備した後、ネットワーク遮断ポリシーに沿ってローカルコマンドが動作するか確認します。ここでは構成全体をオフラインで検証したとは主張しません。個人情報を含む録音を使う前に、音声と文字起こしが同期フォルダーへ保存されるか、アプリやツールが外部接続するか確認します。
初回はGit、CMake、OSのC++ビルドツールを用意します。下の最初の2行で公式リポジトリを取得して移動します。macOSはXcode Command Line Tools、LinuxはC++コンパイラー、Windowsは公式のVisual Studio・CMake経路を使います。このシェル例のモデル取得はBash対応環境で実行してください。
git clone https://github.com/ggml-org/whisper.cpp.git
cd whisper.cpp
cmake -B build
cmake --build build -j --config Release
sh ./models/download-ggml-model.sh small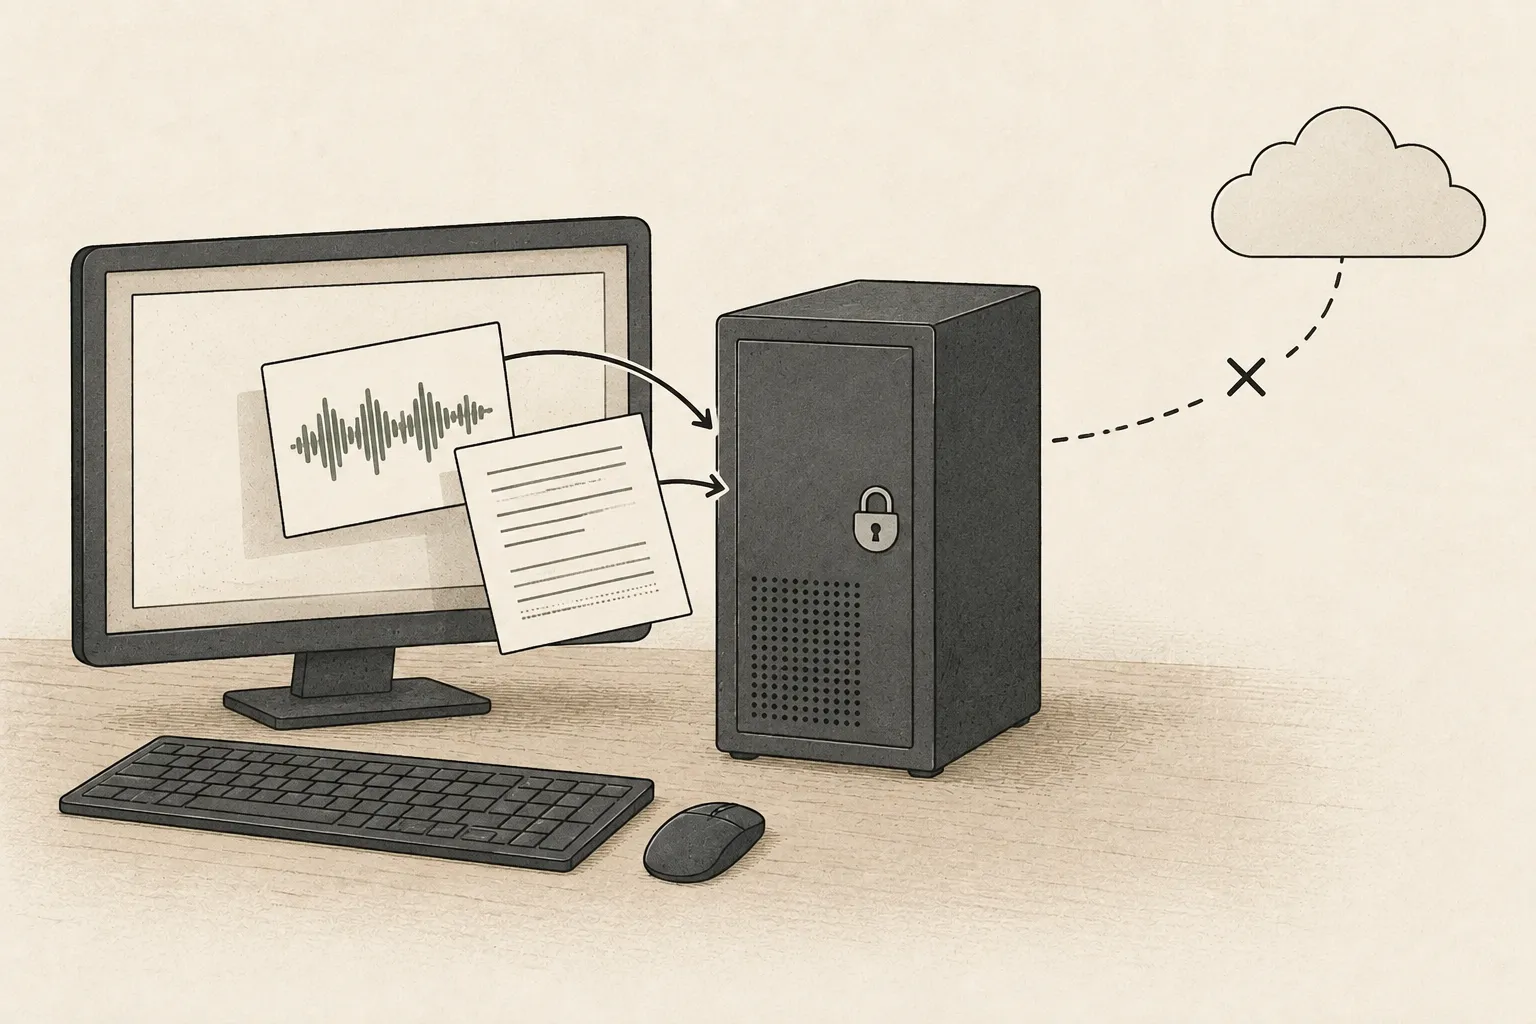
対応するWAV形式で実行し、結果を確認します
公式クイックスタートの例では16kHz、モノラル、16bitのWAV音声を使います。録音をこの形式にしたら、以下のコマンドで-mはモデルファイル、-fは録音、-l koは韓国語、-otxtと-of transcriptはテキスト出力形式と名前を指定します。完了したらtranscript.txtを録音と並べ、重要な箇所を確認します。
./build/bin/whisper-cli -m models/ggml-small.bin -f recording.wav -l ko -otxt -of transcriptMP3やスマートフォンの録音は変換後の音声を先に聞きます
ファイルを開けない問題と音声を誤認識する問題は分けて調べます。MP3は以下の例のように16kHz、モノラル、16bitのWAVへ変換してから再実行できます。拡張子だけ.wavに変えても音声形式は変わりません。変換後の音声を再生し、長さが保たれ声が抜けていないか聞いてから文字起こしを比べます。
2チャンネルの片方にだけ参加者の声がある録音では、モノラル変換後もその声が残るか確認します。ファイル準備中の再生やパスのエラーはモデルサイズを変えても解決しません。代表区間から試すと、ビルド・ファイルパス・変換のどこで止まったか絞り込みやすくなります。
ffmpeg -i input.mp3 -ar 16000 -ac 1 -c:a pcm_s16le recording.wav名前・数値・日付は録音を聞いて確認します
自然な文章に見えても、そのまま議事録に貼り付けないでください。まず会社名、数値、日付、否定表現に印を付けます。該当する音声を探して聞き直し、根拠のない言葉が加わっていないか、大切な表現が抜けていないか確認します。長い沈黙や発話の重なりがあると、もっともらしい文でも実際の発言か判断しにくくなります。話者が不明なら名前を推測せず、要確認として残します。
確認表には基準となる発言、文字起こし、音声で確認した修正を並べて記録します。人による確認時間も測ると、文字起こしで節約した時間と追加の確認負担を分けられます。外部共有時には未確認の草稿か、人が確認した記録かを示します。必要な箇所を聞き直せるよう元の録音を保管します。
自分の機器で処理と確認の時間を測ってから購入を判断します
Apple Siliconではwhisper.cppのMetal1経路を、NVIDIA GPU2ではCUDA3を有効にしたビルドを使えます。GPU名だけから1時間の録音の処理時間は予測できません。モデルサイズ、実際の発話時間と無音、実行設定が影響します。同じ5分音声をsmallで繰り返し処理し、初回と次回以降の時間を分け、名前や数値の修正時間も記録します。この記録はその音声と構成での観察であり、会議全体や別の機器の性能保証ではありません。
音声準備、モデル実行、誤りの確認、共有できる記録になるまでの時間を分けて記録します。LLM4のtoken5生成速度は音声認識の処理量の代わりにはなりません。現在のパソコンで毎週のファイルを処理でき、確認時間も確保できるなら、LLMの速度表だけを理由に音声用GPUを買う必要はありません。待ち時間で定例作業が遅れるか、同じ録音で大型モデルが重要な修正を実際に減らすかを確認してから機器を比較します。
用語の注釈
よくある質問
- この記事で最初に確認すべきことは何ですか?
- whisper.cppは録音ファイルを入力として音声をテキストに変換するプログラムです。韓国語には英語専用の.enモデルではなく多言語モデルを選び、パソコン上で処理して、文字起こしを録音と照合し名前・数値・日付を確認します。まずファイル1件を最後まで処理し、繰り返す作業で処理時間と確認時間を測ってから機器の必要性を判断できます。
- 必要なメモリはどのくらいですか?
- この短い区間は候補を絞るテストであり、長い会議全体の精度を保証するものではありません。固有名詞を繰り返し誤るなら、同じ音声と基準語を使いmediumのような大型多言語モデルと比較します。大型モデルは保存容量や実行メモリも多く必要になる場合があるため、誤りが特定の会社名に限られるか、人が確認できるかも判断します。