
에이전트와 자동화
최종 업데이트
Jev처럼 판단하는 AI를 내 PC에서? d1-3B와 d1-omni 실행 가이드
d1은 질문과 선택지를 미리 정해 두고, 텍스트·이미지·음성 상태에 대한 판단과 확률을 한 번에 돌려줘요.
Liquid AI의 d1 모델은 대화를 이어 쓰는 생성형 챗봇 대신 분류·라우팅·점수화 같은 반복 판단을 맡아요. d1-3B는 텍스트와 이미지, 실험 모델 d1-omni-600M은 텍스트와 이미지 또는 텍스트와 음성을 받아요. GGUF1 모델을 llama.cpp 서버로 실행하고 /v1/systemone에 state와 questions를 보내면 선택 결과와 확률을 JSON으로 받아요.
질문과 선택지를 정하면 d1이 판단 결과를 돌려줘요
고객 문의를 결제·기술·사기 의심 가운데 하나로 분류한다고 해 볼게요. 문의 문장을 상태(state)로 보내고, 담당 부서를 고르는 질문과 선택지를 함께 주면 d1이 선택 결과와 각 선택지의 확률을 JSON으로 반환해요. 결과를 받아 다음 업무로 넘기는 자동화에 쓸 수 있어요.
Liquid AI가 2026년 10월 7일 공개한 d1-3B와 d1-omni-600M은 이런 작업을 위한 decision model이에요. 일반 챗봇처럼 다음 문장을 길게 생성하지 않고, 미리 정의한 질문에 한 번의 forward pass로 답해요. 그래서 질문에 따라 yes/no 확률, 선택지 이름·신뢰도·확률, 또는 순서가 있는 기준의 점수를 받을 수 있어요.
d1-3B는 텍스트와 이미지 입력을 지원해요. d1-omni-600M은 아직 실험 단계이며 텍스트와 이미지, 또는 텍스트와 오디오 입력을 지원해요. 한 요청에 이미지와 오디오를 함께 넣을 수는 없어요. 두 모델 모두 긴 자유형 답변을 쓰지 않으므로 설명문, 상담 대화, 코드 생성을 맡기려면 생성형 모델을 선택해요.
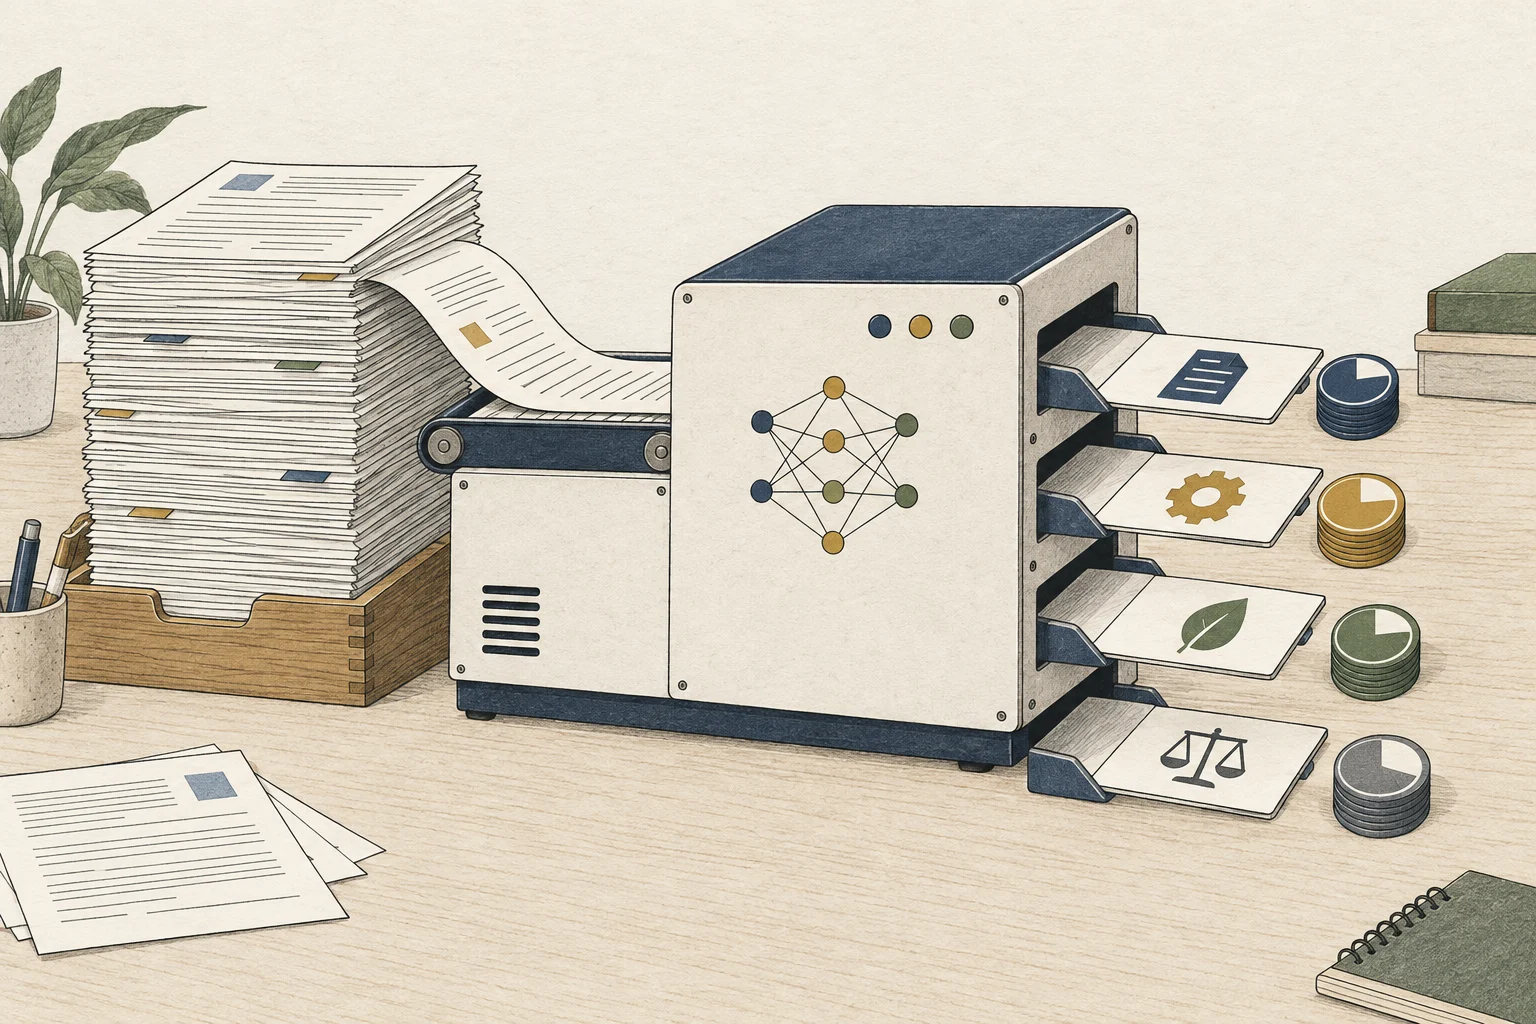
입력 종류와 모델 크기에 따라 두 모델을 골라요
d1-3B는 3B 규모로 두 모델 중 더 큰 선택지예요. d1-omni-600M은 600M 규모라 더 작은 모델이 필요할 때 검토할 수 있고, 텍스트와 이미지 또는 텍스트와 오디오를 받아요. 두 모델 모두 이미지를 지원하고, 오디오는 실험 단계인 omni에서만 지원해요. 실제 업무 입력으로 선택한 모델의 결과를 확인한 뒤 적용해요.
Liquid AI는 d1-3B가 질문 하나를 받아 판단을 반환하기까지의 end-to-end 지연을 공개했어요. 아래 표에서 RTX 4090과 Apple M5 Pro의 텍스트 질문 처리 시간을 비교할 수 있어요.
| 장비 | 입력 구성 | 한 질문 처리 지연 |
|---|---|---|
| NVIDIA RTX 4090 | 텍스트 질문 1개 | 8ms |
| Apple M5 Pro | 텍스트 질문 1개 | 30ms |
d1-omni-600M은 초기 연구 공개라 지연 수치가 제시되지 않았어요. 이미지·오디오 요청은 인코더 처리와 입력 길이에 따라 달라지며, 음성 입력은 최대 30초 클립을 지원해요.
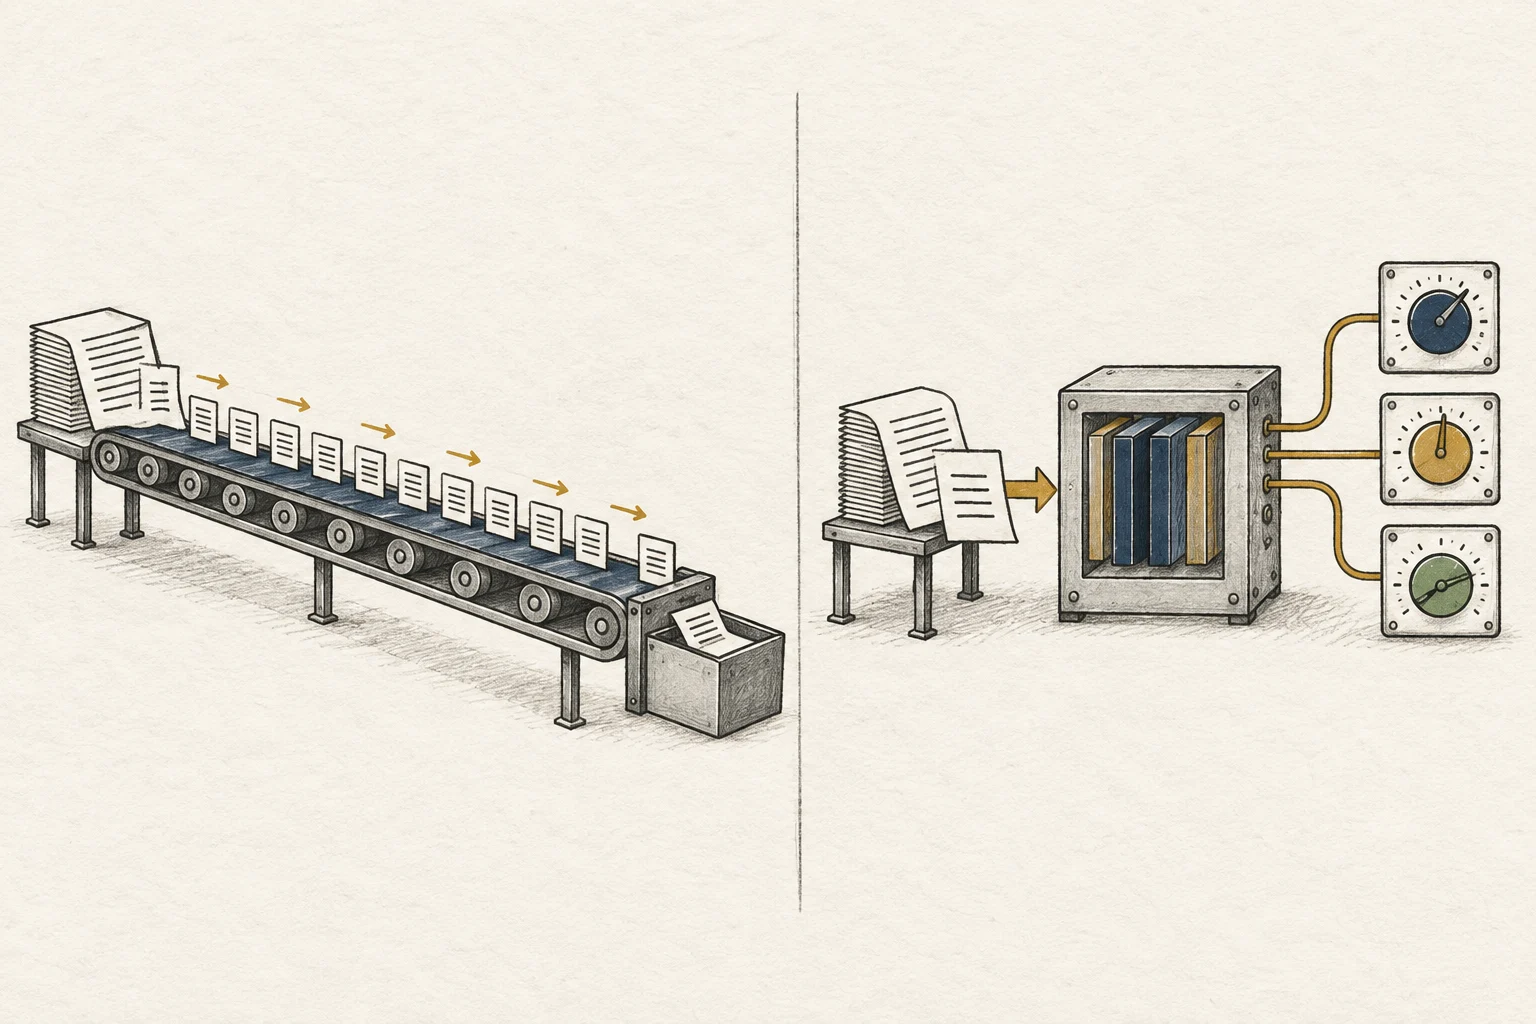
llama.cpp에서 GGUF 서버를 열어요
macOS에서는 Homebrew로, Windows에서는 WinGet으로 llama.cpp를 설치해요.
brew install llama.cppwinget install llama.cpp설치가 끝나면 d1-3B GGUF Q8_0 서버를 시작해요.
llama-server -hf LiquidAI/d1-3B-GGUF:Q8_0서버가 준비되면 웹 UI와 로컬 API2가 열려요. 이 터미널은 켜 둔 채 새 터미널에서 요청을 보내요. Q4_K_M 파일을 쓰려면 모델 ID의 Q8_0 부분을 Q4_K_M으로 바꿔요. Windows에서도 같은 서버 명령을 사용해요.
d1-omni-600M을 실행하려면 모델 ID와 배치 크기3를 바꿔요.
llama-server -hf LiquidAI/d1-omni-600M-GGUF:Q8_0 -b 4096 -ub 4096llama.cpp에서 -b는 논리 배치의 최대 토큰4 수, -ub는 물리 배치의 최대 토큰 수예요. d1-omni는 질문 하나를 한 배치로 읽으므로, 질문 입력이 두 한도 모두에 들어가야 해요. 모델 카드는 4096 설정이 이미지를 포함한 몇천 토큰 state를 다루는 예로 제시하고, 더 긴 state에는 두 값을 최대 16384까지 올리라고 안내해요. 이 설정은 한 번에 처리하는 배치의 크기를 정하고, 문맥 길이는 별도로 정해요. d1-omni GGUF의 Q8_0 모델 파일은 약 407MB예요.
state와 questions를 보내고 선택 확률을 읽어요
서버가 실행 중일 때 새 터미널에서 로컬 API를 호출해요. 다음 예시는 문의 내용을 상태로 보내고 환불 여부와 담당 팀을 물어요. noul은 예·아니요 판단이고, choice는 criteria에 적은 이름 중 하나를 골라요.
curl http://127.0.0.1:8080/v1/systemone -H 'Content-Type: application/json' -d '{
  "state": "이번 달에 두 번 결제됐어요. 한 건은 환불해 주세요.",
  "questions": {
    "refund": {"type": "noul", "instructions": "환불을 요청했나요?"},
    "team": {"type": "choice", "instructions": "어느 팀이 처리해야 하나요?", "criteria": {"billing": "결제·환불·청구서", "technical": "앱이나 사이트 오류", "fraud": "무단 사용 의심"}}
  }
}'
응답에는 answers와 usage가 들어와요. refund는 긍정 확률을 담는 noul 값이고, team에는 선택한 이름과 confidence, 선택지별 probabilities가 있어요. usage.output_tokens는 0이에요. 업무 자동화에서 확률 임계값과 사람 검토 조건은 애플리케이션에서 정해요.
이미지는 요청의 images 배열에 이미지 data URL을 넣어요. d1-omni 오디오는 files에 오디오 data URL을 넣고, 한 요청에는 이미지 입력 또는 최대 30초 오디오 클립 중 하나를 보내요. d1-3B는 텍스트와 이미지, d1-omni는 텍스트와 이미지 또는 텍스트와 오디오를 처리해요. 실제 업무 자료로 원하는 typed answer와 확률이 나오는지 확인해요.
처음 서버가 안 뜨면 모델 ID와 배치 설정을 확인해요
-hf 뒤 모델 저장소를 찾지 못하면 모델 ID가 LiquidAI/d1-3B-GGUF:Q8_0 또는 LiquidAI/d1-omni-600M-GGUF:Q8_0인지 확인해요. Hugging Face에서 파일을 받는 중이라면 첫 실행의 다운로드가 끝날 때까지 터미널을 열어 둬요.
서버가 켜졌는데 요청에서 오류가 나면 경로가 /v1/systemone인지, JSON에 state와 questions가 모두 있는지 확인해요. 선택형 질문은 각 선택지 설명을 criteria에 넣어야 해요. d1-omni에서 질문 상태가 배치 크기보다 길다는 오류가 나오면 -b와 -ub를 같은 값으로 늘리되 최대 16384 범위 안에서 다시 시작해요.
마지막으로 llama.cpp 버전을 확인해요. 모델 카드는 llama.cpp의 GGUF 사용법을 안내하지만, 매우 오래된 빌드에서는 새 모델 아키텍처나 /v1/systemone 경로가 없을 수 있어요. 저장소의 최신 설치 절차로 업데이트한 다음 다시 요청해요. 여기까지 성공하면 구조화된 판단 결과를 받아 기존 앱의 다음 단계에 연결할 수 있어요.
용어 각주
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- Liquid AI의 d1 모델은 대화를 이어 쓰는 생성형 챗봇 대신 분류·라우팅·점수화 같은 반복 판단을 맡아요. d1-3B는 텍스트와 이미지, 실험 모델 d1-omni-600M은 텍스트와 이미지 또는 텍스트와 음성을 받아요. GGUF 모델을 llama.cpp 서버로 실행하고 /v1/systemone에 state와 questions를 보내면 선택 결과와 확률을 JSON으로 받아요.
- 조건과 출처는 어디서 확인하나요?
- 마지막으로 llama.cpp 버전을 확인해요. 모델 카드는 llama.cpp의 GGUF 사용법을 안내하지만, 매우 오래된 빌드에서는 새 모델 아키텍처나 `/v1/systemone` 경로가 없을 수 있어요. 저장소의 최신 설치 절차로 업데이트한 다음 다시 요청해요. 여기까지 성공하면 구조화된 판단 결과를 받아 기존 앱의 다음 단계에 연결할 수 있어요.