
エージェントと自動化
最終更新
Jevのように判断するAIをPCで使える?d1-3Bとd1-omniの実行ガイド
質問と選択肢をあらかじめ定義すると、d1はテキスト・画像・音声の状態に対する判断と確率を1回の処理で返します。
Liquid AIのd1モデルは会話を続ける生成型チャットボットではなく、分類・ルーティング・採点などの反復判断を担います。d1-3Bはテキストと画像、実験モデルd1-omni-600Mはテキストと画像、またはテキストと音声を受け取ります。GGUF1モデルをllama.cppサーバーで実行し、/v1/systemoneにstateとquestionsを送ると、選択結果と確率がJSONで返ります。
質問と選択肢を定義すると、d1が判断結果を返します
たとえば問い合わせを請求・技術サポート・不正利用のいずれかに振り分けるとします。問い合わせ文をstateとして送り、担当チームを選ぶ質問と選択肢を添えると、d1は選択結果と各選択肢の確率をJSONで返します。その結果を受けて次の処理へ回せます。
Liquid AIは2026年10月7日、こうした用途向けのdecision modelとしてd1-3Bとd1-omni-600Mを公開しました。一般的なチャットボットのように長い文章を生成せず、定義済みの質問に1回のforward passで答えます。質問に応じて、yes/noの確率、選択肢と信頼度・各選択肢の確率、順序尺度のスコアを返します。
d1-3Bはテキストと画像を受け取ります。実験段階のd1-omni-600Mはテキストと画像、またはテキストと音声に対応し、1つのリクエストに画像と音声を同時に含めることはできません。どちらも長い自由形式の回答は生成しないため、説明文やサポート会話、コード生成には生成モデルを使います。
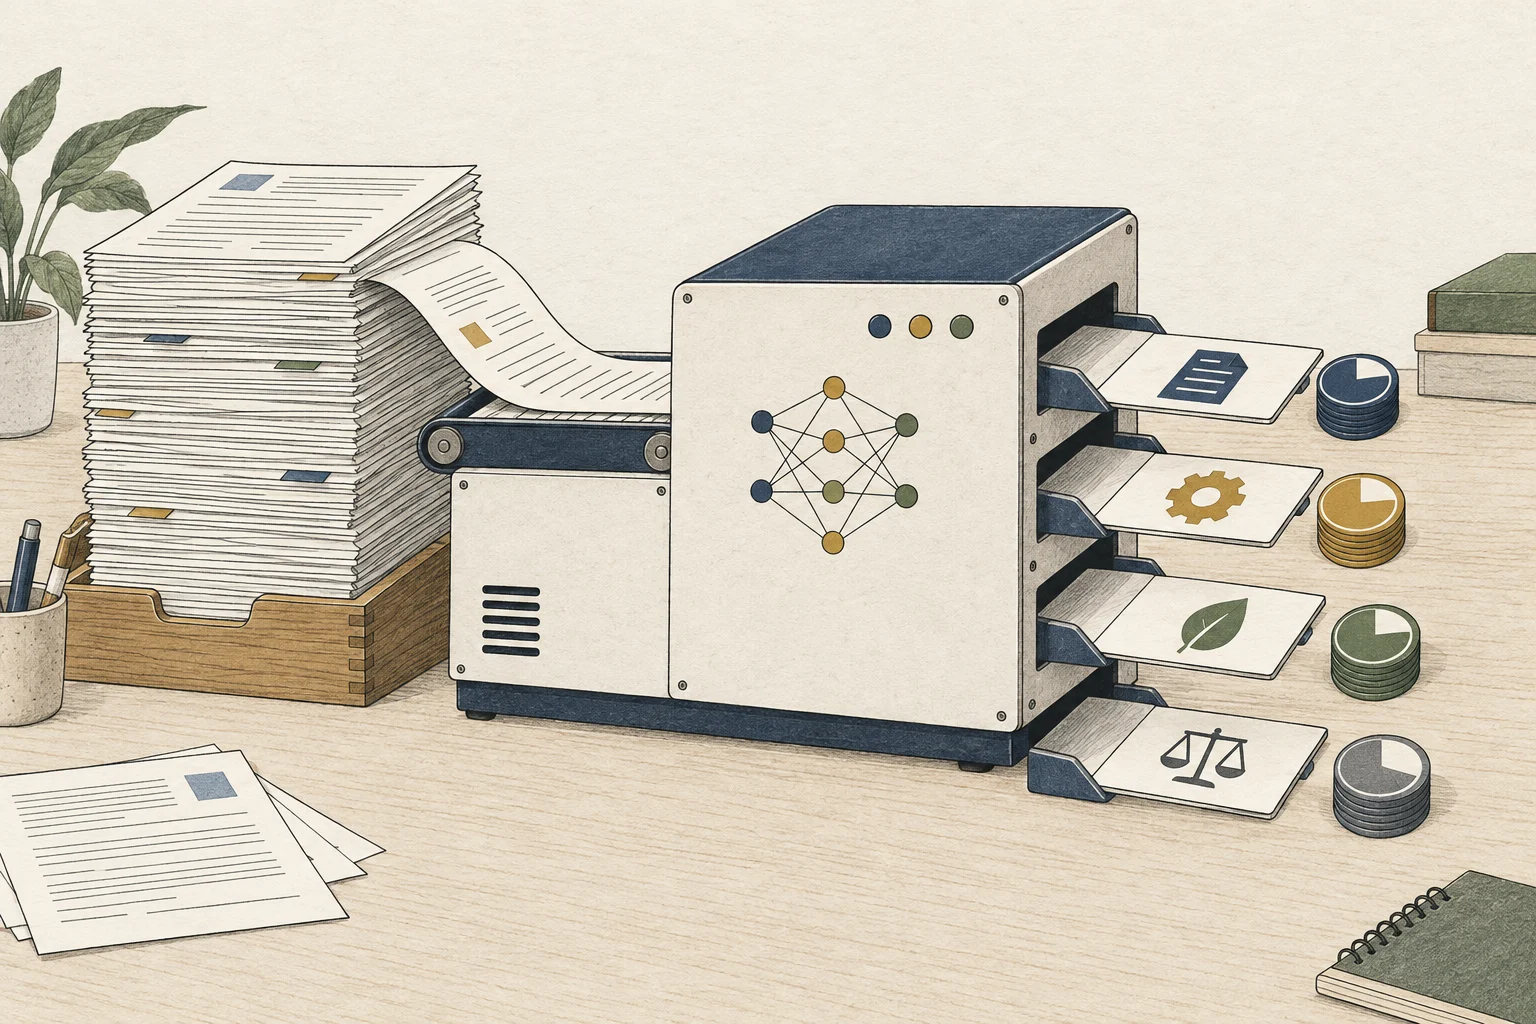
入力の種類とモデルサイズで2モデルを選びます
d1-3Bは3B規模で、2つのうち大きい選択肢です。d1-omni-600Mは600M規模の小型モデルで、より軽いチェックポイント2が必要な場合に検討できます。テキストと画像、またはテキストと音声を受け取ります。両モデルとも画像に対応し、音声に対応するのは実験段階のomniのみです。導入前に実際の業務入力で確認してください。
Liquid AIはd1-3Bが1件の質問を受けて判断を返すまでのend-to-end遅延を公開しました。下の表でRTX 4090とApple M5 Proのテキスト質問処理時間を比較できます。
| 機器 | 入力構成 | 1つの質問の処理時間 |
|---|---|---|
| NVIDIA RTX 4090 | テキスト質問1件 | 8ms |
| Apple M5 Pro | テキスト質問1件 | 30ms |
初期研究公開のd1-omni-600Mにはレイテンシ値が公表されていません。画像・音声リクエストの処理時間はエンコーダー処理と入力長によって変わり、音声入力は最大30秒のクリップに対応します。
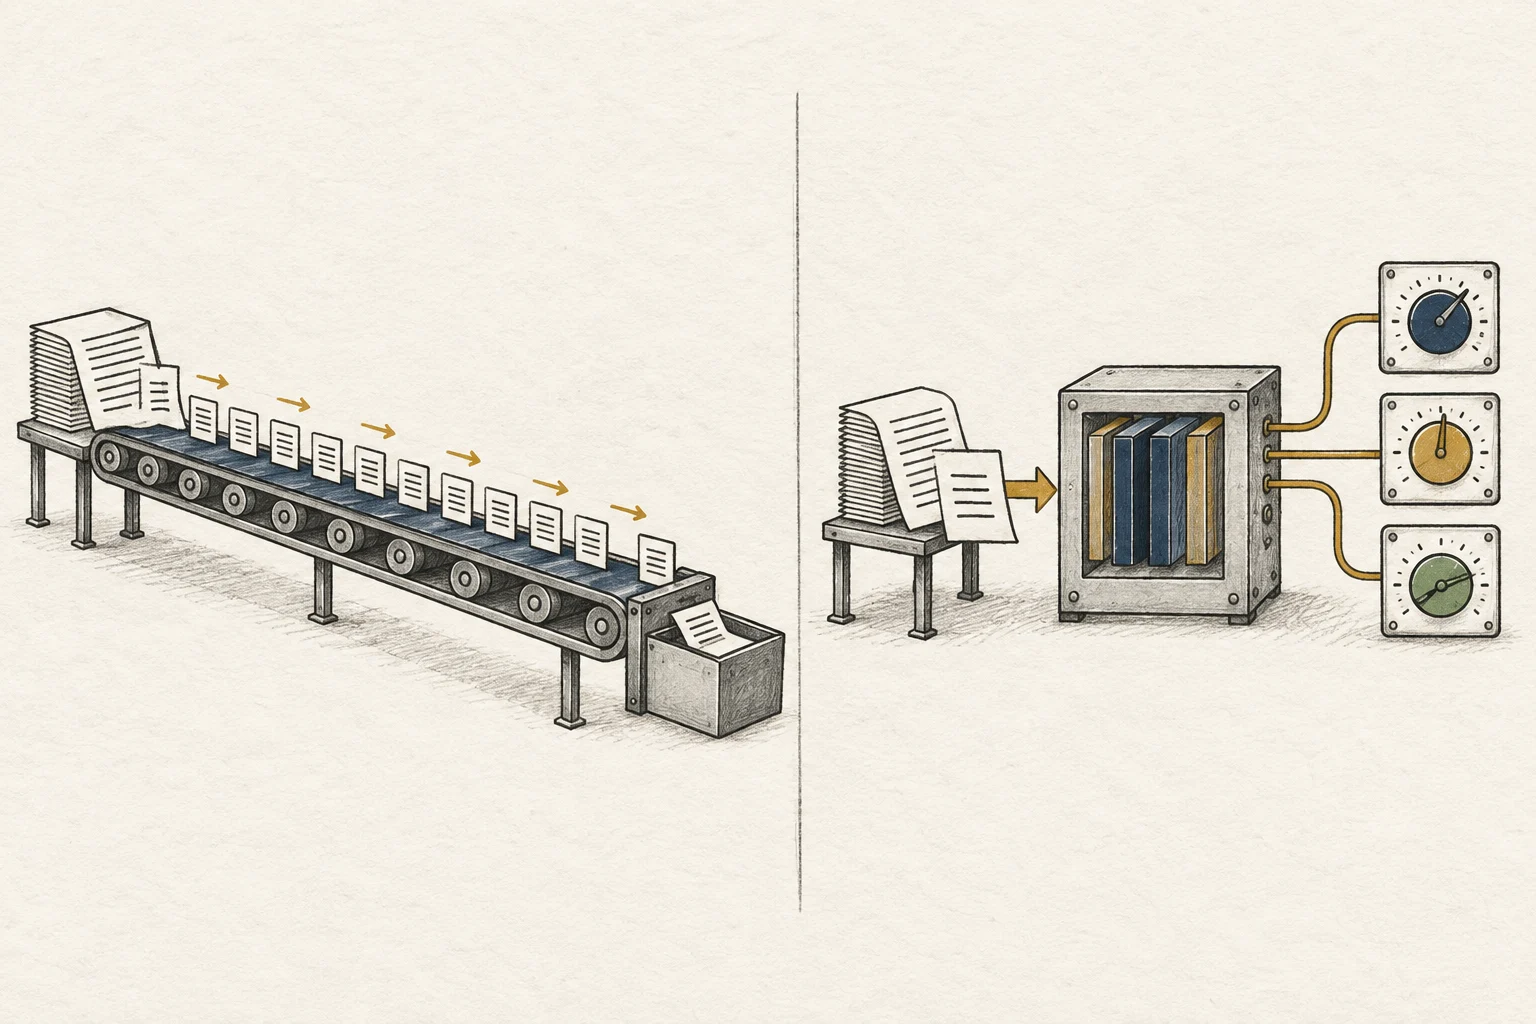
llama.cppでGGUFサーバーを起動します
macOSではHomebrew、WindowsではWinGetでllama.cppをインストールします。
brew install llama.cppwinget install llama.cppインストール後、d1-3B GGUF Q8_0サーバーを起動します。
llama-server -hf LiquidAI/d1-3B-GGUF:Q8_0サーバーが起動するとWeb UIとローカルAPI3を利用できます。このターミナルを開いたまま、別のターミナルからリクエストを送ります。Q4_K_Mファイルを使う場合はモデルIDのQ8_0をQ4_K_Mに置き換えます。Windowsでも同じサーバーコマンドを使えます。
d1-omni-600Mを実行するには、モデルIDとバッチサイズ4を変更します。
llama-server -hf LiquidAI/d1-omni-600M-GGUF:Q8_0 -b 4096 -ub 4096llama.cppでは、-bが論理バッチの最大トークン5数、-ubが物理バッチの最大トークン数です。d1-omniは1つの質問を1バッチで読み込むため、質問入力を両方の上限内に収めます。モデルカードでは、4096を画像や数千トークンのstateを処理する例として示し、より長いstateでは両方の値を最大16384まで上げるよう案内しています。この設定で一度に処理するバッチの大きさが決まり、コンテキスト長は別に設定します。d1-omni GGUFのQ8_0モデルファイルは約407MBです。
stateとquestionsを送り、選択確率を読みます
サーバーを起動したまま、別のターミナルからローカルAPIを呼び出します。次の例では問い合わせ文をstateとして送り、返金依頼の有無と担当チームを質問します。noulはyes/no判断、choiceはcriteriaの名前から1つを選びます。
curl http://127.0.0.1:8080/v1/systemone -H 'Content-Type: application/json' -d '{
  "state": "今月は二重に請求されました。1件を返金してください。",
  "questions": {
    "refund": {"type": "noul", "instructions": "返金を依頼していますか?"},
    "team": {"type": "choice", "instructions": "どのチームが対応しますか?", "criteria": {"billing": "支払い・返金・請求書", "technical": "アプリまたはサイトのエラー", "fraud": "不正利用の疑い"}}
  }
}'レスポンスにはanswersとusageが含まれます。refundは肯定確率を持つnoul値で、teamには選択した名前、confidence、選択肢ごとのprobabilitiesが含まれます。usage.output_tokensは0です。確率のしきい値と人による確認条件はアプリ側で設定します。
画像はリクエストのimages配列に画像data URLを入れます。d1-omniの音声入力はfilesに音声data URLを入れ、1回のリクエストで送れるのは画像入力か最大30秒の音声クリップのどちらかです。d1-3Bはテキストと画像、d1-omniはテキスト+画像またはテキスト+音声を処理します。実際の業務データで必要なtyped answerと確率が得られるか確認します。
サーバーが起動しない場合はモデルIDとバッチ設定を確認します
-hfの後にリポジトリが見つからない場合は、モデルIDがLiquidAI/d1-3B-GGUF:Q8_0またはLiquidAI/d1-omni-600M-GGUF:Q8_0か確認します。初回のHugging Faceダウンロードが終わるまでターミナルを開いたままにしてください。
サーバー起動後にリクエストが失敗した場合は、パスが/v1/systemoneか、JSONにstateとquestionsが両方あるか確認します。選択式の質問では、各選択肢の説明をcriteriaに入れます。d1-omniでstateがバッチサイズを超えるというエラーが出たら、-bと-ubを同じ値にして最大16384まで増やし、サーバーを再起動します。
最後にllama.cppのバージョンを確認します。モデルカードにはllama.cppでGGUFを使う方法が記載されていますが、古いビルドでは新しいモデルアーキテクチャや/v1/systemoneエンドポイントに対応していない場合があります。最新のインストール手順で更新してから再度リクエストしてください。応答が返れば、構造化された判断結果をアプリの次の処理に渡せます。
用語の注釈
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Liquid AIのd1モデルは会話を続ける生成型チャットボットではなく、分類・ルーティング・採点などの反復判断を担います。d1-3Bはテキストと画像、実験モデルd1-omni-600Mはテキストと画像、またはテキストと音声を受け取ります。GGUFモデルをllama.cppサーバーで実行し、/v1/systemoneにstateとquestionsを送ると、選択結果と確率がJSONで返ります。
- 条件と出典はどこで確認できますか?
- 最後にllama.cppのバージョンを確認します。モデルカードにはllama.cppでGGUFを使う方法が記載されていますが、古いビルドでは新しいモデルアーキテクチャや`/v1/systemone`エンドポイントに対応していない場合があります。最新のインストール手順で更新してから再度リクエストしてください。応答が返れば、構造化された判断結果をアプリの次の処理に渡せます。