実行プログラムと拡張機能
Jev-Omniとは?画像・音声・動画から答えを選ぶローカルAI
玄関の写真から知りたいことがドアの開閉だけなら、写真全体の長い説明は必要ありません。録音でも全文の文字起こしではなく、特定の出来事があったかだけを確認したいことがあります。Jev-Omniはそのような処理に使う公開分類モデルです。状況・質問・選択肢を渡すと、各選択肢の確率を返します。ただし、TypeSafe AIのJevをダウンロードできるという意味ではありません。Gemma 4 12B ITを基に別の開発者が作った独立プロジェクトで、一般的なチャットアプリにモデルファイルを入れる方法とは実行手順が異なります。
長い説明より短い判断が役立つ場面
玄関を撮影するカメラを考えてみましょう。自動化に必要なのは「開いている」「閉じている」「写真では判断できない」のいずれかです。写っている物を流暢に説明しても、プログラムは最後にその三つから一つを選ぶ必要があります。Jev-Omniは、その選択自体を結果として受け取るための方法です。
「なぜそう判断したか説明して」「この写真から広告画像を作って」は別の処理です。Jev-Omniは説明文を書くモデルでも、画像や動画を生成するモデルでもありません。同じ種類の質問を繰り返し処理する分類器や、次に使うツールを選ぶ補助モデルとして捉えると用途が分かりやすくなります。
既存のJEVガイドにあるQwen実装との違い
ローカルのJEV型実装には、Qwenが次に出力する候補トークン1のスコアを直接読む方式があります。Jev-OmniはGemma 4 12B ITベースのモデルに、別途学習した分類ヘッドを組み合わせます。公開コードでは入力を処理した後、最後の位置の内部表現をヘッドに渡し、選択肢のスコアを確率に変えます。長い文章を順に生成するデコード2ループはありません。
結果にはprediction、prediction_index、confidence、probabilitiesが含まれます。最大確率の選択肢だけを使うことも、全確率を保存して後で確認することもできます。
optionsの文言は重複させない方がよいでしょう。結果の辞書はその文言をキーにするため、同じ文言があると結果を読み違えやすくなります。
predictは1回につき一つの質問を扱い、複数の質問を追加コストなしで同時処理するわけではありません。
まず一つのファイルで、実際に見える内容を尋ねる
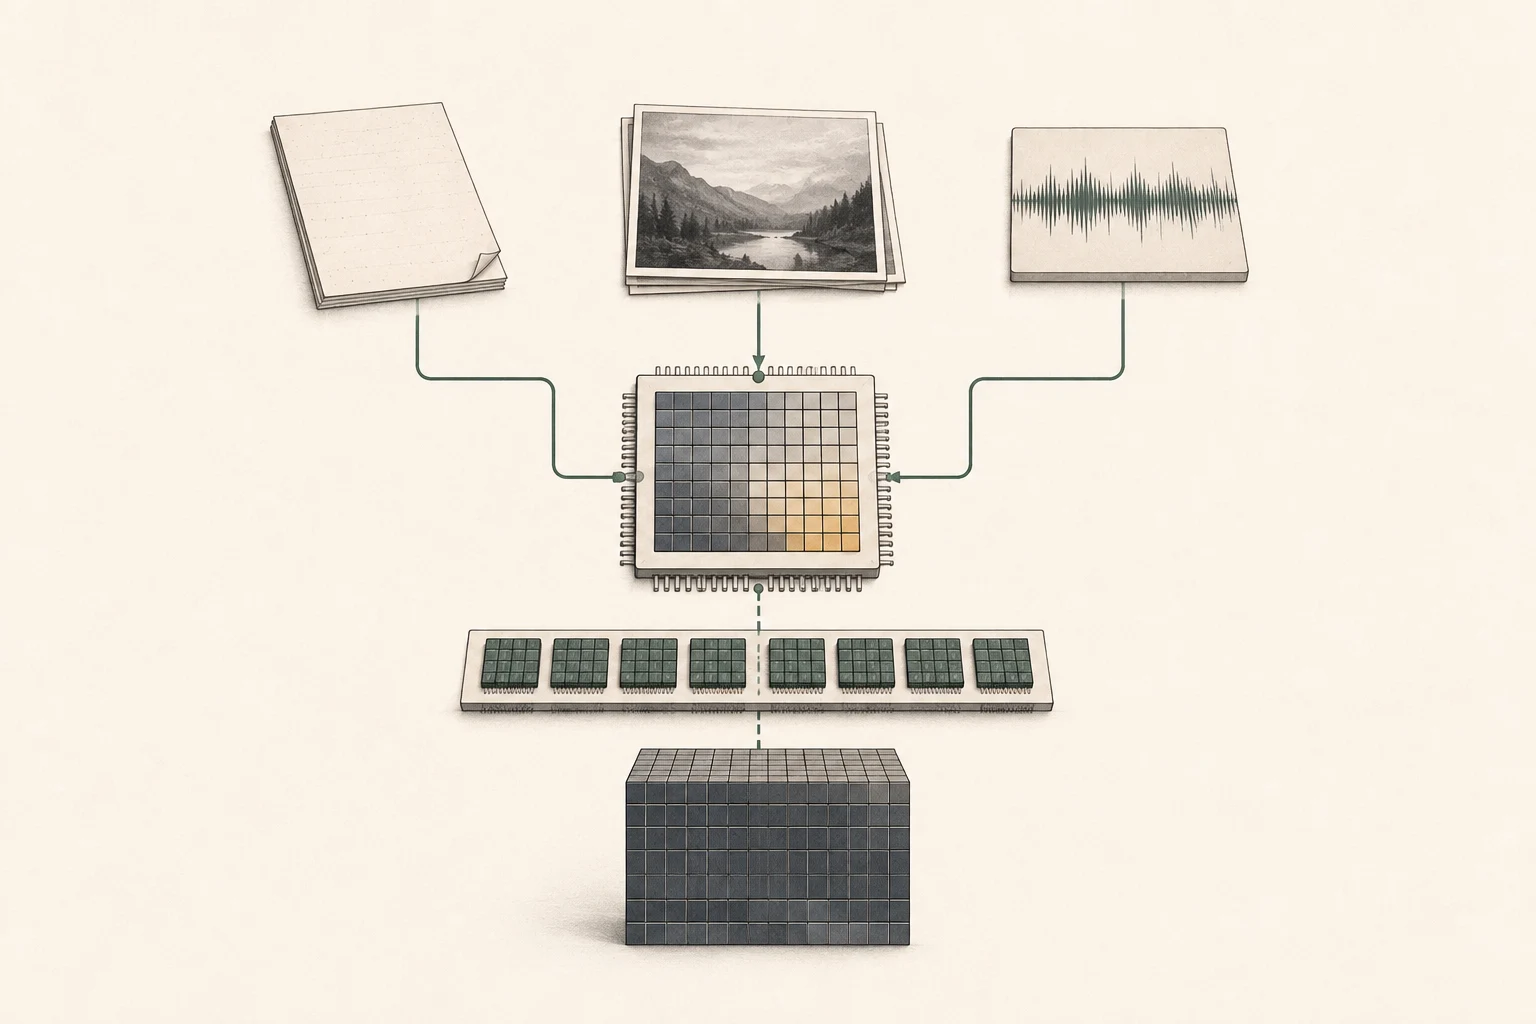
画像ならぼけの有無や特定の物の存在を分類するところから始められます。音声では短い区間に特定の音があったか、動画では場面間で状態が変化したかを試せます。ただし、これらは活用例であり、すべての用途で精度が検証済みという意味ではありません。実際のファイルと人が付けた正解を用意し、自分の処理に合うか確かめます。
公開ヘルパーの音声経路は、ffmpegで先頭から最大30秒を切り出して処理します。動画は標準で16フレーム3を抽出して画像として渡し、動画の音声トラックを一緒に聞く経路ではありません。長い動画の一瞬の出来事は抽出フレームの間から抜け落ちることがあります。「動画対応」と「すべての瞬間を確認できる」は別です。
12Bという名前より先に確認したい読み込み方式
普段12Bモデルを4ビットで動かしていると、数GBで足りると思うかもしれません。しかし公開Jev-Omniチェックポイント4は、その配布形式ではありません。テキスト重みのインデックスだけで約47.63GBあり、標準ローダーはまずFP325でCUDA6に載せます。モデルカードも実行時の余裕を除いて約50GBと案内しています。24GBのRTX 3090・4090や32GBのRTX 5090で標準例がそのまま動くとは考えない方がよいでしょう。
初期読み込みのピークも重要です。マルチモーダルローダーは一部の線形層をBF167に変換した後、元のGemmaモデルも読み込んで部品を置き換えます。計算時にBF16 autocastを使うことと、最初から全重みを半分の容量で載せることは同じではありません。最終使用量だけで機材を選ぶと初期化中に失敗する可能性があるため、特定の容量を確実な最低要件とはしていません。
メモリに余裕があるMacでも、現在の公開load_jev_omniはCUDA以外のデバイスを拒否します。標準関数には2枚のGPU8のメモリを合算する分散読み込みもありません。Macでは既存のQwen・MLX9によるJEV型実装を先に検討する方が現実的です。量子化10やローダーの修正は別途検証する実験であり、公開例がすでに対応している機能とは扱えません。
専用のPython環境で導入する
以下は公開Pythonヘルパーを使う手順です。まずCUDA対応のPyTorch11が現在のGPUで動くことを確認してください。モデルリポジトリからコードを取得して実行するため、依存パッケージを入れる前にjev_omni.pyとload_model.pyを確認します。専用の仮想環境12を使うと、ほかのローカルAIツールとのパッケージ競合を減らせます。
要求バージョンはtorch 2.10以上とtransformers 5.17.0です。音声を使う場合はPythonパッケージとは別にffmpeg実行ファイルも必要です。初回はJev-Omniに加え、元のGemmaのマルチモーダル部品もダウンロードします。保存容量・ダウンロード時間と推論時間は分けて考え、最初は個人ファイルではなくテスト用素材を使ってください。
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -U pip huggingface_hub
hf download akhilaaa3/Jev-Omni requirements.txt jev_omni.py load_model.py --local-dir jev-omni
# Review the downloaded Python files before continuing.
python -m pip install -r jev-omni/requirements.txt
python -c "import torch; print(torch.cuda.is_available())"テキストを一件試してから写真を加える
次のコードをjev_demo.pyとして保存し、仮想環境でpython jev_demo.pyを実行します。最初の質問は読み込みと出力形式を確認するためのものです。Pythonの結果に選択肢の文言と確率が入るので、自由文の回答を再解析する必要はありません。これは公開関数の呼び出し例であり、実測結果を作り込んだものではありません。
テキスト呼び出しが動いたら、画像例のコメントを外し、mediaに実在するローカルファイルを指定します。公開ヘルパーはそのファイルをローカルで読みますが、初回のモデルや設定取得にはインターネット接続が必要です。写真から分からない場合に備えて「判断できない」という選択肢も用意します。韓国語での業務精度は別途確認が必要なため、例は英語にしています。
import sys
from pathlib import Path

sys.path.insert(0, str(Path("jev-omni").resolve()))
from jev_omni import load_jev_omni

classifier = load_jev_omni()
result = classifier.predict(
    state="The parcel arrived yesterday. The customer confirmed receipt.",
    question="Has the customer received the parcel?",
    options=["Yes", "No", "Not enough information"],
)
print(result)

# After the text test succeeds, set an existing local image path.
# result = classifier.predict(
#     state="This is a photo of a doorway.",
#     question="What is the state of the door?",
#     options=["Open", "Closed", "Cannot tell from this image"],
#     media="/absolute/path/door.jpg",
#     modality="image",
# )
# print(result)公開値は速いものの、どこまで測った数字なのか
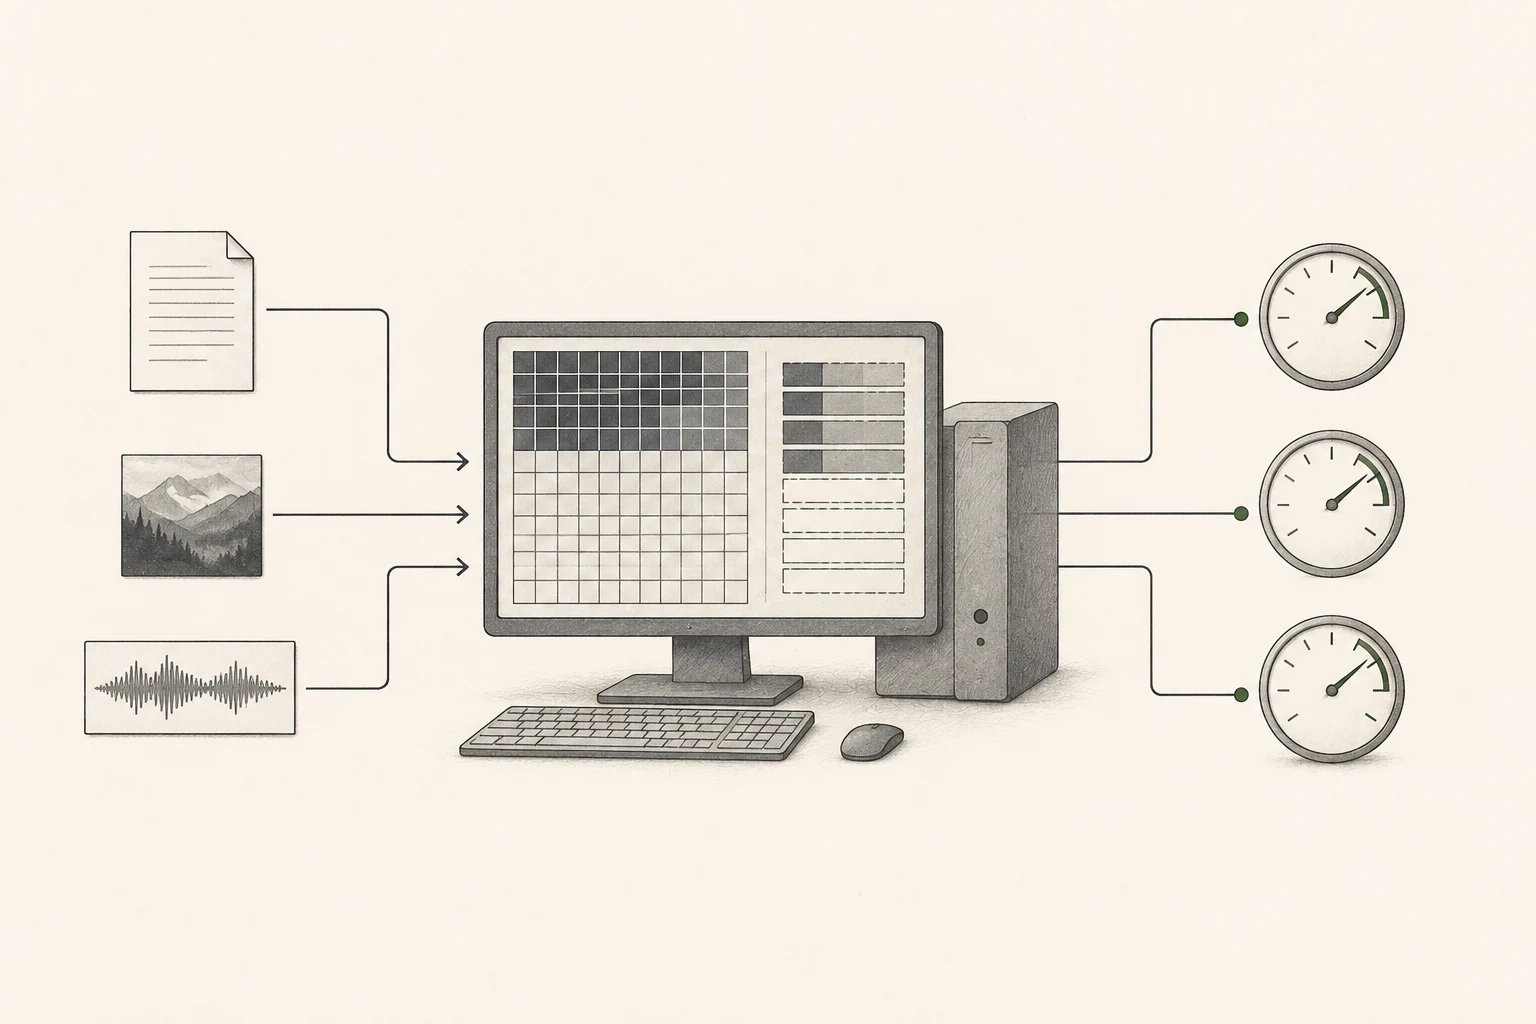
モデルカードのH200結果は、最適化したバックエンドでウォーム状態のリクエストを20回実行した中央値です。約2,000トークンのテキストは83ms、画像は26ms、13秒音声は31ms、16フレーム動画は504msとされています。前処理とネットワーク時間は別です。大きな動画を開いてフレームを読み込む時間や、初回の重み読み込み時間は含まれません。
チャットモデルのtok/sと横に並べる比較にも向きません。長い回答を生成しないため、入力から分類完了までの遅延や処理可能なリクエスト数が適切な指標です。そのためH200の値をサイトのRTX・Mac速度体験へ換算していません。手元では読み込み後に同じファイル・質問を複数回試し、前処理を含めた時間も別に残すとよいでしょう。
| 評価 | 公開スコア | 確認する条件 |
|---|---|---|
| DecisionBench Medium | 87.57% | 80シナリオ・293問、シナリオを等重みで平均 |
| JevBench | 86.15% | 対応する195グループ・231判断、グループを等重みで平均 |
| MMAU | 63.10% | 1,000問のmicro accuracy |
| MVBench | 53.10% | 評価した14タスク・2,786問、タスク平均 |
開発者が公開したマージ済みモデルの評価
DecisionBench Medium
- 公開スコア
- 87.57%
- 確認する条件
- 80シナリオ・293問、シナリオを等重みで平均
JevBench
- 公開スコア
- 86.15%
- 確認する条件
- 対応する195グループ・231判断、グループを等重みで平均
MMAU
- 公開スコア
- 63.10%
- 確認する条件
- 1,000問のmicro accuracy
MVBench
- 公開スコア
- 53.10%
- 確認する条件
- 評価した14タスク・2,786問、タスク平均
確率が出ても、判断をそのまま任せない
高いconfidenceでも、自分のデータで高い正解率を保証するわけではありません。主に20選択肢以下がサポート対象で、ヘッドの上限256個とその範囲での検証済み品質は別です。まず実際の質問を数十件手作業で採点し、誤答時の確率も確認します。自動処理の基準はその記録から決め、曖昧な結果は確認待ちに残すと安全です。
リポジトリと基盤のGemma 4はいずれもApache-2.0と表示されています。ただし、学習データや入力する写真・録音の権利は別です。また、TypeSafe AIとは独立したプロジェクトで、Jevの出力を学習に使っていないと説明されています。名前から生じる誤解を避けるためにも、この違いは押さえておきたい点です。
ローカルAIの用途は長い会話だけではありません。毎日確認していた写真フォルダーから注意が必要なものだけを拾う、繰り返しの分類を手伝う。そうした小さな機能でも十分に役立ちます。Jev-Omniはその方向を示す公開例です。手元の機材で小さなQwen実装を使い、質問と選択肢を先に整えても構いません。そこで有用な判断が得られるようになれば、より大きなマルチモーダルモデルを使う理由も明確になります。
用語の注釈
トークン — モデルが入力や出力を分けて処理する単位です。1トークンが1文字や一定の時間に相当するわけではありません。
本文に戻るデコード — LLMでは入力処理後に出力トークンを生成する段階です。VAEやオーディオコーデックでは、圧縮表現や符号化データから元の形式を復元する処理を指すことがあります。
本文に戻るフレーム — 動画を構成する1枚の画像です。フレームレートとフレーム解像度は別の属性です。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るFP32 — 32ビット浮動小数点形式です。BF16より値あたりのメモリを多く使い、数値をより細かく表現できます。
本文に戻るCUDA — NVIDIA GPUで汎用計算を行うソフトウェア基盤です。CUDA向けのプログラムが他のGPUでそのまま動くとは限りません。
本文に戻るBF16 — モデルの数値を保存・計算する16ビット浮動小数点形式です。利用可否はハードウェアと実行環境によります。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るMLX — Apple silicon向けの機械学習フレームワークです。統合メモリ構造を活用し、対応モデルや機能はMLXの各ツールで異なります。
本文に戻る量子化 — モデルの数値を少ないビット数で表す方法です。メモリ使用量のほか、精度や実行速度も変わることがあり、影響は形式と実装によります。
本文に戻るPyTorch — AIモデルを作成・実行するソフトウェアフレームワークです。モデルと合わせて、対応するPyTorchの版やハードウェアも確認します。
本文に戻るPython仮想環境 — プロジェクトごとにPythonパッケージを分けて導入する環境です。版の衝突を減らすもので、仮想マシンとは異なります。
本文に戻る