
이미지·영상 생성
최종 업데이트
Wan 2.2와 MiniMax 영상 모델, 로컬 작업별 선택법
영상과 소리, 사진 입력에 맞춰 Wan·MiniMax 경로를 골라요
Wan 2.2 TI2V-5B는 사진에서 영상을 시작하고, T2V-14B는 문장으로 새 장면을 만들며, MiniMax H3-Base는 영상과 스테레오 오디오를 함께 출력해요. 먼저 결과물에 필요한 입력과 소리를 정한 뒤, 모델별 해상도·메모리·실행 경로에 맞춰 짧게 시험해요.
제품 사진의 모양을 유지하며 짧은 소개 영상을 만들고, 필요하면 장면에 맞는 소리도 얻고 싶다고 해볼게요. 사진을 움직이는 영상으로 바꾸려면 이미지 입력을 받는 TI2V 경로가 필요하고, 글로 새 장면을 만드는 일은 T2V 경로에 맞아요. 영상과 소리를 한 번에 만들어야 할 때는 H3-Base처럼 결합 출력을 지원하는 모델을 살펴봐요.
세 경로는 입력과 계산 방식이 달라서 모델 이름이나 파라미터 수만으로 비교할 수 없어요. 먼저 필요한 결과를 기준으로 후보를 좁히고, LightX2V의 H3 Turbo 공개 설정과 Wan 계열의 메모리·해상도 조건을 읽는 법을 설명해요.
영상만 필요한지, 장면 안의 소리도 필요한지 정해요
제품 사진을 움직이는 5초 소개 영상으로 만들고 싶다면 먼저 소리도 함께 생성할지 정해요. MiniMax H3-Base는 영상과 스테레오 오디오를 함께 출력해요. 무음 클립으로 충분하다면 Wan의 영상 생성 경로를 쓰고 편집기에서 필요한 효과음이나 음악을 붙일 수 있어요.
결합 출력은 무음 영상을 만든 뒤 음악을 얹는 작업과 계산 과정이 달라요. 사용하려는 모델이 내보내는 결과가 편집 단계와 맞는지 확인하고, 영상과 음성을 함께 저장했다면 장면의 타이밍과 소리가 어울리는지도 재생해 봐요.
사진과 첫·끝 프레임을 입력으로 받을 수 있는지 확인해요
모델 크기보다 출력 조건과 메모리 배치를 함께 봐요
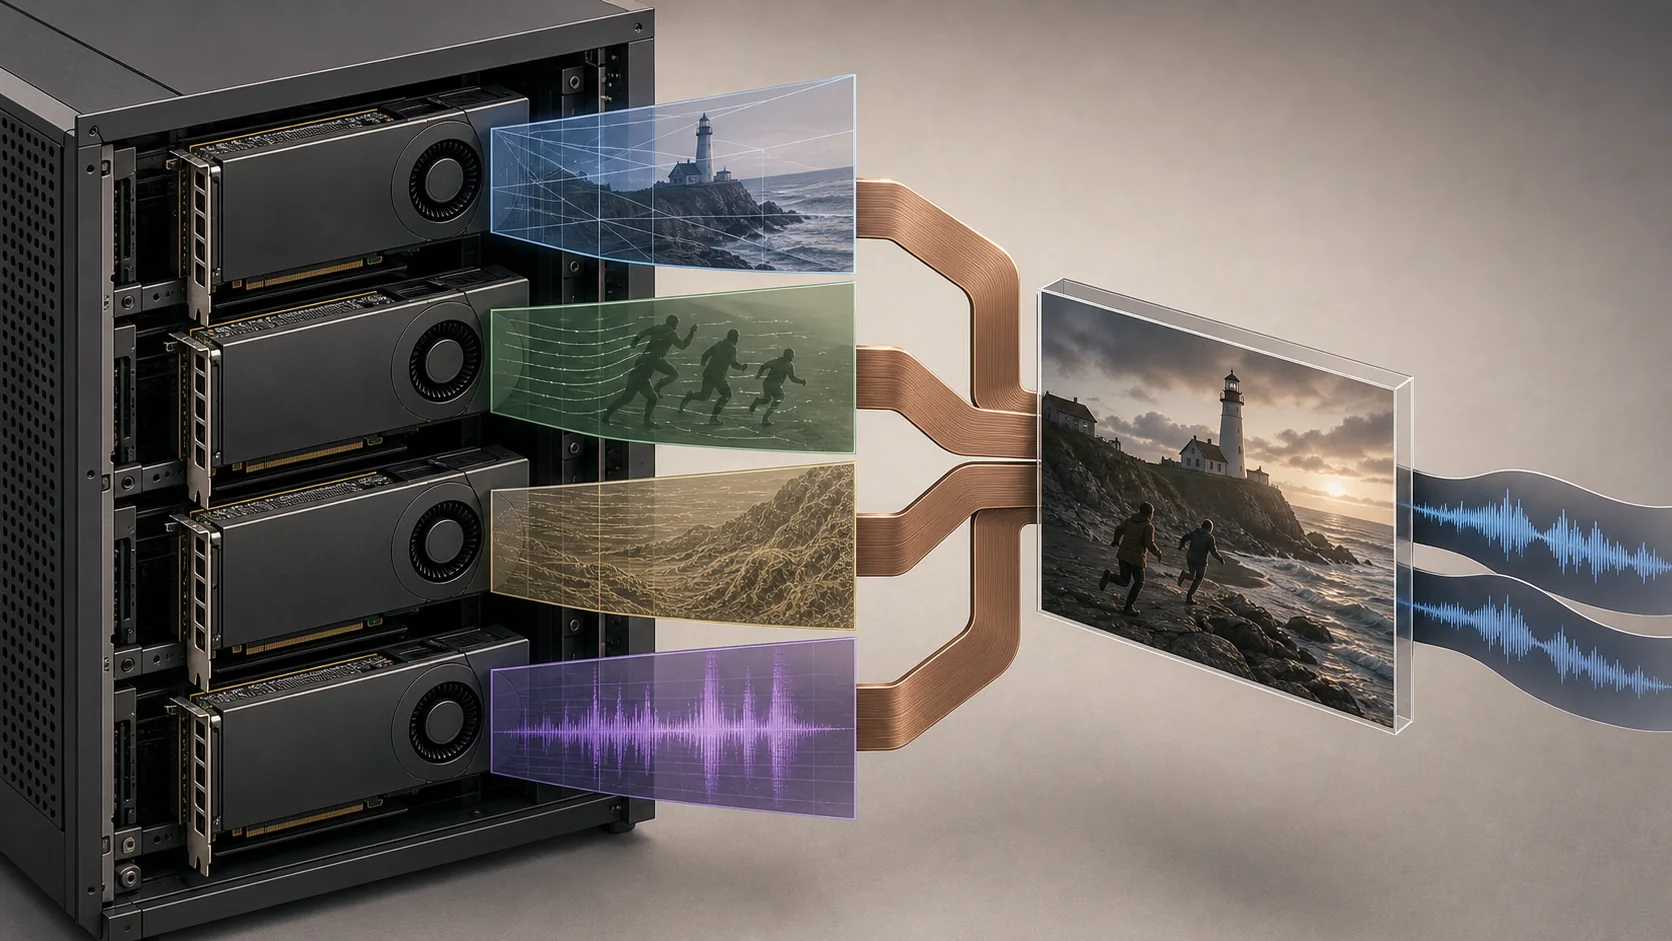
가중치 외에도 입력 사진, 영상 프레임의 중간 데이터, 해상도가 작업 메모리를 차지해요. 오프로딩3은 일부 데이터를 호스트 메모리로 옮겨 작은 VRAM4에서 실행할 여지를 만들지만, 시스템 RAM5과 전송 시간도 필요해요. 여러 GPU6 구성은 모델과 런타임7의 분할 지원까지 맞아야 하므로 메모리 용량을 단순 합산해 같은 실행 경로로 보면 안 돼요.
Wan 2.2 TI2V-5B의 공식 저장소는 1280×704 출력의 720p 경로와 24GB GPU·오프로딩 구성을 다뤄요. 작은 가중치 구성으로 시작해도 결과에서 필요한 움직임과 제품 윤곽이 유지되는지 전체 클립을 재생해 확인해요. 모델별 해상도와 프레임 규칙도 달라서 한 모델의 설정을 다른 모델에 그대로 옮기지 않아요.
LTX-2.5는 가로·세로가 32의 배수이고 프레임 수가 8n+1이어야 해요. 이 사이트의 HunyuanVideo 1.5 시간 비교는 480p 이미지→영상 증류 경로를 대상으로 해요. 이 수치는 각 모델의 입력 조건을 보여주는 예이므로 Wan 실행 설정으로 가져오지 말고, 목표 모델의 공식 조건 안에서 먼저 짧게 저장해 봐요.
T2V-14B는 텍스트로 새 장면을 만드는 선택지예요
Wan 2.2 T2V-14B는 텍스트→영상 경로라서 병 사진을 시작 입력으로 쓰는 TI2V-5B와 목표가 달라요. 사진 없이 문장으로 새 장면을 만들려는 경우 후보가 되며, 원하는 카메라 움직임과 제품 형태가 결과에 어떻게 나타나는지 확인해요.
모델이 커지면 파일 저장 공간뿐 아니라 적재와 생성 메모리도 달라져요. 프롬프트8와 장면 목표를 고정해 결과를 비교하고, 개선된 외모나 움직임이 추가 메모리와 대기를 들일 만큼 필요한지 판단해요.
H3 Turbo는 단계 수와 병렬 구성을 함께 읽어요
LightX2V의 MiniMax-H3 안내는 Turbo 4-step과 8-step 설정을 정밀도 및 GPU 병렬 방식별로 나눠요. 4-step BF169은 dmd/minimax_h3_bf16_4step.json과 단일 GPU 스크립트를 사용하고, 4-step FP8/INT8은 SP4, 8-step FP8/INT8은 SP8 구성이에요. 5090 표시가 있는 FP810 4-step 항목도 SP8 설정에 들어가므로 한 장에서 실행된다는 뜻은 아니에요.
처음 설치한다면 저장소의 모델 경로와 커널 조건에 맞춰 모델 폴더를 준비해요. 안내된 Diffusers 배치는 transformer11, text_encoder, tokenizer, processor, vae12, audio_vae 구성요소를 포함하므로 원본 FL2VA/ 체크포인트 폴더만 받는 것으로는 충분하지 않아요. 기본 BF16 경로의 출력부터 확인할 때는 아래 명령을 사용해요.
bash scripts/minimax_h3/run_minimax_h3_t2av.sh같은 입력으로 Turbo 결과와 전체 대기를 비교해요
기본 출력 파일이 열리는 것을 확인한 뒤 dmd/minimax_h3_bf16_4step.json을 복사해 실험 설정으로 사용해요. LoRA13 경로가 실제 파일을 가리키는지, alpha=128, video_flow_shift=6, audio_flow_shift=3, infer_steps=4가 공개 4-step 어댑터 설정과 맞는지 확인해요.
기본 설정은 362프레임·768×1344라서 첫 비교에서는 JSON의 num_frames와 size를 124프레임·544×960으로 조정해 부담을 낮춰요. 동적 LoRA 적용과 BF16 가중치 병합은 둘 중 한 방식만 선택해요.
프롬프트·seed·해상도·프레임 수를 고정하고 기본 설정과 Turbo 출력 파일을 각각 저장해요. 모델 로드와 워밍업을 포함한 첫 실행 시간, 준비 후 반복 생성 시간, 파일 저장까지의 시간을 따로 적으면 실제 작업 대기를 비교할 수 있어요. README에는 같은 환경에서 두 preset을 비교한 소비자 GPU FPS14 자료가 없으므로 4 step을 이유로 특정 속도 배수를 계산하지 않아요.
화면이 검거나 오디오가 나오지 않으면 요청 task와 시작 시 --model-variant fl2av 설정, 모델 구성 폴더, LoRA 파일 경로를 먼저 살펴봐요. 로그의 VAE·encoder 오류를 확인하면 출력 경로 문제와 모델 적재 문제를 나눠 볼 수 있어요.
H3-Base 공개 시간은 정해진 서버 조건의 기록이에요
LightX2V의 H3-Base 시간 자료는 SGLang FL2VA의 BF16/FP32·TP2 오프로딩 경로, RTX 5090 두 장, 호스트 RAM 384GB 조건이에요. GPU 두 장만 같다고 같은 시간이 나오는 것은 아니며 오프로딩 방식과 호스트 메모리도 구성에 포함돼요.
측정 장면은 오디오가 포함된 768p·5초 출력이에요. 5단계와 50단계 실행 기록이 있고, 일반 설정으로 언급된 20단계 시간은 두 측정 사이의 보간값이에요. 따라서 이를 별도 실측으로 취급하지 않고 다른 영상 길이나 RAM 구성에도 외삽하지 않아요.
공개 시간은 문맥 해석과 2K 재생성 단계를 포함하지 않아요. 영상과 소리를 한 파일로 얻는 편의가 필요한지, 무음 클립에 편집기에서 원하는 트랙을 붙일지 정할 때 참고하고, 결과의 시각 품질과 오디오 적합성은 직접 재생해 판단해요.
목표 컷을 지원하는 실제 경로로 결정해요
병 사진을 유지해야 하면 이미지 입력을 받는 TI2V 경로, 텍스트로 새 장면을 만들면 T2V-14B, 영상과 소리를 한 번에 얻어야 하면 H3-Base의 결합 출력을 비교해요. 이는 크기 순위가 아니라 입력과 필요한 결과가 맞는지의 선택이에요.
사이트에서 재생되는 영상은 실제 모델 결과가 아니라 장비별 예상 대기 차이를 보여주는 준비된 샘플이에요. 설치할 경로에서 모델과 사진 입력, 필요한 길이·해상도가 지원되는지 확인하고 짧은 파일을 저장해 처음부터 끝까지 재생해요. 반복 수정이 많다면 생성 대기뿐 아니라 첫 실행, 메모리 여유, 편집 시간도 작업 시간에 넣어요.
현재 장비에서 목표 컷이 끝까지 재생되고 필요한 오디오도 맞으며 반복 대기가 감당할 만하면 현재 구성으로 시작할 수 있어요. 새 장비를 볼 때는 모델·정밀도·해상도·길이·오프로딩 조건이 함께 공개된 실행 기록을 비교해요. 조건이 다른 공개 시간은 참고 자료로 두고 내 작업의 예상치로 바꾸지 않아요.
용어 각주
체크포인트 — 학습된 모델의 가중치 등을 저장한 파일입니다. 같은 모델 계열도 버전이나 용도에 따라 다른 체크포인트를 쓸 수 있습니다.
본문으로 돌아가기프레임 — 영상의 한 장면을 이루는 단일 이미지입니다.
본문으로 돌아가기오프로딩 — 메모리가 부족할 때 모델 데이터 일부를 GPU 메모리에서 시스템 RAM이나 저장장치로 옮겨 처리하는 방식입니다. 데이터 이동이 추가됩니다.
본문으로 돌아가기VRAM — 그래픽카드의 GPU가 사용하는 메모리입니다. 모델 가중치와 계산 중간값을 저장합니다.
본문으로 돌아가기시스템 RAM — 프로그램이 실행되는 동안 데이터를 임시로 보관하는 시스템 메모리입니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기프롬프트 — 모델에 보내는 입력문입니다. 생성 모델에서는 만들 결과를 설명하는 문장이 되어 출력의 구성과 내용을 크게 좌우합니다.
본문으로 돌아가기BF16 — 모델 수치를 저장하고 계산하는 16비트 부동소수점 형식입니다. FP32와 같은 폭의 지수부를 써 넓은 값 범위를 표현합니다.
본문으로 돌아가기FP8 — 값 하나를 8비트로 표현하는 부동소수점 수치 형식입니다.
본문으로 돌아가기트랜스포머 — Attention을 중심으로 입력 안의 관계를 계산하는 신경망 구조입니다. 언어 모델을 비롯해 이미지, 음성, 영상 모델에도 사용됩니다.
본문으로 돌아가기VAE — Variational Autoencoder의 약자입니다. 입력을 압축된 잠재 표현으로 바꾸거나, 그 표현에서 결과를 복원하는 데 쓰입니다.
본문으로 돌아가기LoRA — 기본 모델의 동작을 조정하는 작은 추가 가중치를 학습·적용하는 방식입니다. 기본 모델에 어댑터를 함께 적용하며, 스타일 조정이나 적은 단계의 생성 등에 쓰입니다.
본문으로 돌아가기FPS — 초당 프레임 수입니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- Wan 2.2 TI2V-5B는 사진에서 영상을 시작하고, T2V-14B는 문장으로 새 장면을 만들며, MiniMax H3-Base는 영상과 스테레오 오디오를 함께 출력해요. 먼저 결과물에 필요한 입력과 소리를 정한 뒤, 모델별 해상도·메모리·실행 경로에 맞춰 짧게 시험해요.
- 필요한 메모리는 어느 정도인가요?
- 가중치 외에도 입력 사진, 영상 프레임의 중간 데이터, 해상도가 작업 메모리를 차지해요. 오프로딩은 일부 데이터를 호스트 메모리로 옮겨 작은 VRAM에서 실행할 여지를 만들지만, 시스템 RAM과 전송 시간도 필요해요. 여러 GPU 구성은 모델과 런타임의 분할 지원까지 맞아야 하므로 메모리 용량을 단순 합산해 같은 실행 경로로 보면 안 돼요.