
画像・動画生成
最終更新
Wan 2.2とMiniMax、ローカル動画生成の選び方
動画・音声・画像入力に合わせてWan・MiniMaxの経路を選びます
Wan 2.2 TI2V-5Bは画像から動画を始め、T2V-14Bは文章から新しい場面を作り、MiniMax H3-Baseは動画とステレオ音声を同時に出力します。必要な入力と音声を先に決め、各モデルの解像度・メモリ・実行経路に合わせて短く試します。
参照写真の形を保った短い製品紹介動画を作り、必要なら場面に合う音声も付けたいとします。写真から動画を作るには画像入力を受けるTI2V経路が必要で、文章から新しい場面を作る用途にはT2V経路が合います。動画と音声を一度に出力する必要がある場合は、H3-Baseのように同時出力に対応するモデルを検討します。
3つの経路は入力と計算方法が異なるため、モデル名やパラメータ数だけでは比較できません。まず必要な出力から候補を絞り、LightX2VのH3 Turbo公開設定とWan系モデルのメモリ・解像度条件の読み方を説明します。
動画だけか場面内の音声も必要かを決めます
製品写真を動かす5秒の紹介動画を作るなら、まず音も同時に生成するか決めます。MiniMax H3-Baseは動画とステレオ音声を一緒に出力します。無音のクリップでよければWanの動画生成を使い、編集ソフトで効果音や音楽を加えられます。
同時出力は無音動画を作ってから音楽を加える作業とは計算経路が異なります。モデルの出力が編集工程に合うか確認し、動画と音声を一緒に保存した場合は再生してタイミングや場面との相性を見ます。
画像や最初・最後のフレームを入力できるか確認します
モデルサイズだけでなく出力条件とメモリ配置を見ます
重みに加えて入力画像、動画フレームの中間データ、解像度も作業メモリを使います。offload3は一部データをhost memoryへ移し、VRAM4が少ない構成でも実行できる余地を作りますが、システムRAM5と転送時間も必要です。複数GPU6構成にはモデルとruntime7の分割対応が必要なため、メモリ容量を単純に合算して同じ実行経路とみなすことはできません。
Wan 2.2 TI2V-5Bの公式リポジトリは1280×704出力の720p経路と、24GB GPU・offload構成を扱っています。重みの小さい構成から始めても、必要な動きと製品の輪郭が保たれるか動画全体を再生して確認します。解像度とフレーム条件はモデルごとに異なるため、あるモデルの設定を別モデルへそのまま適用しません。
LTX-2.5は幅・高さが32の倍数で、フレーム数は8n+1である必要があります。このサイトのHunyuanVideo 1.5時間比較は480pの画像から動画へのdistillation経路が対象です。これらは各モデル固有の入力条件を示す例なので、Wanの設定として使わず、対象モデルの公式条件内で短い出力を保存します。
T2V-14Bは文章から新しい場面を作る選択肢です
Wan 2.2 T2V-14Bはtext-to-video経路で、ボトル写真を入力にするTI2V-5Bとは目的が異なります。参照画像なしで文章から新しい場面を作りたい場合の候補です。希望するカメラ動作や製品に似た形が出力にどう現れるか確認します。
モデルが大きくなると保存容量だけでなく読み込み・生成メモリも変わります。prompt8と場面の目標を固定して結果を比べ、外見や動きの改善が追加メモリと待ち時間に見合うか判断します。
H3 Turboはstep数と並列構成を合わせて確認します
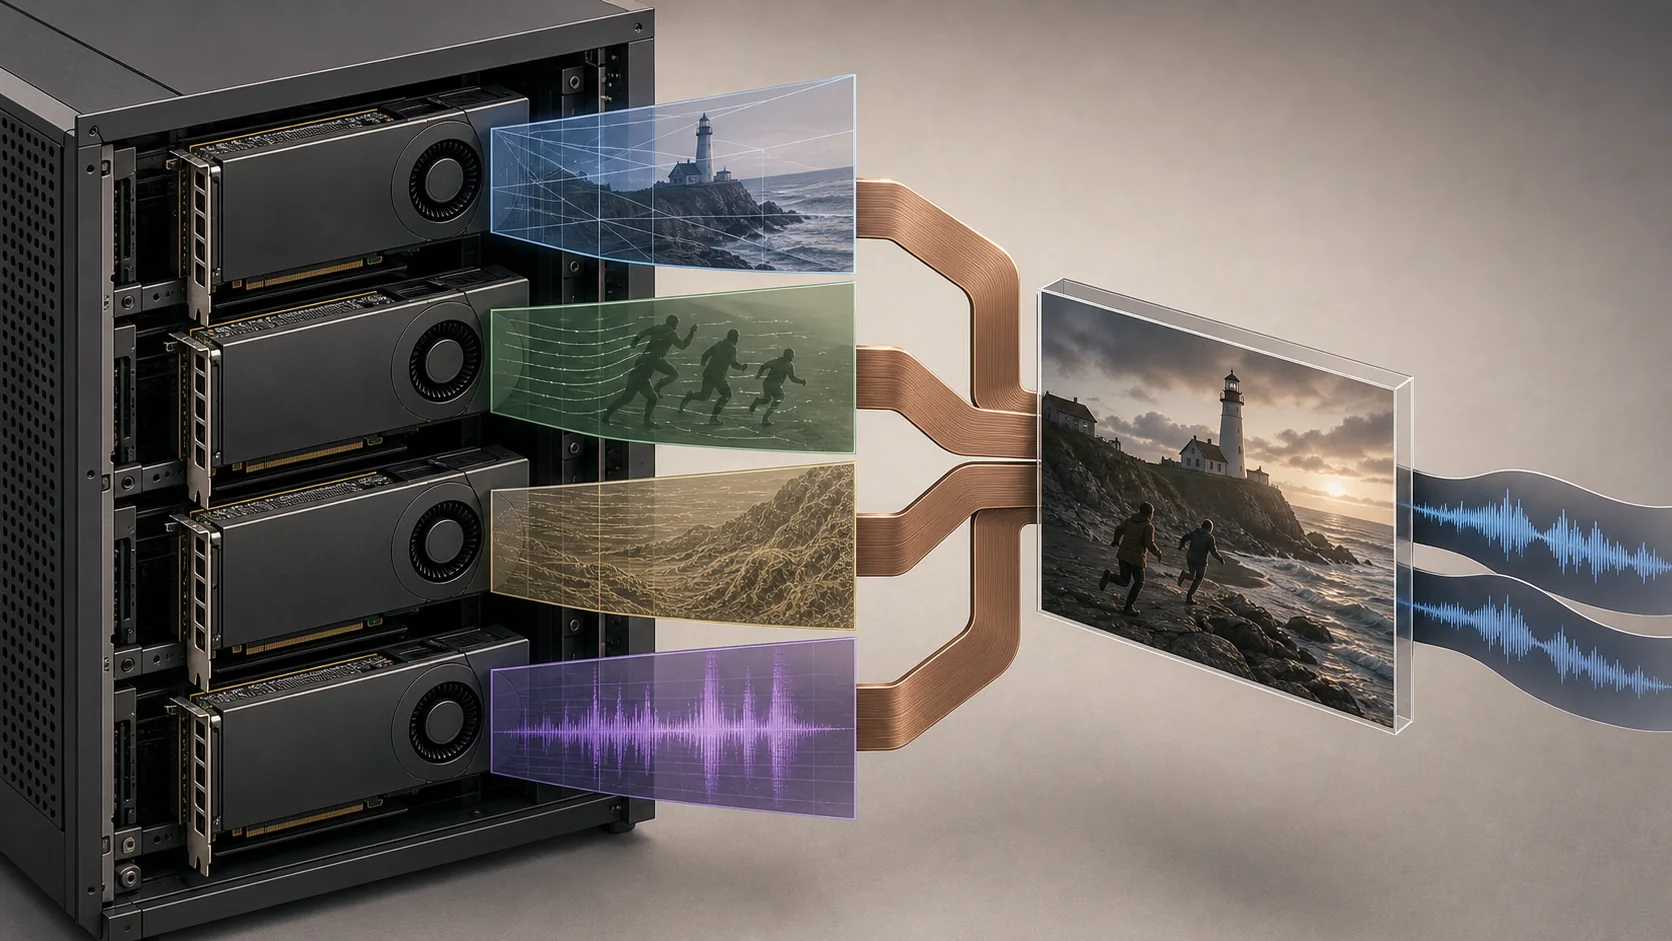
LightX2VのMiniMax-H3資料はTurbo 4-step・8-step設定を精度とGPU並列方式で分けています。4-step BF169はdmd/minimax_h3_bf16_4step.jsonと単一GPUスクリプトを使い、4-step FP8/INT8はSP4、8-step FP8/INT8はSP8です。5090表記のあるFP810 4-step項目もSP8構成であり、1基で動く意味ではありません。
初回導入ではリポジトリのモデルパスとkernel要件に合わせてモデルフォルダーを用意します。案内されているDiffusers配置にはtransformer11、text_encoder、tokenizer、processor、vae12、audio_vaeが含まれるため、元のFL2VA/ checkpointフォルダーだけでは足りません。基本BF16経路の出力確認には次のコマンドを使います。
bash scripts/minimax_h3/run_minimax_h3_t2av.sh同じ入力でTurboを比較し全体の待ち時間を測ります
基本出力ファイルが開くことを確認したら、dmd/minimax_h3_bf16_4step.jsonを複製して実験設定にします。LoRA13パスが実ファイルを指すこと、alpha=128、video_flow_shift=6、audio_flow_shift=3、infer_steps=4が公開4-step adapter設定と一致することを確認します。
標準設定は362フレーム・768×1344なので、最初の比較ではJSONのnum_framesとsizeを124フレーム・544×960へ下げます。動的LoRA適用とBF16重みへの統合はどちらか一方を選びます。
prompt・seed・解像度・フレーム数を固定し、基本設定とTurboの出力を別々に保存します。モデル読み込みとwarm-upを含む初回時間、準備後の反復生成時間、ファイル保存までの時間を分けて記録すると、実作業の待ち時間を比較できます。READMEには同一条件で2つのpresetを比較したコンシューマーGPUのFPS14資料がないため、4 stepから速度倍率を推定しません。
画面が黒い、または音声が出ない場合は、要求task、起動時の--model-variant fl2av設定、モデル構成フォルダー、LoRAパスを確認します。ログのVAE・encoderエラーを見れば、出力経路の問題とモデル読み込みの問題を切り分けられます。
H3-Baseの公開時間は特定サーバー構成での記録です
LightX2VのH3-Base時間資料はSGLang FL2VAのBF16/FP32・TP2 offload経路、RTX 5090 2枚、host RAM 384GBの条件です。GPU 2枚だけを合わせても同じ時間にはならず、offload方式とhost memoryも構成に含まれます。
測定対象は音声付き768p・5秒出力です。5-stepと50-stepの実行記録があり、標準設定として示された20-stepの時間は2つの測定値間の補間です。独立した実測値ではなく、別の動画長やRAM構成に外挿しません。
公開時間にはprompt解釈と2K再生成の工程は含まれません。動画と音声を一緒に得る利便性が必要か、無音クリップに編集ソフトで希望のtrackを加えるかを決める参考にし、映像品質と音声の適合性は再生して判断します。
必要なカットに対応する実行経路を選びます
ボトル写真を保つ必要があれば画像入力のTI2V経路、文章から新しい場面を作るならT2V-14B、動画と音声を同時に得るならH3-Baseの同時出力を比較します。これはサイズ順位ではなく、入力と必要な結果を合わせる選択です。
サイトで再生される動画は実モデルの出力ではなく、機器ごとの待ち時間の目安を示す用意済みサンプルです。導入予定の経路がモデル、画像入力、必要な長さと解像度に対応するか確認し、短いファイルを保存して最初から最後まで再生します。修正を繰り返す場合は生成待ちだけでなく初回時間、メモリ余裕、編集時間も作業時間に含めます。
目標の動画が現在の機器で最後まで再生でき、必要な音声も合い、繰り返しの待ち時間を許容できるなら今の構成から始められます。新しい機器を検討する際はモデル・精度・解像度・長さ・offload条件が明記された実行記録を比較します。異なる条件の公開時間は参考にとどめ、自分の作業の予測値に置き換えません。
用語の注釈
チェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るフレーム — 動画を構成する1枚の画像です。
本文に戻るオフロード — 容量が足りないとき、モデルデータの一部をGPUメモリからシステムRAMやストレージへ移して処理する方法です。データ転送が追加されます。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るシステムRAM — プログラムの実行中にデータを一時保存するシステムメモリです。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るBF16 — モデルの数値に使う16ビット浮動小数点形式です。指数部はFP32と同じ幅で、同程度に広い値の範囲を表せます。
本文に戻るFP8 — 一つの値を8ビットで表す浮動小数点形式です。
本文に戻るTransformer — 入力内の関係をAttentionを中心に計算するニューラルネットワーク構造です。言語のほか、画像・音声・動画モデルにも使われます。
本文に戻るVAE — Variational Autoencoderの略です。入力を圧縮した潜在表現に変換したり、その表現から出力を復元したりします。
本文に戻るLoRA — 基本モデルの動作を調整する小さな追加の重みを学習・適用する方法です。基本モデルとアダプターを組み合わせ、画風の調整や少ないステップでの生成などに使います。
本文に戻るFPS — 1秒あたりのフレーム数です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Wan 2.2 TI2V-5Bは画像から動画を始め、T2V-14Bは文章から新しい場面を作り、MiniMax H3-Baseは動画とステレオ音声を同時に出力します。必要な入力と音声を先に決め、各モデルの解像度・メモリ・実行経路に合わせて短く試します。
- 必要なメモリはどのくらいですか?
- 重みに加えて入力画像、動画フレームの中間データ、解像度も作業メモリを使います。offloadは一部データをhost memoryへ移し、VRAMが少ない構成でも実行できる余地を作りますが、システムRAMと転送時間も必要です。複数GPU構成にはモデルとruntimeの分割対応が必要なため、メモリ容量を単純に合算して同じ実行経路とみなすことはできません。