
画像・動画生成
最終更新
FLUXとQwen Image、作りたいものからモデルを選ぶ
ポスター制作では背景・写真編集・文字を分けて画像モデルを選びます
FLUXとQwenの画像モデルは文章から新しい画像を作り、一部の実行経路では参照画像を受け取って編集結果も作ります。カフェのポスターなら背景案、店舗写真の維持、正確なイベント文言を別の作業として捉え、アプリとモデルファイルが必要な入力に対応するか確認します。
背景案を素早く複数作るのか、元写真の構図を保つのか、イベントの文字を正確に入れるのかで必要な機能と選び方が変わります。まず成功条件を決め、同じ入力で結果を比べ、文字は公開前に編集ソフトで校正します。
ポスターで新しく作る部分と残す部分を決めます
たとえばカフェの窓辺やテーブルを残し、夜のイベントの雰囲気を加えたポスターを作れます。背景だけを生成すること、元写真を参照して場面を編集すること、イベント文言を正確に配置することでは成功基準が異なります。
写真の形を保つことが重要なら、選んだ配布ファイルとアプリが画像入力・編集に実際に対応するか先に確認します。新しい背景だけが必要なら、案の雰囲気と待ち時間を比べます。文言を正確にする必要がある場合は、生成文字を最終版にせずデザインツールへ直接入力する方法も検討してください。
FLUX.2のvariantとQwen-Image群では、ファイル形式や容量、入力条件、アプリ対応が異なる場合があります。正確な配布版、必要なtext encoder・VAE1、編集workflowへの対応を確認すると、出力されない原因を切り分けやすくなります。
背景と文言を分けて作ると校正しやすくなります
最初の案ではカフェの窓辺の夕景と文字を置く余白を作ります。背景を決めたらイベントの日付とメニュー名をデザインツールで入力すると、数字や綴りを直すために背景を再生成せずに済みます。
モデルが文言も描いた場合は、実際のポスターサイズで文字の形、配置、余白を確認します。文字や数字が一つ違えばイベント案内として使いにくいため、最終文言を人が読み、小さな画面や印刷サイズでも判読できるか確認してください。比較では生成時間だけでなく、使える案までの再生成回数と後処理時間も記録します。
ワークフローと出力を一緒に確認する
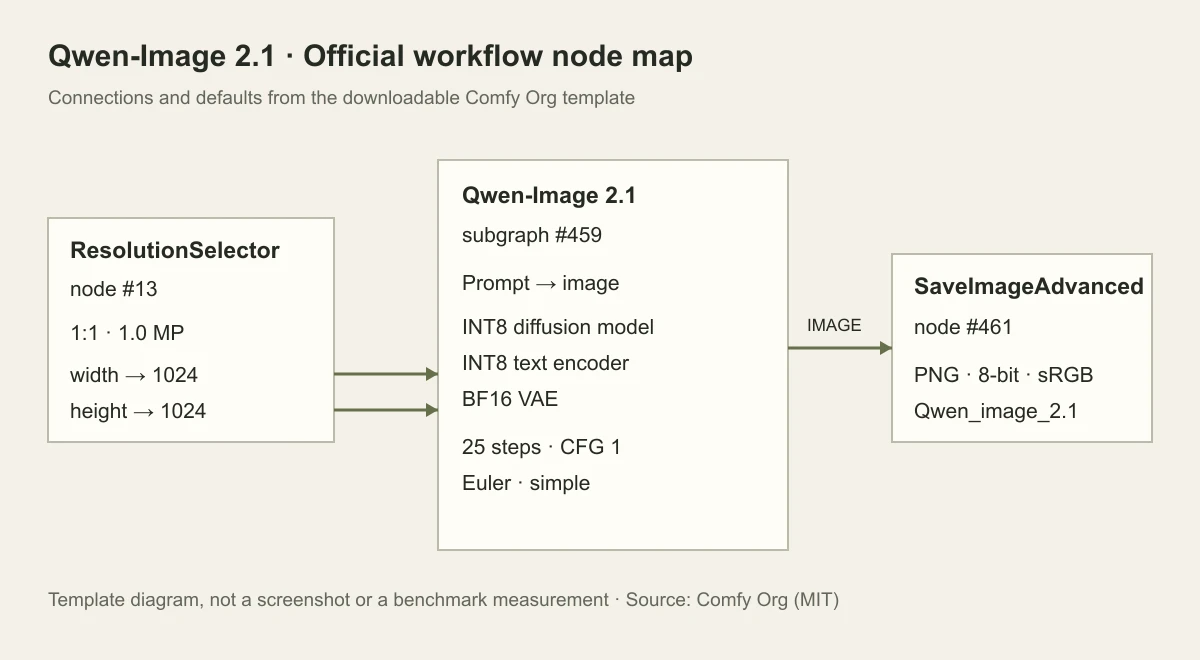
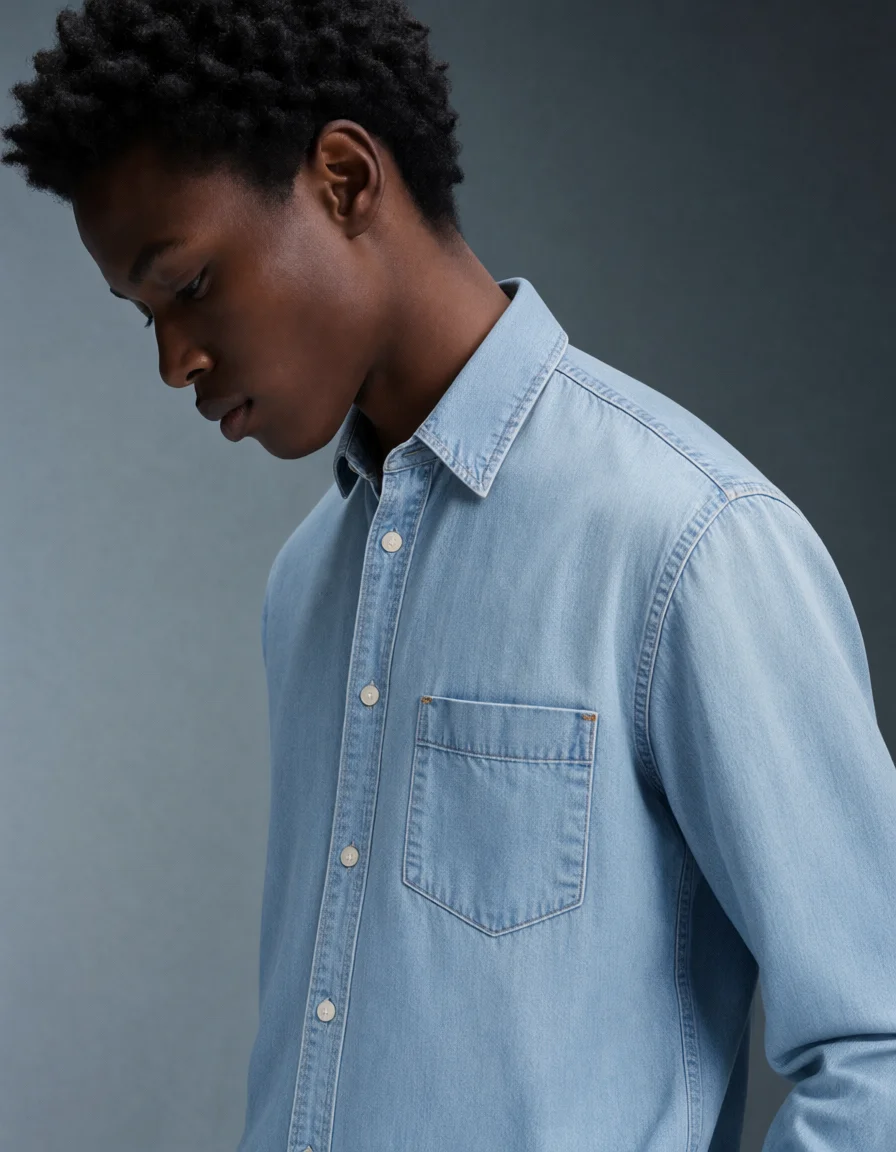
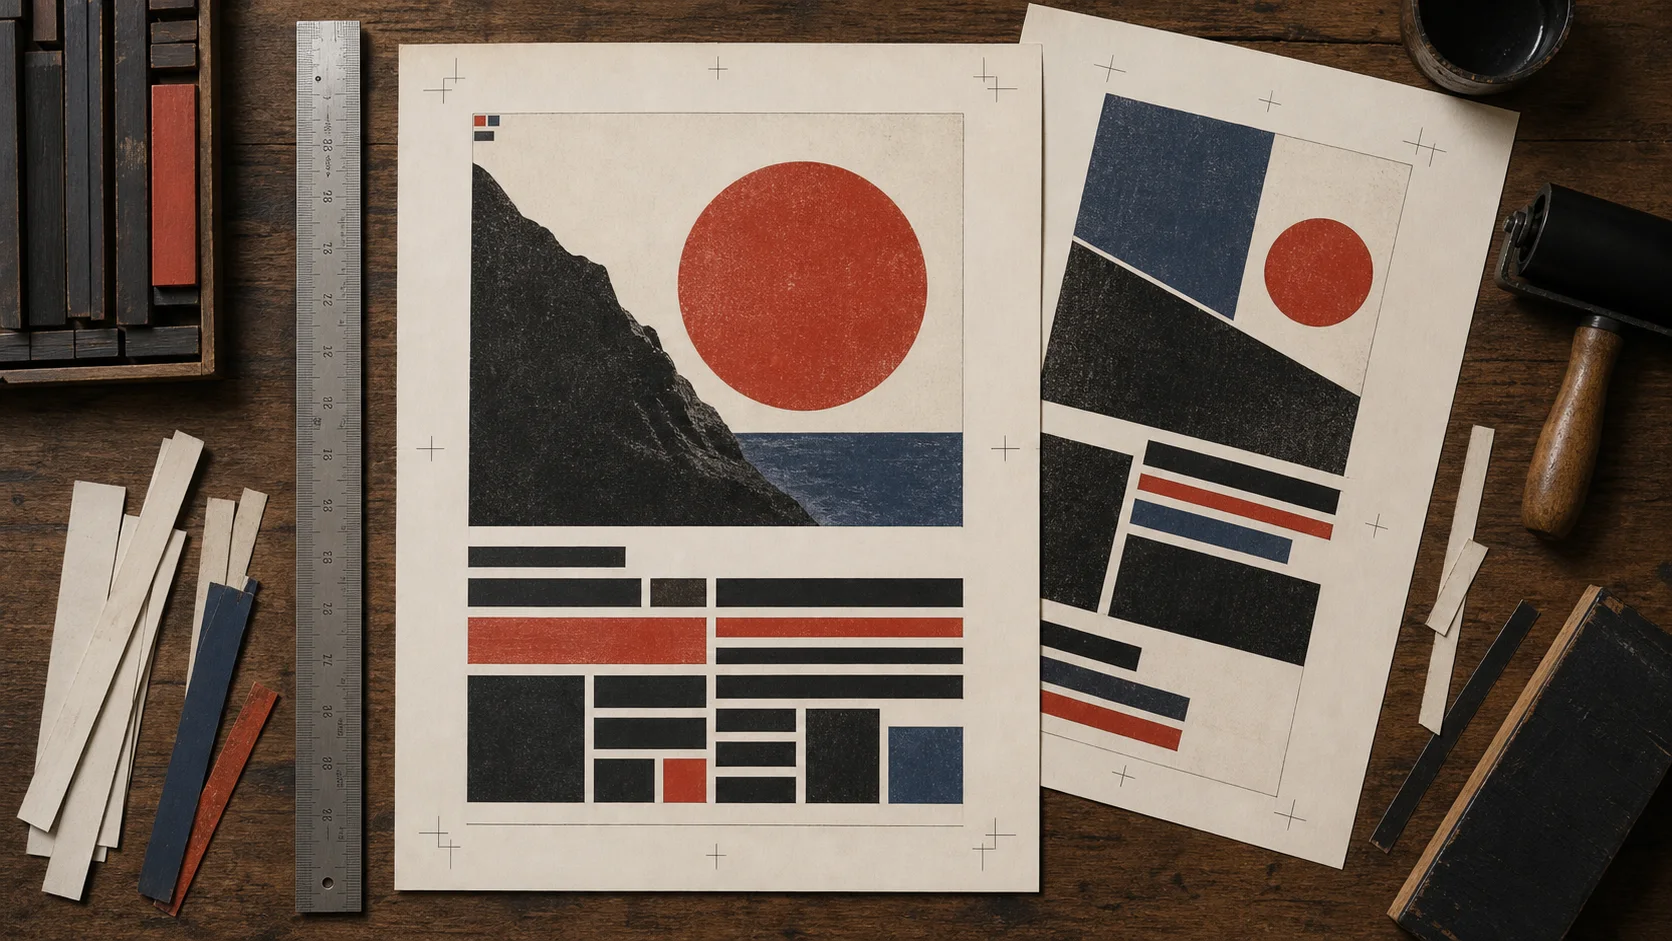
Comfy Orgが公開したQwen-Image 2.1の作例です。このサイトで生成・速度測定した結果ではありません。
編集前
編集後
参照写真の編集では残す要素を決めてから比較します
カフェの窓辺の写真を参照にする場合、照明や装飾のどこを変えてよいか、看板や家具のどれを残すか決めます。結果を元写真と同じサイズで並べ、テーブルの縁、窓枠、ロゴの位置を確認すると、雰囲気が似ていることと細部が保たれていることを区別できます。
参照画像を使う編集は、テキストから空の場面を作るのとは異なる入力作業です。モデルファイルとアプリが画像入力やmask編集に対応するか確認してください。対応しない場合は、生成結果を背景として使い、元のロゴや文言を編集ソフトで配置し直す方法を検討します。
元画像と生成画像を比べ、背景の照明だけが変わったか、テーブルや窓の構造も変わったか記録します。長いprompt2だけで形状の維持を期待せず、参照強度やmaskなどの編集入力がアプリで実際に使えるか確認してください。
FLUXとQwenは必要な入力と結果で比較します
FLUX.2 Kleinは素早い案や比較的軽い編集をしたい場合の候補です。FLUX.2 Devはファイル容量と実行条件が合うか確認してから比べます。Qwen-Image-2512は文字と場面表現を評価する候補ですが、イベント文言が常に正確だと想定せず、公開前に校正してください。
Qwen-Image 2.1は編集とRGBA作業を統合していますが、research licenseが適用されます。Qwen-Image-2512と同じファイルや構造だと考えず、専用VAE・encoderの組み合わせ、アプリ対応、予定する利用がlicenseに適合するか確認してください。
案を作るモデルを替えると同じ構図や色が維持されるとは限らないため、新しい候補を再生成して選ぶ時間も比較に含めます。頻繁にモデルを切り替えると読み込み待ちが繰り返されますが、先に背景を選んでから編集ソフトへ移るなら、必要なモデルだけ順に読み込めます。
ポスターを仕上げる時間と利用権を確認します
同じ店舗写真、文言、出力サイズ、1枚生成の条件をそろえて候補を比べます。毎回モデルを読み直すか、読み込んだまま次を作るか記録し、最初の候補までの時間、使える構図を選ぶまでの修正回数、文字の配置と校正時間を分けて記録してください。これで1回の生成速度とポスター完成までの時間を区別できます。
サイトの時間比較は掲載された実行条件での推定待ち時間であり、自分の写真とpromptから使える結果が出る可能性を計算するものではありません。背景案だけで足りるなら軽い候補を使い、写真の維持が重要なら画像入力に対応する経路を実際に確認します。公開前にmodel repositoryで正確なvariantのlicenseと条件を読み、参照写真内の人物・ロゴ・著作物の権利も別に確認してください。ローカル実行によって商用利用権が付与されるわけではありません。
新しいモデルは作業と実行経路で選ぶ
モデル名より先に作業を決めます。ComfyUIで最初の1枚を作るならFLUX.3 Klein distilledテンプレート、8ステップ生成ならZ-Image-Turboの公式Diffusers経路を使います。参照編集ではアプリがそのモデルの編集機能を備えるか確認します。baseとdistilledはステップ数や資源が異なるため、同じ速度表で比較しません。
公表時間は実行環境ごとに扱う
公表されたFLUX.3 Klein GPU3表は、1024×1024、distilled 16 steps、1枚の条件でRTX 5090約4秒、RTX 4070は9秒未満と示しています。ComfyUIテンプレートは15 stepsが標準で、プロンプトアップサンプラーも別設定なので、表の数値を標準テンプレートの時間に転記しません。API4応答時間は別の指標です。FLUX.3 Klein公表時間
用語の注釈
よくある質問
- この記事で最初に確認すべきことは何ですか?
- FLUXとQwenの画像モデルは文章から新しい画像を作り、一部の実行経路では参照画像を受け取って編集結果も作ります。カフェのポスターなら背景案、店舗写真の維持、正確なイベント文言を別の作業として捉え、アプリとモデルファイルが必要な入力に対応するか確認します。
- 条件と出典はどこで確認できますか?
- Qwen-Image 2.1は編集とRGBA作業を統合していますが、research licenseが適用されます。Qwen-Image-2512と同じファイルや構造だと考えず、専用VAE・encoderの組み合わせ、アプリ対応、予定する利用がlicenseに適合するか確認してください。