
실행 프로그램과 확장
최종 업데이트
CMP 170HX, 채굴용 카드로 64GB 로컬 LLM을 돌릴 수 있을까?
64GB 메모리를 활용하려면 Linux 드라이버와 냉각부터 준비하세요.
CMP 170HX는 NVIDIA GA100-105F GPU1와 HBM2e를 탑재한 채굴용 가속기예요. Linux에서 프롬프트2를 보내면 로컬 실행 프로그램3이 GPU 메모리에 올린 모델로 입력을 처리하고 답변을 생성합니다. cmpunlocker의 메모리 프로필과 GA100에 맞는 실행 경로를 갖추면 로컬 LLM4에 활용할 수 있어요.
큰 메모리가 필요한 모델을 비교할 때 눈여겨볼 카드예요. 먼저 카드의 랭크와 Linux 환경, 냉각 준비를 확인하고 Qwen3.8 실행 기록까지 살펴보세요.
연산 형식과 작업 메모리를 함께 맞춰요
같은 CMP 170HX 이름 아래 메모리 구성이 다릅니다
CMP 170HX는 카드의 메모리 랭크에 따라 해제 후 용량이 달라요. 8GB 듀얼랭크 카드는 64GB, 일부 8GB 싱글랭크 카드는 32GB, 10GB 카드는 40GB로 구성돼요. 랭크는 메모리 칩이 묶인 구성을 말해요. 구매 전 출고 용량과 랭크를 함께 확인해요.
설치 프로그램은 카드 정보를 바탕으로 프로필을 자동 감지합니다. 수동으로 프로필을 바꾸려면 카드의 메모리 랭크와 유지보수자 안내를 먼저 대조하고, 재부팅 뒤 실제 표시 용량을 다음 모델 선택 기준으로 삼으세요.
| 카드 출고 구성 | 프로필 적용 뒤 | 확인할 점 |
|---|---|---|
| 일부 8GB 카드 | 최대 64GB 구성 | 일부 단일 랭크 카드는 32GB일 수 있음 |
| 10GB 카드 | 40GB 구성 | README와 카드 식별 정보를 대조 |

설치 전에는 OS와 드라이버 조건부터 맞춰요
cmpunlocker는 일반 사용 앱이 아니라 Linux 커널의 NVIDIA 오픈 GPU 커널10 모듈을 패치해 메모리 구성을 바꾸는 도구예요. 유지보수자가 적어 둔 요구 사항은 Linux x86-64, 관리자 권한, NVIDIA CMP 170HX, 현재 지원 범위에 맞는 nvidia-open 610.xx.xx 이상과 해당 드라이버의 라이브러리·펌웨어, 실행 중인 커널과 일치하는 헤더예요. 첫 빌드에는 네트워크가 필요하고, Secure Boot는 서명되지 않은 모듈을 막지 않도록 꺼야 해요.
드라이버의 세부 버전은 README가 지원 대상으로 든 버전과 배포판에서 제공하는 패키지를 대조해 선택해요. 유지보수자 README에는 615.78.08도 적혀 있어요. 드라이버를 업데이트하면 패치된 모듈을 새 버전에 맞춰 다시 빌드해야 할 수 있어요. 카드를 사용하는 Linux 시스템에 설치하는 절차는 메모리 해제 시작 가이드에서 프로필 확인과 제거까지 따라갈 수 있어요.
64GB 메모리로 어떤 모델을 실행할 수 있을까요?
각 메모리 구성은 모델 가중치, 런타임 작업 공간, KV 캐시가 나눠 쓰는 예산이에요. 모델을 선택할 때 런타임의 요구 메모리와 입력 문맥을 함께 계산해요. 32GB 또는 40GB 카드에서는 더 낮은 양자화나 짧은 문맥 설정으로 조정할 수 있어요.
실행 속도는 모델, 양자화, HBM 클럭, PCIe 링크, 엔진과 디코드11 설정에 따라 달라집니다. 같은 보드 번호로 판매된 카드도 VBIOS와 HBM 클럭이 다를 수 있어요. PixelML은 64GiB·74 SM·HBM 1728MHz·PCIe Gen2 x16·180W·강제 송풍 조건으로 Qwen3.8-27B 한 장 실행을 기록했어요. vLLM과 open-jet 결과 및 입력 길이별 수치는 측정 조건과 결과에서 확인할 수 있어요.
| 인식 용량 | 모델 구성에 주는 여유 | 먼저 확인할 항목 |
|---|---|---|
| 32GB | 가중치·작업 공간·문맥을 위한 여유가 가장 작음 | 양자화 파일 크기와 문맥 길이 |
| 40GB | 중간 규모 모델에 더 여유가 있지만 버퍼가 필요 | 10GB 카드 프로필과 런타임 지원 형식 |
| 64GB | 가중치와 긴 문맥을 함께 둘 여지가 넓음 | 8GB 카드의 랭크 구성과 적용 프로필 |
드라이버가 보여 주는 숫자와 실제 사용을 함께 살펴요
언락이 끝나 재부팅한 뒤에는 먼저 nvidia-smi에서 GPU 이름, 메모리 총량, 드라이버 버전을 확인하고, nvidia-smi -q -d PCI에서 링크 세대와 폭을 살펴보세요. 8GB 카드에 64GB 프로필을 썼다고 기대했는데 표시가 32GB라면, 랭크 구성이 지원되는지와 설치 시 자동 감지된 프로필을 먼저 확인합니다. 모델을 시험할 때는 메모리 적재가 끝났는지, 입력을 보낸 뒤 첫 토큰12이 나오는지, 긴 문맥에서도 요청이 끝나는지 순서대로 봅니다.
링크가 Gen1로만 잡히면 카드, 슬롯, 라이저, BIOS 설정과 보드 한계를 확인해야 해요. PixelML 자료에서는 Gen2 동작을 시험했지만 Gen3는 네 장 모두에서 퓨즈로 막힌 것으로 기록했어요. 보드에 따라 x4 또는 x16 링크일 수도 있으니, Gen2 적용 뒤에도 실제 링크 폭을 확인해요.
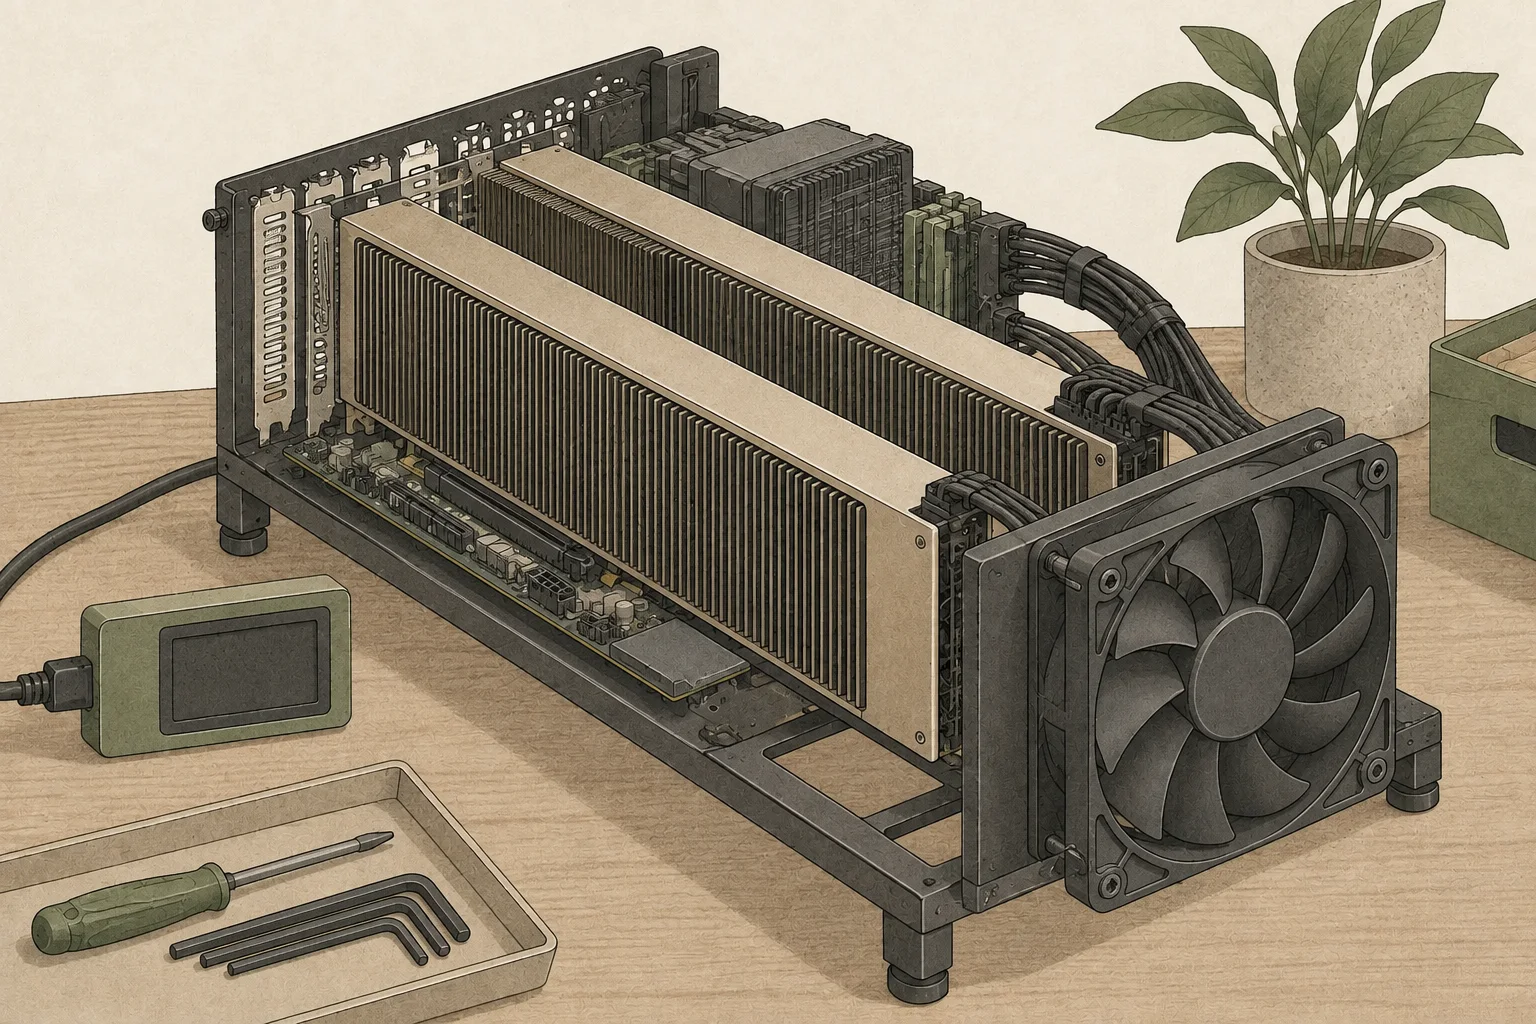
팬이 없는 카드에는 외부 팬이 필요해요
CMP 170HX는 팬이 달리지 않은 패시브 방열판을 사용해요. 방열판 안으로 바람이 통과하도록 블로어 팬이나 덕트 팬을 배치하세요. 모델을 적재하고 연속 요청을 보내면서 GPU 코어와 메모리 온도, 클럭이 안정적으로 유지되는지 확인하면 냉각 상태를 판단할 수 있어요.
전력 제한을 낮추면 발열을 줄이는 데 도움이 돼요. 팬과 공기 흐름을 먼저 확보한 뒤, 같은 작업으로 속도와 온도를 비교하며 상한을 조정하세요. 공개 Qwen 한 장 시험의 180W 실행 결과와 네 장 GLM 시험의 전력별 처리량13은 전력·냉각 가이드에 정리했어요.
한 장에서 시작해 실제 사용 조건으로 판단해요
모델을 고를 때는 양자화 파일, 메모리 총량, 문맥 길이와 런타임의 GA100 지원 여부를 먼저 확인해요. 그다음 평소 넣을 입력과 비슷한 문서를 보내고, 첫 토큰까지 걸린 시간과 출력 속도, 전체 완료 여부를 따로 기록하세요. 카드가 64GB로 인식되어도 입력 길이가 커질 때 KV 캐시가 더해지고, 일부 엔진은 모델 구조에 맞는 커널을 따로 요구할 수 있어요.
구성은 nvidia-smi에 표시되는 실제 메모리, GA100을 지원하는 런타임, 사용할 양자화와 문맥 길이로 정하세요. Linux 드라이버와 커널 모듈 관리, 강한 공기 흐름까지 준비할 수 있다면 CMP 170HX 한 장으로 로컬 LLM을 시험할 수 있습니다. 이 조건들이 필요한 만큼, 간단한 데스크톱 설치를 원하는 경우에는 다른 GPU와 설정 부담을 함께 비교해 보세요.
용어 각주
GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기프롬프트 — 모델에 보내는 입력문입니다. 생성 모델에서는 만들 결과를 설명하는 문장이 되어 출력의 구성과 내용을 크게 좌우합니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기대규모 언어 모델 — 대규모 텍스트 데이터에서 언어 패턴을 학습해 문맥에 맞는 텍스트를 처리하고 생성하는 모델입니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기양자화 — 모델의 가중치나 계산값을 더 적은 비트로 표현해 저장 공간과 메모리 사용량을 줄이는 방법입니다. 표현 단계가 거칠어져 정확도에도 영향을 줄 수 있습니다.
본문으로 돌아가기BF16 — 모델 수치를 저장하고 계산하는 16비트 부동소수점 형식입니다. FP32와 같은 폭의 지수부를 써 넓은 값 범위를 표현합니다.
본문으로 돌아가기FP16 — 16비트 부동소수점 수치 형식입니다. BF16과 비트 수는 같지만 지수부와 유효숫자 배분이 다릅니다.
본문으로 돌아가기FP8 — 값 하나를 8비트로 표현하는 부동소수점 수치 형식입니다.
본문으로 돌아가기GPU 커널 — GPU에서 병렬 실행되는 연산 코드로, 행렬 곱셈이나 정규화 같은 작업을 수행합니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- CMP 170HX는 NVIDIA GA100-105F GPU와 HBM2e를 탑재한 채굴용 가속기예요. Linux에서 프롬프트를 보내면 로컬 실행 프로그램이 GPU 메모리에 올린 모델로 입력을 처리하고 답변을 생성합니다. cmpunlocker의 메모리 프로필과 GA100에 맞는 실행 경로를 갖추면 로컬 LLM에 활용할 수 있어요.
- 필요한 메모리는 어느 정도인가요?
- 모델 가중치를 올린 뒤에도 실행 프로그램의 작업 공간과 KV 캐시가 메모리를 사용합니다. 입력 문맥을 길게 설정하면 KV 캐시도 커지므로, 양자화 파일 크기와 함께 실제 문맥 길이와 런타임 버퍼를 확인해요.