
実行プログラムと拡張機能
最終更新
CMP 170HXで64GBのローカルLLMを動かせる?
64GBメモリーを活用するには、Linuxドライバーと冷却の準備が必要です。
CMP 170HXはNVIDIA GA100-105F GPU1とHBM2eを搭載するマイニング向けアクセラレーターです。Linuxでプロンプト2を送ると、ローカル実行環境がGPUメモリに読み込んだモデルで入力を処理し、回答を生成します。対応するcmpunlockerメモリプロファイルとGA100向けの実行経路を用意すれば、ローカルLLM3に利用できます。
大きなメモリーを必要とするモデルを比較するときに検討する価値があります。まずカードのランク、Linux環境、冷却の準備を確認し、Qwen3.8の実行記録を見ていきます。
演算形式と実行時メモリをあわせて選びます
同じCMP 170HXでもメモリ構成は異なります
CMP 170HXのメモリ解放後の容量は、カードのメモリランクによって異なります。8GBのデュアルランクカードは64GB、一部の8GBシングルランクカードは32GB、10GBカードは40GBに構成できます。ランクとはメモリチップのまとまり方です。購入前に出荷時の容量とランクを確認します。
インストーラーはカード情報からプロファイルを自動検出します。手動で変更する場合は、カードのメモリランクとメンテナーの案内を照合してください。再起動後に表示される実容量を、モデル選択の基準にします。
| 出荷時のカード構成 | プロファイル適用後 | 確認事項 |
|---|---|---|
| 一部の8GBカード | 最大64GB構成 | 一部のシングルランクカードは32GBの場合がある |
| 10GBカード | 40GB構成 | READMEとカード識別情報を照合 |

インストール前にOSとドライバー条件をそろえます
cmpunlockerは一般的なデスクトップアプリではなく、Linux上のNVIDIAオープンGPUカーネル11モジュールにパッチを当て、メモリジオメトリを変更するツールです。メンテナーが示す要件は、Linux x86-64、root権限、NVIDIA CMP 170HX、対応範囲内のnvidia-open 610.xx.xx以降と一致するライブラリ・ファームウェア、実行中カーネルに一致するヘッダーです。初回ビルドにはネットワーク接続が必要で、署名されていないモジュールを読み込めるようSecure Bootを無効にする必要があります。
ドライバーの詳細なバージョンは、READMEの対応版とディストリビューションで入手できるパッケージを照合して選びます。メンテナーREADMEには615.78.08も記載されています。ドライバーを更新した場合、新しい版に合わせてパッチ済みモジュールを再ビルドすることがあります。カードを使うLinuxマシンでの手順は、Linuxアンロックガイドでインストール、プロファイル確認、削除まで説明します。
64GBのメモリでどのモデルを動かせますか?
各メモリ構成は、モデルの重み・実行環境の作業領域・KVキャッシュで分け合う予算です。モデルを選ぶ際は、実行環境の必要メモリと入力文脈をあわせて見積もります。32GBや40GBのカードでは、量子化を下げたり文脈を短くしたりして調整できます。
推論速度はモデル、量子化、HBMクロック、PCIeリンク、エンジン、デコード12設定によって変わります。同じボード番号で販売されたカードでもVBIOSやHBMクロックが異なる場合があります。PixelMLは64GiB・74 SM・HBM 1728MHz・PCIe Gen2 x16・180W・強制送風の条件で、Qwen3.8-27Bを1枚で実行した記録を公開しています。vLLMとopen-jetの結果、入力長ごとの条件は測定ガイドで確認できます。
| 認識容量 | モデル構成の余裕 | 最初に確認する項目 |
|---|---|---|
| 32GB | 重み・作業領域・文脈に使える余裕が最も小さい | 量子化ファイルのサイズと文脈長 |
| 40GB | 中規模モデルに余裕が増えるが作業領域も必要 | 10GBカードのプロファイルと実行形式 |
| 64GB | 重みと長い文脈を同時に置く余地が広い | 8GBカードのランク構成と適用プロファイル |
認識されたメモリ容量と実際の動作を両方確認します
アンロック後に再起動したら、まずnvidia-smiでGPU名、総メモリ、ドライバー版を確認し、nvidia-smi -q -d PCIでリンク世代と幅を調べます。64GBプロファイルを想定した8GBカードが32GBと表示される場合は、ランク構成が対応しているか、インストーラーがどのプロファイルを検出したかを確認してください。モデルを試すときは、メモリ割り当てが完了するか、プロンプト送信後に最初のトークン13が出るか、長い文脈の要求も完了するかを順に見ます。
リンクがGen1のままなら、カード、スロット、ライザー、BIOS設定、ボードの制限を調べます。PixelMLの資料ではGen2動作が試されましたが、Gen3はテストした4枚すべてでヒューズにより制限されていました。ボードによってx4またはx16になる場合もあるため、Gen2アンロックだけで全システムが同じ転送経路になるわけではありません。
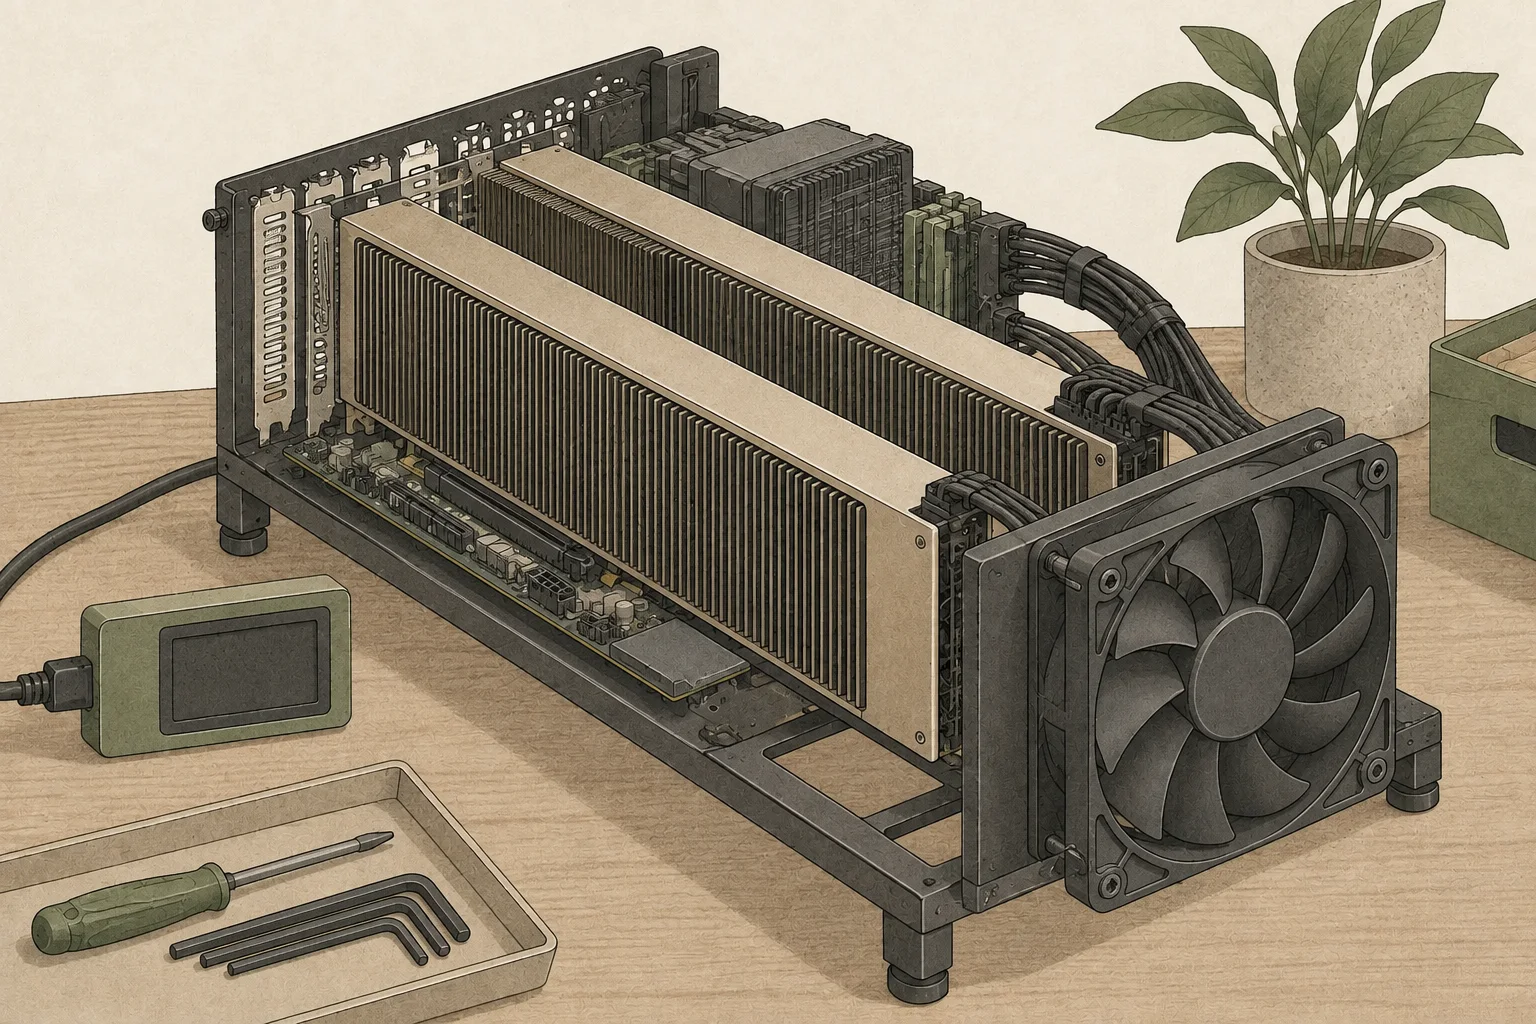
パッシブヒートシンクのカードには強制送風が必要です
CMP 170HXはカード上にファンのないパッシブヒートシンクを使います。フィンの中を風が通るよう、ブロワーファンやダクトファンを配置してください。モデルを読み込み、連続リクエスト中のGPUコア・メモリー温度とクロックの安定性を確認します。
電力上限を下げると発熱を抑えやすくなります。まず十分な風量を確保し、同じ作業で速度と温度を比べながら上限を調整してください。電力・冷却ガイドでは、Qwen 1枚構成の180W試験とGLM 4枚構成の電力別処理量を紹介しています。
まず1枚で始め、実際の用途で判断します
モデルを選ぶときは、量子化ファイル、認識メモリ容量、文脈長、実行環境のGA100対応を確認します。次に普段の入力に近い文書を送り、最初のトークンまでの時間、出力速度、要求が最後まで完了したかを別々に記録してください。カードが64GBと認識されても、入力が長くなるとKVキャッシュが増え、モデル構造に合ったカーネルが別途必要な実行環境もあります。
構成はnvidia-smiに表示される実メモリ、GA100対応の実行環境、使用する量子化と文脈長を基準に決めます。Linuxドライバーとカーネルモジュールを管理し、強い送風を用意できれば、CMP 170HX 1枚でローカルLLMを試せます。こうした準備が必要なので、簡単なデスクトップ導入を望む場合は、ほかのGPUと設定の手間もあわせて比較してください。
用語の注釈
GPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻る大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るコンテキスト長 — 1回のリクエストでモデルが扱える入力と生成内容のトークン範囲です。上限や実際のメモリ使用量はモデルと実行設定によります。
本文に戻るBF16 — モデルの数値に使う16ビット浮動小数点形式です。指数部はFP32と同じ幅で、同程度に広い値の範囲を表せます。
本文に戻るFP16 — 16ビット浮動小数点形式です。BF16とビット幅は同じですが、指数部と仮数部の配分が異なります。
本文に戻るFP8 — 一つの値を8ビットで表す浮動小数点形式です。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るGPUカーネル — GPU上で並列実行され、行列積や正規化などの処理を行うコードです。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- CMP 170HXはNVIDIA GA100-105F GPUとHBM2eを搭載するマイニング向けアクセラレーターです。Linuxでプロンプトを送ると、ローカル実行環境がGPUメモリに読み込んだモデルで入力を処理し、回答を生成します。対応するcmpunlockerメモリプロファイルとGA100向けの実行経路を用意すれば、ローカルLLMに利用できます。
- 必要なメモリはどのくらいですか?
- モデルの重みを読み込んだ後も、実行環境の作業領域とKVキャッシュがメモリを使います。文脈を長くするとKVキャッシュも増えるため、量子化ファイルのサイズだけでなく、実際の文脈長と実行環境のバッファも確認します。