
실행 프로그램과 확장
최종 업데이트
LightOnOCR-3로 스캔 PDF와 표를 로컬에서 추출하기
grounding 모드에서는 글자뿐 아니라 페이지 영역의 라벨과 좌표도 남아요. 표는 추출 후 행·열·단위를 원본과 확인한 다음 RAG나 검색 색인에 넣어요.
LightOnOCR-3는 plain 모드와 grounding 모드를 제공해요. plain은 전체 페이지 텍스트를 Markdown으로 옮기고, grounding은 레이아웃 block의 유형과 0~1000 좌표를 더해요. LightOnOCR-3 CLI1는 PDF를 페이지별 out/<name>/page-NNN.md로 저장하고 grounding이면 구조화된 .json도 만들어요. OCR2 결과는 원본 표와 함께 검수한 뒤 후속 검색에 연결해요.
스캔 PDF에서 본문과 표를 뽑아 문서 검색이나 검토에 연결할 때 쓸 수 있어요. PDF 파일과 페이지 범위를 입력하면 페이지별 Markdown과 선택적으로 위치 정보가 담긴 grounding block이 나와요.
처음에는 표가 있는 페이지 한 장과 본문 위주의 페이지 한 장을 골라요. 표 숫자와 열 제목, 단위가 원본과 맞는지 사람이 확인한 뒤에만 결과를 색인에 넣으면, 레이아웃이나 작은 글자에서 생긴 오류가 검색 답변으로 이어지는 일을 줄일 수 있어요.
plain과 grounding 중 결과 형식 정하기
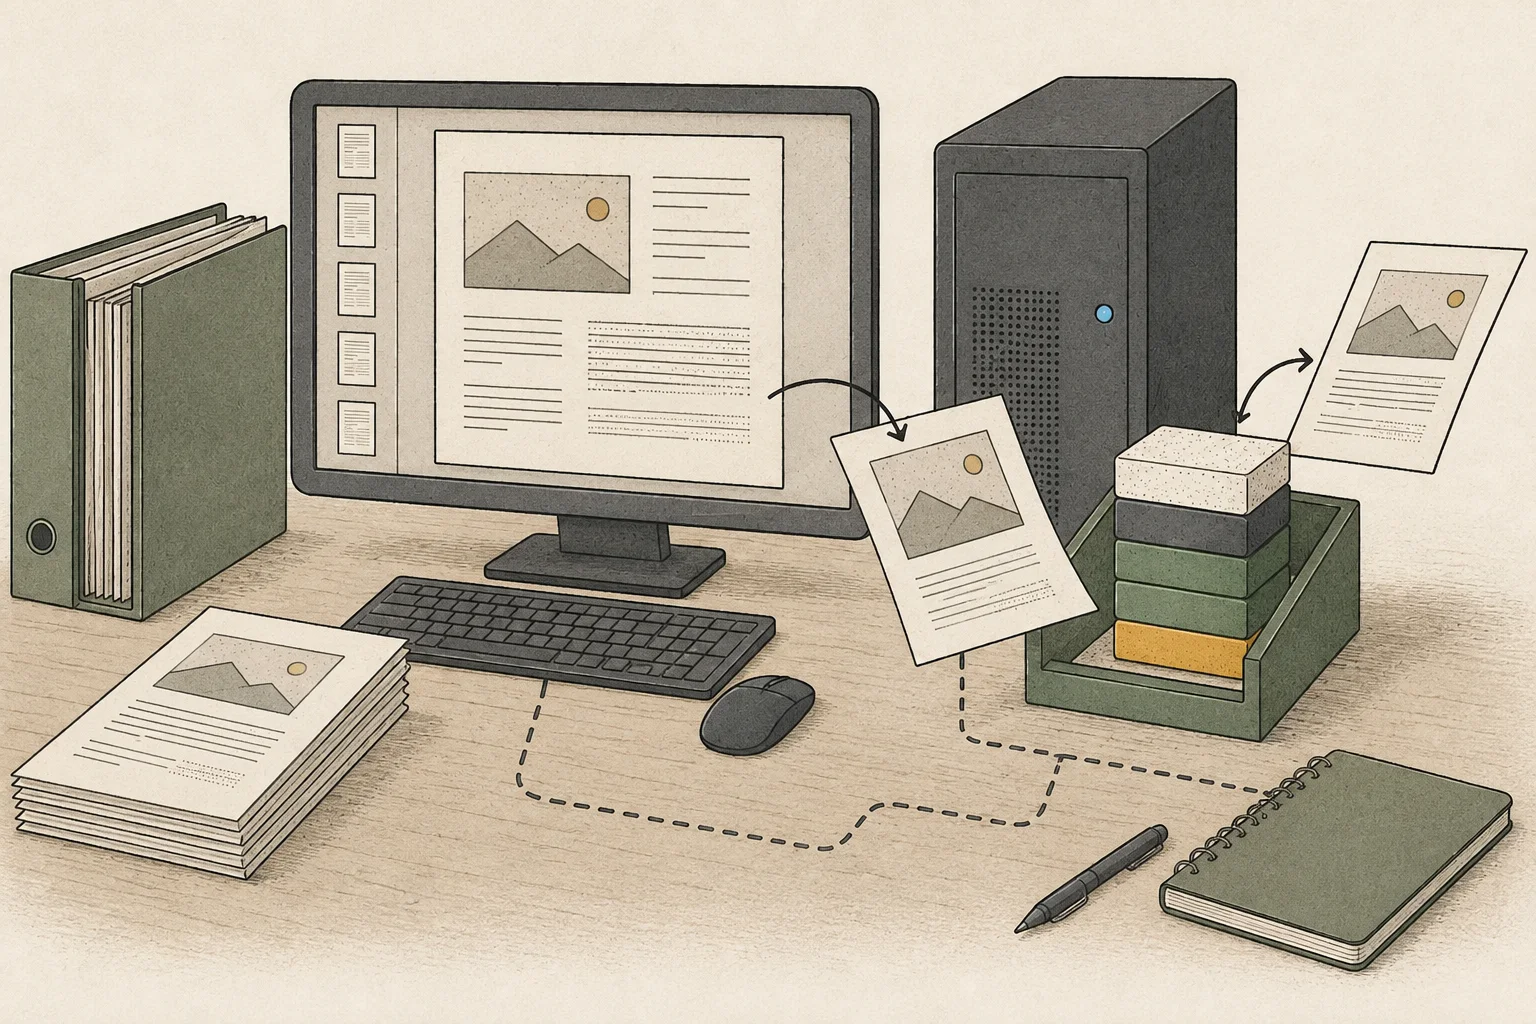
plain 모드는 페이지 텍스트를 Markdown으로 추출해 표와 수식을 사람이 읽기 쉽게 남겨요. grounding을 입력으로 주면 각 문서 영역 앞에 유형과 좌표를 담은 표식이 붙고, 좌표는 페이지 크기와 무관하게 0~1000으로 정규화돼요. .json block은 프로그램 후처리에, .md는 빠른 검수와 저장에 활용할 수 있어요.
표 중심 자료에서는 grounding이 좋은 시작점이에요. 각 표 영역의 위치와 텍스트를 함께 검수할 수 있고, 차트에서는 데이터 값이 HTML 표로 표현될 수 있어요. 모든 문서가 동일한 방식으로 변환되는 것은 아니므로 페이지별로 빈 셀, 잘린 열, 머리글·바닥글 혼입을 확인해요.
vLLM과 LightOnOCR CLI 연결하기
Linux와 CUDA3를 지원하는 NVIDIA GPU4, Python 3.10 이상을 준비하고 uv --version으로 uv 설치 여부를 확인해요. 없다면 uv 공식 설치 안내의 Linux 방법을 따라요. 설치 후 터미널을 다시 열어 버전이 표시되는지 확인한 다음 아래 저장소 설치로 넘어가세요.
uv --version
# If missing, the official Linux installer is:
# curl -LsSf https://astral.sh/uv/install.sh | sh
# Reopen the terminal and confirm uv --version before continuing.
공식 quick start는 uv sync --extra vllm으로 CLI와 서버 의존성을 설치해요. LightOnOCR-3-1B 예시는 포트 8010, 요청당 이미지 1개, 최대 모델 길이 16,384, 이미지 캐시 비활성화를 사용해요. 저장소는 vLLM 0.30.0과 Transformers 5.16.1을 고정하며, Transformers 5.17과 vLLM 0.27.1에서는 문제가 있다고 밝혀요.
mkdir -p "$HOME/projects"
cd "$HOME/projects"
git clone https://github.com/lightonai/LightOnOCR.git
cd LightOnOCR
uv sync --extra vllm
source .venv/bin/activate
vllm serve lightonai/LightOnOCR-3-1B --limit-mm-per-prompt '{"image": 1}' --max-model-len 16384 --mm-processor-cache-gb 0 --no-enable-prefix-caching --port 8010 --host 127.0.0.1
처리할 PDF를 저장소 폴더 $HOME/projects/LightOnOCR/에 report.pdf라는 이름으로 두고, CLI는 저장소 루트에서 실행해요. 서버는 별도 터미널에서 foreground로 켜 두며 --host 127.0.0.1로 로컬 인터페이스에만 바인딩해요. CLI는 기본 http://127.0.0.1:8010/v1로 연결하므로, 첫 실행에서는 저장소 기본 모델 이름을 유지해요.
cd "$HOME/projects/LightOnOCR"
source .venv/bin/activate
lightonocr report.pdf --mode grounding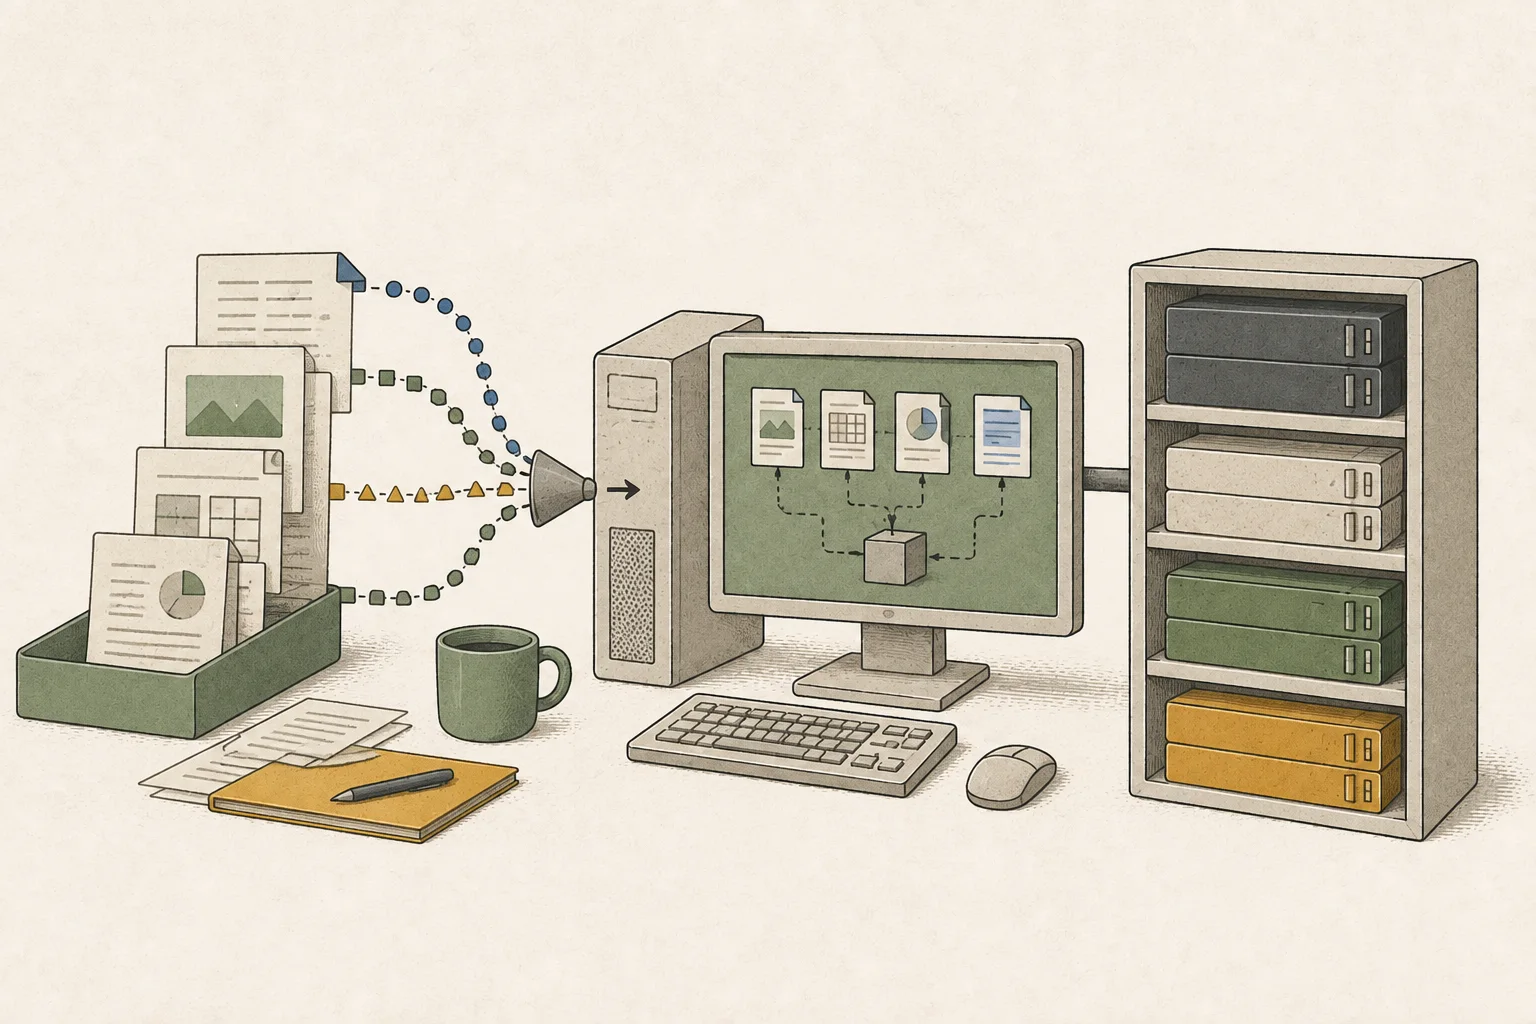
페이지별 출력에서 표를 검수하고 저장해요
정상 실행되면 CLI는 기본 out/report/에 페이지별 .md 파일과 전송한 페이지 이미지를 저장해요. grounding mode에서는 각 페이지의 .json block도 생성돼요. 먼저 파일이 생성됐는지, PDF 페이지 수와 출력 페이지 번호가 맞는지, Markdown 표가 열·행으로 보존됐는지 확인해요.
out/report/
├── page-001.png
├── page-001.md
├── page-001.json  # grounding mode
└── ...
업무용으로 넘기기 전 숫자 셀, 통화·단위, 병합된 머리글, 각주를 원본 PDF에서 표본 대조해요. grounding 좌표가 0~1000 범위인지도 확인하고, 좌표가 표 영역을 둘러싸더라도 행·열 경계와 숫자 자체가 정확한지 별도로 검토해요. 확인이 끝난 페이지만 후속 문서 시스템에 저장해요.
표가 틀리거나 페이지가 비었을 때 원인 나누기
결과 디렉터리나 페이지 파일이 없으면 서버가 준비된 뒤 CLI를 실행했는지와 포트 8010 주소를 확인해요. 빈 페이지나 요청 실패면 원본 PDF를 이미지로 렌더링해 페이지가 읽히는지 확인하고, 특정 페이지만 --pages로 다시 실행해요. 출력이 너무 길어 잘렸다면 전체 PDF 대신 페이지 범위를 줄여요.
표가 왜곡되면 먼저 plain mode와 grounding mode 결과를 나란히 봐요. --longest-edge는 이미지를 입력 해상도로 바꾸는 설정이라 원본의 작은 글자가 뭉개졌을 때 조정해 볼 수 있어요. 기본 서버도 모델별 페이지 크기를 선택하지만, 이미지 크기를 바꿀수록 처리량5과 정확도 사이의 균형은 직접 작은 묶음으로 확인해야 해요.
용어 각주
CLI — Command-Line Interface의 약자입니다. 터미널에 명령어를 입력해 프로그램을 조작하는 방식입니다.
본문으로 돌아가기OCR — 이미지나 스캔 문서에서 글자를 인식해 텍스트로 바꾸는 처리입니다. 표 배치나 읽기 순서는 원본 이미지를 함께 봐야 판단할 수 있습니다.
본문으로 돌아가기CUDA — NVIDIA GPU에서 범용 계산을 실행하기 위한 소프트웨어 플랫폼입니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- LightOnOCR-3는 plain 모드와 `grounding` 모드를 제공해요. plain은 전체 페이지 텍스트를 Markdown으로 옮기고, grounding은 레이아웃 block의 유형과 0~1000 좌표를 더해요. LightOnOCR-3 CLI는 PDF를 페이지별 `out/<name>/page-NNN.md`로 저장하고 grounding이면 구조화된 `.json`도 만들어요. OCR 결과는 원본 표와 함께 검수한 뒤 후속 검색에 연결해요.