
실행 프로그램과 확장
최종 업데이트
Youtu-Parsing-Omni로 문서·음성·영상을 JSON으로 정리하기
Youtu-Parsing-Omni는 한 번에 한 파일과 작업 유형을 지정해 문서 요소나 시간 순서가 있는 구간을 구조화해요. JSON을 저장하기 전에 원본과 좌표·읽기 순서를 대조하는 검수가 필요해요.
Youtu-Parsing-Omni는 5B BF161 모델로 문서·이미지·차트·오디오·비디오 작업을 하나의 JSON 계열로 반환해요. 공식 저장소의 vLLM 경로는 전용 플러그인과 고정된 의존성 버전을 쓰므로 설치 환경을 분리하고 플러그인 commit을 고정하는 편이 좋아요. 모델 라이선스는 youtu-parsing 커스텀 조건이므로 배포·상업 이용 전에 원문을 확인해야 해요.
Youtu-Parsing-Omni는 문서·음성·영상 파일을 task별 구조화 결과로 바꾸는 도구예요. 로컬 미디어와 task를 입력하면 문서 요소·좌표·읽기 순서나 음성·영상의 시간 구간을 담은 JSON이 터미널에 보여요.
먼저 문서 이미지, 짧은 음성, 짧은 영상을 하나씩 별도 task로 처리해요. 문서의 표와 읽기 순서, 음성의 화자·시각, 영상의 OCR2·ASR3 구간을 원본과 대조한 뒤 필요한 결과만 후속 처리에 넘겨요.
입력별로 task를 골라 JSON을 받아요
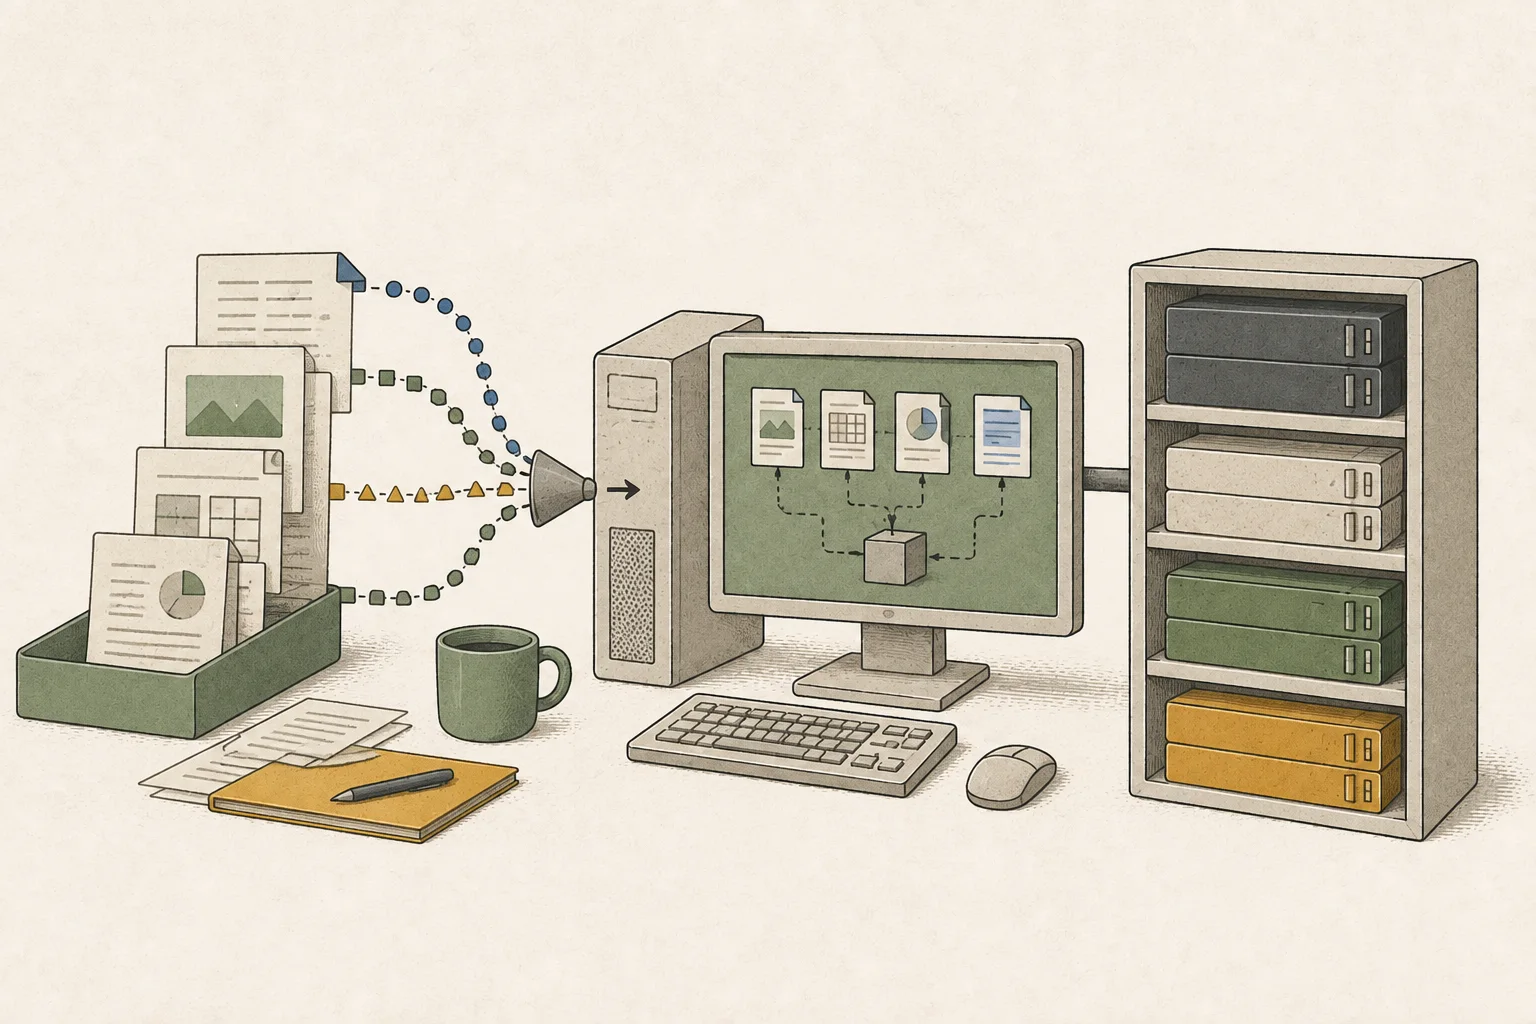
모델 카드의 작업 표에는 문서 페이지 document, 차트 graphics_chart, 음성 audio, 일반 영상 natural_video, 글자가 많은 영상 textrich_video 등 task가 나뉘어 있어요. 문서 JSON에는 요소별 텍스트나 LaTeX, 표, 좌표, 읽기 순서가 들어갈 수 있고 오디오·비디오는 타임스탬프가 있는 segments를 반환해요.
모든 입력을 한 종류의 OCR로 취급하지 마세요. 차트는 표·주석·캡션, 음성은 발화와 비발화 구간·ASR, 글자가 많은 영상은 OCR과 ASR 및 전체 보고서를 요청하는 작업이에요. 선택한 task가 입력과 다르면 해당 구조가 결과에 빠질 수 있어요.
vLLM 환경과 커스텀 코드 버전을 분리해요
공식 quick start는 Python 3.10 이상과 CUDA4 GPU5를 전제로 해요. vLLM 서버용은 설치 스크립트가 vllm==0.19.0, transformers==5.2.0과 vllm-plugin-vita-omni 경로를 준비해요. 직접 Transformers 추론은 transformers==5.10.2를 쓰므로 같은 가상환경6에 두 설정을 섞지 말고 별도로 만들어요.
플러그인은 모델 구현 코드를 포함하므로 움직이는 기본 브랜치 대신 리뷰한 commit에 고정하세요. 2026년 10월 13일 확인한 공식 저장소 main은 421cfad7acf8f0f80f5bd6dfa03b5ce3916224eb였어요. 설치 전에 Hugging Face의 youtu-parsing 라이선스를 읽고, 실행 스크립트가 미디어를 읽을 수 있는 디렉터리도 제한해요.
mkdir -p "$HOME/projects"
cd "$HOME/projects"
git clone https://github.com/TencentCloudADP/youtu-parsing.git
cd youtu-parsing
git checkout 421cfad7acf8f0f80f5bd6dfa03b5ce3916224eb
cd youtu_parsing_omni로컬 미디어 경로에서 첫 문서 페이지 파싱하기
모델 서버용 Python 가상환경을 따로 만들고 설치 스크립트를 실행해요. 실행 스크립트의 MODEL은 Hugging Face 모델 ID를 그대로 내려받거나 로컬 체크포인트7 경로를 받을 수 있고, 기본 캐시는 HF_HOME 아래에 놓여요. DATA_ROOT는 모델 저장 위치가 아니라 서버가 읽을 수 있는 미디어 파일 경로예요.
python3 -m venv .venv
source .venv/bin/activate
bash scripts/setup_env.sh
새 터미널을 열고 $HOME/projects/youtu-parsing/youtu_parsing_omni로 이동해요. media/page.png, media/speech.wav, media/clip.mp4를 해당 폴더 안에 준비해요. 아래 예시 입력은 youtu_parsing_omni/media/에 두고, infer_vllm.py를 실행해요.
infer_vllm.py는 결과를 파일로 저장하지 않고 fenced JSON을 터미널에 출력해요. 필요하면 출력을 텍스트 편집기로 복사해 앞뒤 코드 펜스를 제거하고 .json으로 저장해요. 문서의 제목·본문·표 요소와 읽기 순서, 음성의 구간·화자·ASR 텍스트, 영상의 시간대별 OCR·ASR 내용을 원본과 대조해요.
mkdir -p media
MODEL=tencent/Youtu-Parsing-Omni DATA_ROOT="$PWD/media" GPU=0 bash scripts/vllm.shcd "$HOME/projects/youtu-parsing/youtu_parsing_omni"
source .venv/bin/activate
python examples/infer_vllm.py --task document --media media/page.png
python examples/infer_vllm.py --task audio --media media/speech.wav
python examples/infer_vllm.py --task natural_video --media media/clip.mp4{
"modality": "image",
"subtype": "document",
"elements": [],
"reading_order": [],
"global_description": {}
}
JSON을 검수하고 다음 시스템에 연결해요
문서에서는 원본 표의 행·열, 작은 글자, 읽기 순서를 추출 JSON과 대조해요. 음성은 화자 이름과 타임스탬프에 맞는 재생 구간을 확인하고, 영상은 OCR·ASR이 같은 시간대의 내용을 가리키는지 살펴봐요.
서버가 파일을 찾지 못하면 해당 미디어가 DATA_ROOT 안에 있는지 먼저 확인해요. 음성·영상에서 ffmpeg가 없다는 메시지가 나오면 설치 경로에서 실행 가능한지 확인하고, 추론 환경의 패키지 버전이 vLLM 조합인지도 살펴봐요. 출력 구조가 요청과 다르면 작업 task와 프롬프트8 선택을 다시 맞춰요.
용어 각주
BF16 — 모델 수치를 저장하고 계산하는 16비트 부동소수점 형식입니다. FP32와 같은 폭의 지수부를 써 넓은 값 범위를 표현합니다.
본문으로 돌아가기OCR — 이미지나 스캔 문서에서 글자를 인식해 텍스트로 바꾸는 처리입니다. 표 배치나 읽기 순서는 원본 이미지를 함께 봐야 판단할 수 있습니다.
본문으로 돌아가기자동 음성 인식 — 음성에서 발화를 인식해 텍스트로 변환하는 기술입니다.
본문으로 돌아가기CUDA — NVIDIA GPU에서 범용 계산을 실행하기 위한 소프트웨어 플랫폼입니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기Python 가상환경 — 프로젝트별로 Python 패키지를 분리해 설치하는 공간입니다. 패키지 버전 충돌을 줄이는 데 쓰입니다.
본문으로 돌아가기체크포인트 — 학습된 모델의 가중치 등을 저장한 파일입니다. 같은 모델 계열도 버전이나 용도에 따라 다른 체크포인트를 쓸 수 있습니다.
본문으로 돌아가기프롬프트 — 모델에 보내는 입력문입니다. 생성 모델에서는 만들 결과를 설명하는 문장이 되어 출력의 구성과 내용을 크게 좌우합니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- Youtu-Parsing-Omni는 5B BF16 모델로 문서·이미지·차트·오디오·비디오 작업을 하나의 JSON 계열로 반환해요. 공식 저장소의 vLLM 경로는 전용 플러그인과 고정된 의존성 버전을 쓰므로 설치 환경을 분리하고 플러그인 commit을 고정하는 편이 좋아요. 모델 라이선스는 `youtu-parsing` 커스텀 조건이므로 배포·상업 이용 전에 원문을 확인해야 해요.
- 선택하지 않는 편이 좋은 경우는 언제인가요?
- 모든 입력을 한 종류의 OCR로 취급하지 마세요. 차트는 표·주석·캡션, 음성은 발화와 비발화 구간·ASR, 글자가 많은 영상은 OCR과 ASR 및 전체 보고서를 요청하는 작업이에요. 선택한 task가 입력과 다르면 해당 구조가 결과에 빠질 수 있어요.
- 조건과 출처는 어디서 확인하나요?
- 플러그인은 모델 구현 코드를 포함하므로 움직이는 기본 브랜치 대신 리뷰한 commit에 고정하세요. 2026년 10월 13일 확인한 공식 저장소 main은 `421cfad7acf8f0f80f5bd6dfa03b5ce3916224eb`였어요. 설치 전에 Hugging Face의 `youtu-parsing` 라이선스를 읽고, 실행 스크립트가 미디어를 읽을 수 있는 디렉터리도 제한해요.