
実行プログラムと拡張機能
最終更新
Youtu-Parsing-Omniで文書・音声・動画をJSONに整理する
Youtu-Parsing-Omniはファイルとtaskを指定して、文書要素や時間順のsegmentを構造化します。JSONを保存する前に、元ファイルと座標・読み順を照合してください。
Youtu-Parsing-Omniは5B BF161モデルで、文書・画像・チャート・音声・動画のtaskを統一JSON形式で返します。公式vLLM経路は専用プラグインと固定依存関係を使用するため、環境を分離しプラグインcommitを固定してください。ライセンスは独自のyoutu-parsingなので、配布・商用利用の前に原文を確認してください。
Youtu-Parsing-Omniは文書・音声・動画をtask別の構造化結果に変換します。ローカルメディアとtaskを入力し、文書要素・座標・読み順、または音声・動画の時間segmentを含むJSONをterminalで確認します。
文書画像、短い音声、短い動画をそれぞれ別taskで処理します。文書の表と読み順、音声の話者・時刻、動画のOCR2・ASR3区間を原本と照合してから、必要な結果だけ後続処理へ渡します。
入力ごとにtaskを選んでJSONを受け取る
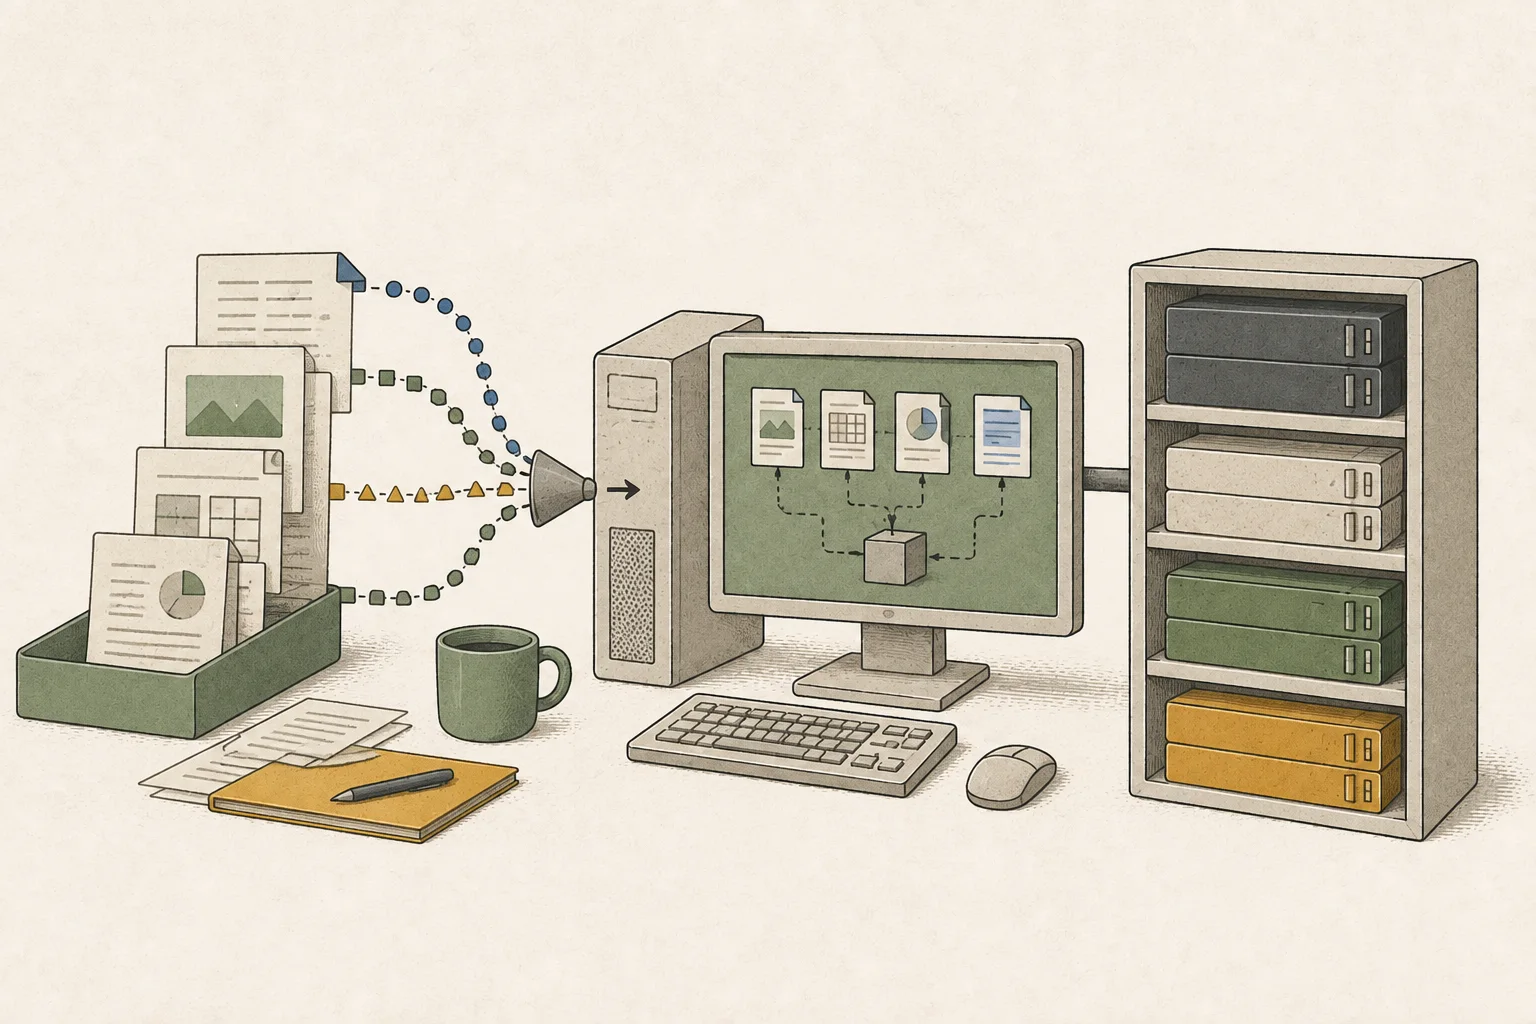
モデルカードでは文書ページのdocument、チャートのgraphics_chart、音声のaudio、動画のnatural_video、文字の多い動画のtextrich_videoなど、taskが分かれています。文書JSONには要素テキストやLaTeX、表、座標、読み順が含まれる場合があり、音声・動画はタイムスタンプ付きsegmentを返します。
すべての入力を同じOCR taskとして扱わないでください。チャートは表形式の内容・注記・caption、音声は発話・非発話segmentとASR、文字の多い動画はOCR・ASRと全体レポートを扱います。入力と異なるtaskを選ぶと、必要な構造が結果に含まれないことがあります。
vLLM環境を分離しカスタムコードを固定する
公式quick startはPython 3.10以上とCUDA4 GPU5を前提としています。vLLMサーバー設定はvllm==0.19.0、transformers==5.2.0、vllm-plugin-vita-omni経路を使います。Transformers直接推論はtransformers==5.10.2のため、2つの設定を別環境に分けてください。
プラグインにはモデル実装コードが含まれるため、更新される既定ブランチではなくレビュー済みcommitに固定してください。2026年10月13日時点で公式repositoryのmainは421cfad7acf8f0f80f5bd6dfa03b5ce3916224ebでした。導入前にHugging Faceの独自youtu-parsingライセンスを読み、serverがメディアを読み込めるdirectoryも制限してください。
mkdir -p "$HOME/projects"
cd "$HOME/projects"
git clone https://github.com/TencentCloudADP/youtu-parsing.git
cd youtu-parsing
git checkout 421cfad7acf8f0f80f5bd6dfa03b5ce3916224eb
cd youtu_parsing_omniローカルメディアから最初の文書ページを解析する
モデルサーバー用に別のPython仮想環境6を作り、その中でsetup scriptを実行します。server scriptのMODELにはHugging Face model IDまたはローカルcheckpoint7 pathを指定できます。model IDはダウンロードされ、既定cacheはHF_HOME以下です。DATA_ROOTはmodel保存先ではなく、serverが読み込めるメディアの範囲です。
python3 -m venv .venv
source .venv/bin/activate
bash scripts/setup_env.sh新しいターミナルを開き、$HOME/projects/youtu-parsing/youtu_parsing_omniに移動します。media/page.png、media/speech.wav、media/clip.mp4をそのフォルダーに用意します。例の入力ファイルをyoutu_parsing_omni/media/に置き、infer_vllm.pyを実行します。
infer_vllm.pyは結果をファイルに保存せず、fenced JSONをターミナルに表示します。出力をテキストエディターにコピーして前後のコードフェンスを取り除くと、.jsonファイルとして保存できます。文書のタイトル・本文・表要素と読み順、音声の区間・話者・ASRテキスト、動画の時間ごとのOCR・ASR内容を原本と照合します。
mkdir -p media
MODEL=tencent/Youtu-Parsing-Omni DATA_ROOT="$PWD/media" GPU=0 bash scripts/vllm.shcd "$HOME/projects/youtu-parsing/youtu_parsing_omni"
source .venv/bin/activate
python examples/infer_vllm.py --task document --media media/page.png
python examples/infer_vllm.py --task audio --media media/speech.wav
python examples/infer_vllm.py --task natural_video --media media/clip.mp4{
"modality": "image",
"subtype": "document",
"elements": [],
"reading_order": [],
"global_description": {}
}
JSONを検証して次のシステムへ渡す
文書JSONを原本の表の行・列、小さな文字、読み順と照合します。音声は話者名とタイムスタンプの再生区間を確認し、動画ではOCR・ASRが同じ時間帯を指すか確認します。
サーバーがファイルを見つけられない場合は、メディアがDATA_ROOT以下にあるか確認します。音声・動画でffmpegがないと表示されたら、環境内から実行できるか確認してください。パッケージ版がvLLM構成と一致しているかも確認します。出力構造が依頼と異なる場合はtaskとprompt8の選択を見直してください。
用語の注釈
BF16 — モデルの数値に使う16ビット浮動小数点形式です。指数部はFP32と同じ幅で、同程度に広い値の範囲を表せます。
本文に戻るOCR — 画像やスキャン文書の文字を認識してテキストにする処理です。表の配置や読み順は、元の画像を合わせて確認する必要があります。
本文に戻る自動音声認識 — 音声中の発話を認識してテキストに変換する技術です。
本文に戻るCUDA — NVIDIA GPUで汎用計算を行うソフトウェア基盤です。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るPython仮想環境 — プロジェクトごとにPythonパッケージを分けて導入する環境です。パッケージのバージョンの衝突を減らせます。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Youtu-Parsing-Omniは5B BF16モデルで、文書・画像・チャート・音声・動画のtaskを統一JSON形式で返します。公式vLLM経路は専用プラグインと固定依存関係を使用するため、環境を分離しプラグインcommitを固定してください。ライセンスは独自の`youtu-parsing`なので、配布・商用利用の前に原文を確認してください。
- 選ばないほうがよいのはどのような場合ですか?
- すべての入力を同じOCR taskとして扱わないでください。チャートは表形式の内容・注記・caption、音声は発話・非発話segmentとASR、文字の多い動画はOCR・ASRと全体レポートを扱います。入力と異なるtaskを選ぶと、必要な構造が結果に含まれないことがあります。
- 条件と出典はどこで確認できますか?
- プラグインにはモデル実装コードが含まれるため、更新される既定ブランチではなくレビュー済みcommitに固定してください。2026年10月13日時点で公式repositoryのmainは`421cfad7acf8f0f80f5bd6dfa03b5ce3916224eb`でした。導入前にHugging Faceの独自`youtu-parsing`ライセンスを読み、serverがメディアを読み込めるdirectoryも制限してください。