
ローカル音声認識・音声合成
最終更新
Fish Audio Drama 3 int4:41.5GBを22GBに減らして1枚に
4ビットに畳んでも声が保たれるかを見ます
Drama 3を4ビットに畳んだ非公式チェックポイント1です。ダウンロードは41.5GBから22.1GBに減り、公開測定ではWERが元のFP82と同水準です。代わりに1リクエストあたりの遅延が8%ほど増えます。
41.5GBを22GBに減らしたチェックポイント
Fish Audio Drama 3は35Bのうち3Bだけを計算する多話者音声合成モデルです。元はbf163で41.5GBあり、24GBカード1枚には収まりません。このチェックポイントは重みを4ビットに畳んで22.1GBにした非公式の量子化4版です。
どこを畳んだかが重要です。ルーティング専門家と一部のアテンション5射影だけをint4に下げ、すべてのトークン6が通る共有専門家と波形を作る音声デコーダはbf16で残しました。そのためW4A16ハイブリッドと呼ばれます。
ライセンスはFish Audioコミュニティライセンスです。商用利用の前に条件を確認してください。
| 構成要素 | 精度 | メモリに占める割合 |
|---|---|---|
| ルーティング専門家 | int4 | 重みの大半がここにあります |
| 一部のアテンション射影 | int4 | 保存は4ビット、計算は16ビットです |
| 共有専門家 | bf16 | すべてのトークンが通ります |
| 音声デコーダ | bf16 | 出力波形を直接作ります |
重みより多くのメモリが要ります
重みが20.8GBでも、サービング時のメモリはそれよりはるかに大きくなります。24GBカードでは起動直前に止まります。A100 80GBでの記録では起動時点で57.3GBを使い、5回生成する間のピークは57.9GBでした。
残りはKVキャッシュ7とエンジンの分です。文が長く話者が多いほどキャッシュが増えるため、重みだけで見積もった余裕はすぐ消えます。
Ampere以降が必要です。4ビットカーネルがGPTQ-Marlinを使うためです。Turing世代以前のカードではこの経路が開きません。
SGLang Omniで元と同じコマンドで起動します
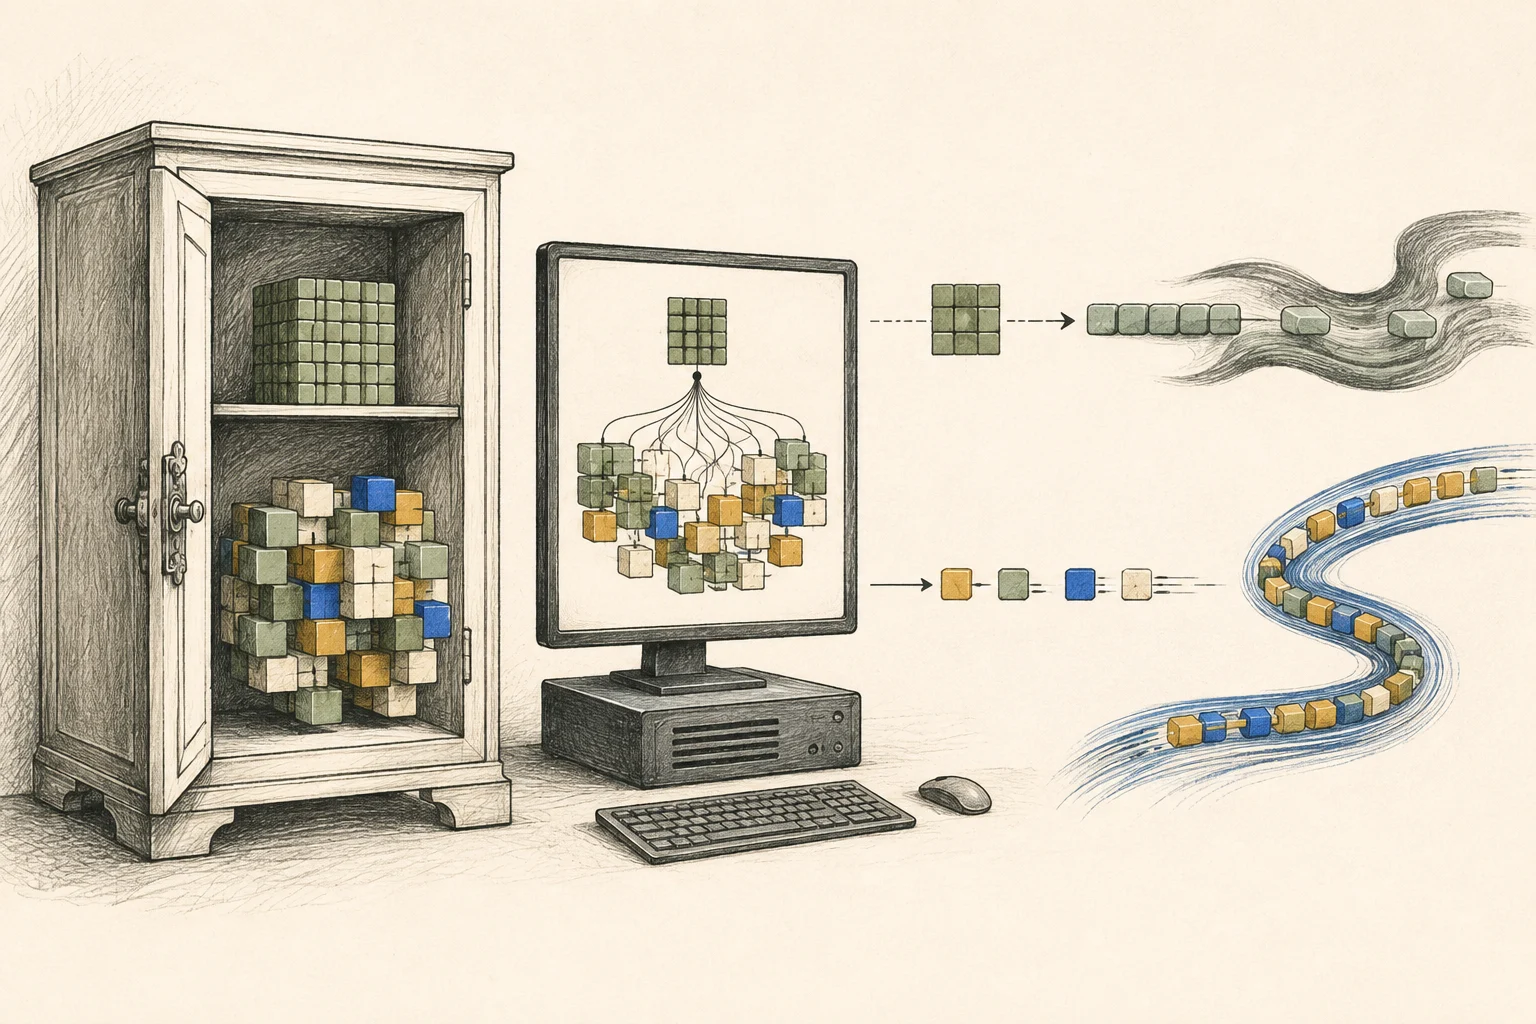
ランタイム8はSGLang Omniです。リポジトリを取得してPython 3.12の仮想環境9を作り、プレリリースを許可してfishaudio拡張を入れます。
| 用意するもの | 必要な条件 |
|---|---|
| GPU | Ampere(sm80)以降 |
| Python | 3.12の仮想環境 |
| インストール | --prerelease=allow が必要 |
| チェックポイント | 22.1GBのダウンロード |
チェックポイントを取得した後は元と同じsgl-omni serveコマンドを使います。量子化情報をチェックポイントが持っているため、ローダーを別途修正する必要はありません。
git clone https://github.com/sgl-project/sglang-omni.git
cd sglang-omni
uv venv -p 3.12 .venv && . .venv/bin/activate
uv pip install --prerelease=allow -e ".[fishaudio]"
hf download akhaliq/drama-3-int4

sgl-omni serve \
  --model-path akhaliq/drama-3-int4 \
--port 8000API10もそのままです。/v1/audio/speechにinputを入れ、referencesで参照音声を付け、[sighs]や[laughs]タグ、多話者シーン、previous_takes編集まで元と同じように動きます。
curl -s localhost:8000/v1/audio/speech \
  -H 'content-type: application/json' \
  -d '{"input":"오늘 회의는 여기까지입니다. [sighs] 정리해 둘게요.",
       "references":[{"audio":"ref.wav","text":"참조 음성 대본"}]}' \
  --output out.wav
公開測定では品質が保たれています
Seed-TTS Englishの1,088プロンプト11をH200 1台でconcurrency 8、非ストリーミングで回した記録です。WERは生成音声をQwen3-ASR-1.7Bで書き起こして測りました。
遅延は1リクエストあたり約8%増え、スループット12は6.47から5.99に下がりました。一方WERは1.63%で元より低く出ています。
この差を品質差と読むべきではありません。同じFP8チェックポイントを再実行したときも1.365秒と2.02%でした。実行ごとの振れ幅が2つの差と同程度です。
左右にスクロールして各項目を比較できます。
| チェックポイント | 重み | 平均遅延 | p95 | RTF | 毎秒リクエスト | WER |
|---|---|---|---|---|---|---|
| 元のFP8 | 37.0GB | 1.235秒 | 1.902秒 | 0.281 | 6.47 | 1.99% |
| int4 | 20.8GB | 1.334秒 | 2.178秒 | 0.320 | 5.99 | 1.63% |
別の量子化と比べると
同じ8プロンプトをA100で回した比較も公開されています。32GBカード向けのint8 dense量子化と並べています。
長い段落では比較対象が文を捏造してWER 0.667、こちらは0.028でした。話者類似度は0.846で同じです。
左右にスクロールして各項目を比較できます。
| チェックポイント | 平均WER | 中国語を除く | 話者類似度 |
|---|---|---|---|
| int4 hybrid (22.1GB) | 0.197 | 0.082 | 0.846 |
| int8 dense (24.5GB) | 0.259 | 0.154 | 0.846 |
中国語プロンプトはどちらも1.0でしたが書き起こしはほぼ同じでした。分かち書きのない中国語を分割する過程で生じた測定上の問題で、モデル差と見るべきではありません。
この表と上のSeed-TTS表を並べて比べてはいけません。データセットも書き起こしモデルも違います。
どちらを選ぶか
メモリが先ならint4です。重みが22GBなので24GBや32GBのカードが選択肢になります。
遅延が先なら元のFP8です。1リクエスト8%の差はリアルタイム対話のような場面で体感できます。
どちらもプレリリースの上にあります。sglang-omniは更新が速く、インストール手順や対応GPU13がリリースごとに変わり得ます。運用に入れる前に同じ文で一度聴いて決めてください。
用語の注釈
チェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るFP8 — 一つの値を8ビットで表す浮動小数点形式です。
本文に戻るBF16 — モデルの数値に使う16ビット浮動小数点形式です。指数部はFP32と同じ幅で、同程度に広い値の範囲を表せます。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るAttention — 入力トークン間の関連度を計算し、各位置の情報を現在の表現に反映するニューラルネットワーク演算です。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るPython仮想環境 — プロジェクトごとにPythonパッケージを分けて導入する環境です。パッケージのバージョンの衝突を減らせます。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るスループット — 一定時間に処理・生成した作業量です。トークン/秒やリクエスト/秒など、単位を合わせて比較します。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Drama 3を4ビットに畳んだ非公式チェックポイントです。ダウンロードは41.5GBから22.1GBに減り、公開測定ではWERが元のFP8と同水準です。代わりに1リクエストあたりの遅延が8%ほど増えます。
- 必要なメモリはどのくらいですか?
- 重みが20.8GBでも、サービング時のメモリはそれよりはるかに大きくなります。24GBカードでは起動直前に止まります。A100 80GBでの記録では起動時点で57.3GBを使い、5回生成する間のピークは57.9GBでした。
- 条件と出典はどこで確認できますか?
- ライセンスはFish Audioコミュニティライセンスです。商用利用の前に条件を確認してください。