
まず読み込み
最終更新
llmfit:自分のMacで動くモデルから絞り込みます
スペックを読み取って順位を付けるツールです
llmfitは自分の環境を読み取り、動くモデルを絞り込む無料ツールです。メモリ搭載、推定速度、品質、コンテキストの4軸で採点し、推定に使った値はinfoで公開します。benchで測った値を共有すると、同じ環境の人の推定が正確になります。
スペックを渡すと順位が出ます
インストールしてスペックを読ませます
MacではHomebrewで入れます。UbuntuやWindowsでも同じツールが使えるため、Macとデスクトップを並べて比べるときに便利です。
引数なしで実行します。上部に検出したスペック、下部にスコア付きの一覧が並び、モデルを選んでEnterを押すと詳細が開きます。
検出がおかしいときはdoctorを使います。何を読んだかをそのまま表示するので、メモリの読み違いも原因を追いやすくなります。
| 環境 | コマンド | 備考 |
|---|---|---|
| Mac・Linux | brew install AlexsJones/llmfit/llmfit | ビルド済みバイナリ |
| Pythonツール | uv tool install -U llmfit | uvx llmfit でも実行可 |
| Windows | winget install --exact --id AlexsJones.llmfit | Scoopにも対応 |
| コンテナ | docker run --rm -it ghcr.io/alexsjones/llmfit --tui | Web UIとAPIモード |
4つのスコアを別々に読みます
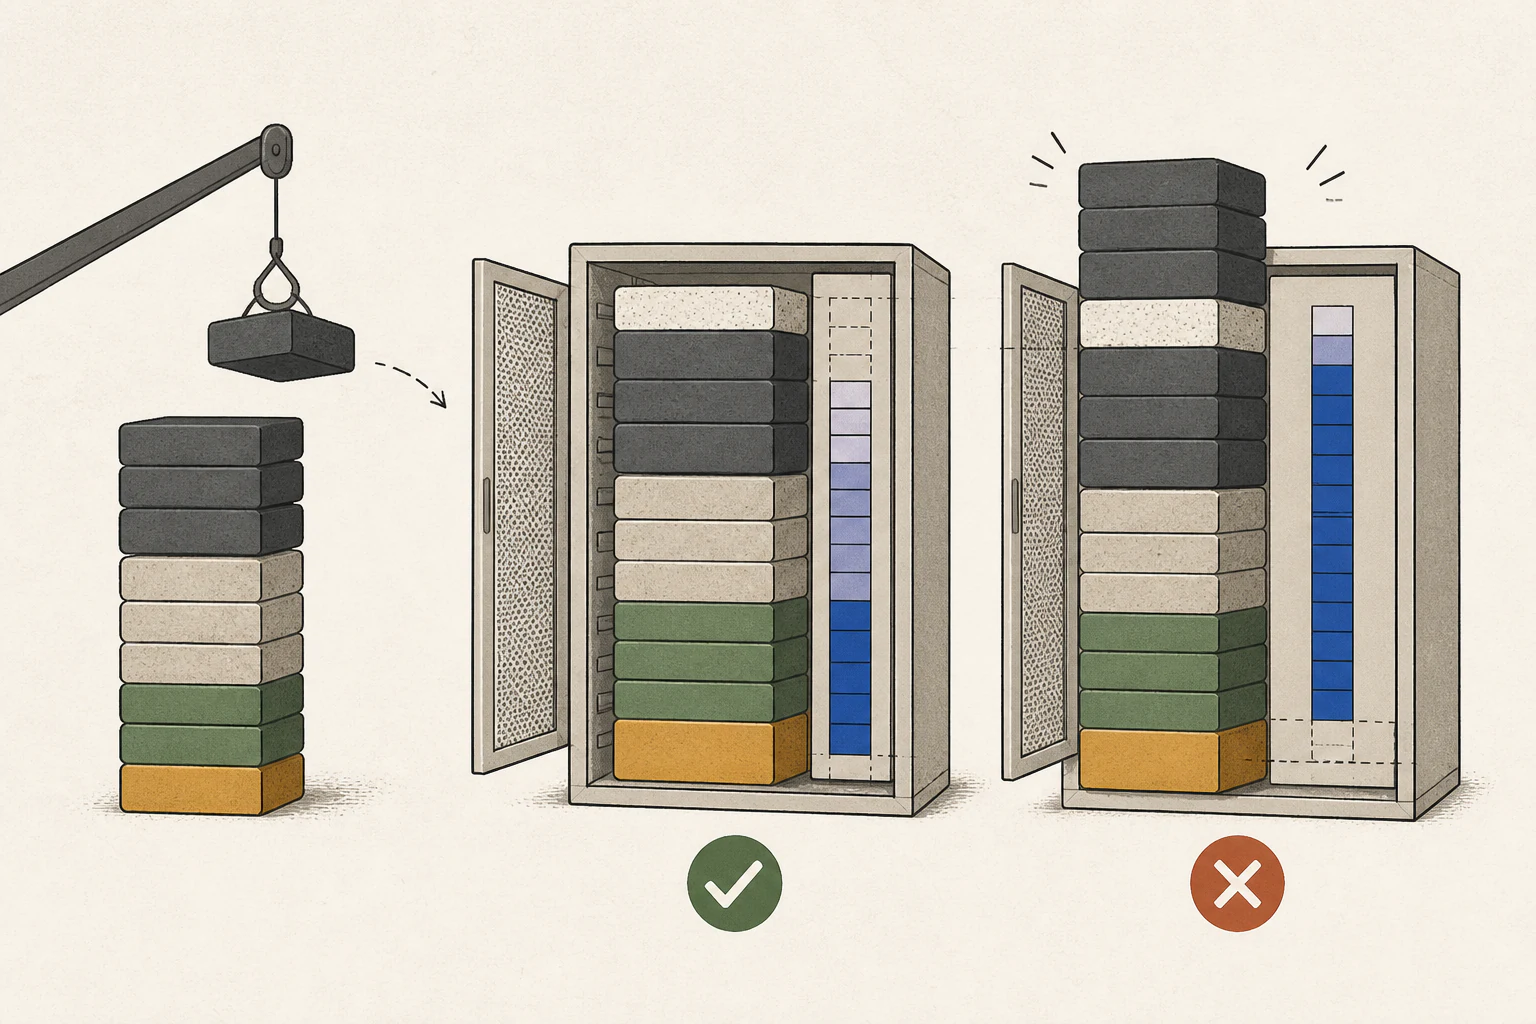
搭載スコアはモデルが利用可能なメモリをどれだけ使うかを見ます。50〜80%の帯を最も良く評価し、きつすぎても余りすぎても下がります。ここが違えば他のスコアは意味を持たないため最初に見ます。
速度スコアはメモリ帯域を基準に推定します。同じモデルでも帯域が違えば値が変わるため、機種比較ではこの軸が重要です。
品質とコンテキストはモデル自体の性質なので、機種が変わっても大きくは変わりません。この2つはどのモデルを選ぶかを決めるときに見ます。
| 項目 | 何を見るか | 読むときの注意 |
|---|---|---|
| 搭載スコア | 利用可能メモリに対する使用率、50〜80%が最適 | 最初に確認 |
| 速度スコア | メモリ帯域による推定 | 推定値なので誤差あり |
| 品質スコア | モデル自体の性能 | 機種に依存しない |
| コンテキスト長 | 用途別の目標に対するコンテキスト窓 | メモリをより使う |
推定と実測を並べます
一覧の速度はあくまで推定です。llmfitはその推定に入れた値をinfoで公開します。前提が自分の環境と違えば数字も変わります。
実測はbenchです。すでに動いているランタイム5に接続し、トークン6生成速度と最初のトークンまでの時間を測ります。今使っている構成の実際の値が出ます。
両方を見ると推定がずれた点が見えます。その差がこのツールを使う理由です。推定だけで機種を選ぶと、実測で順位が逆転することがあります。
| コマンド | 返すもの | 使う場面 |
|---|---|---|
| llmfit | スペックとスコア一覧 | 最初に見るとき |
| llmfit info | 推定の根拠と確認コマンド | 数字が怪しいとき |
| llmfit bench | 生成速度と最初のトークン時間 | 実測するとき |
| llmfit doctor | 検出したスペックの原本 | 検出が変なとき |
量子化とエキスパートモデルも計算します
GGUF7、AWQ、GPTQ、EXL2をまとめて扱います。固定ビットを仮定せず、Q8_0からQ2_Kへ下げながらメモリに収まる最も高い品質を選びます。全体のコンテキストが収まらない場合は半分にして再調整します。
エキスパートモデルは有効パラメータで計算します。全体のパラメータで計算すると実際より重く出て、動くモデルを見落とします。
この差は大きなモデルで顕著です。全体が100GBを超えても、一度に使う部分が小さければノートPCでも動きます。
スクリプトやサーバーからも使います
測定値が溜まると推定が良くなります
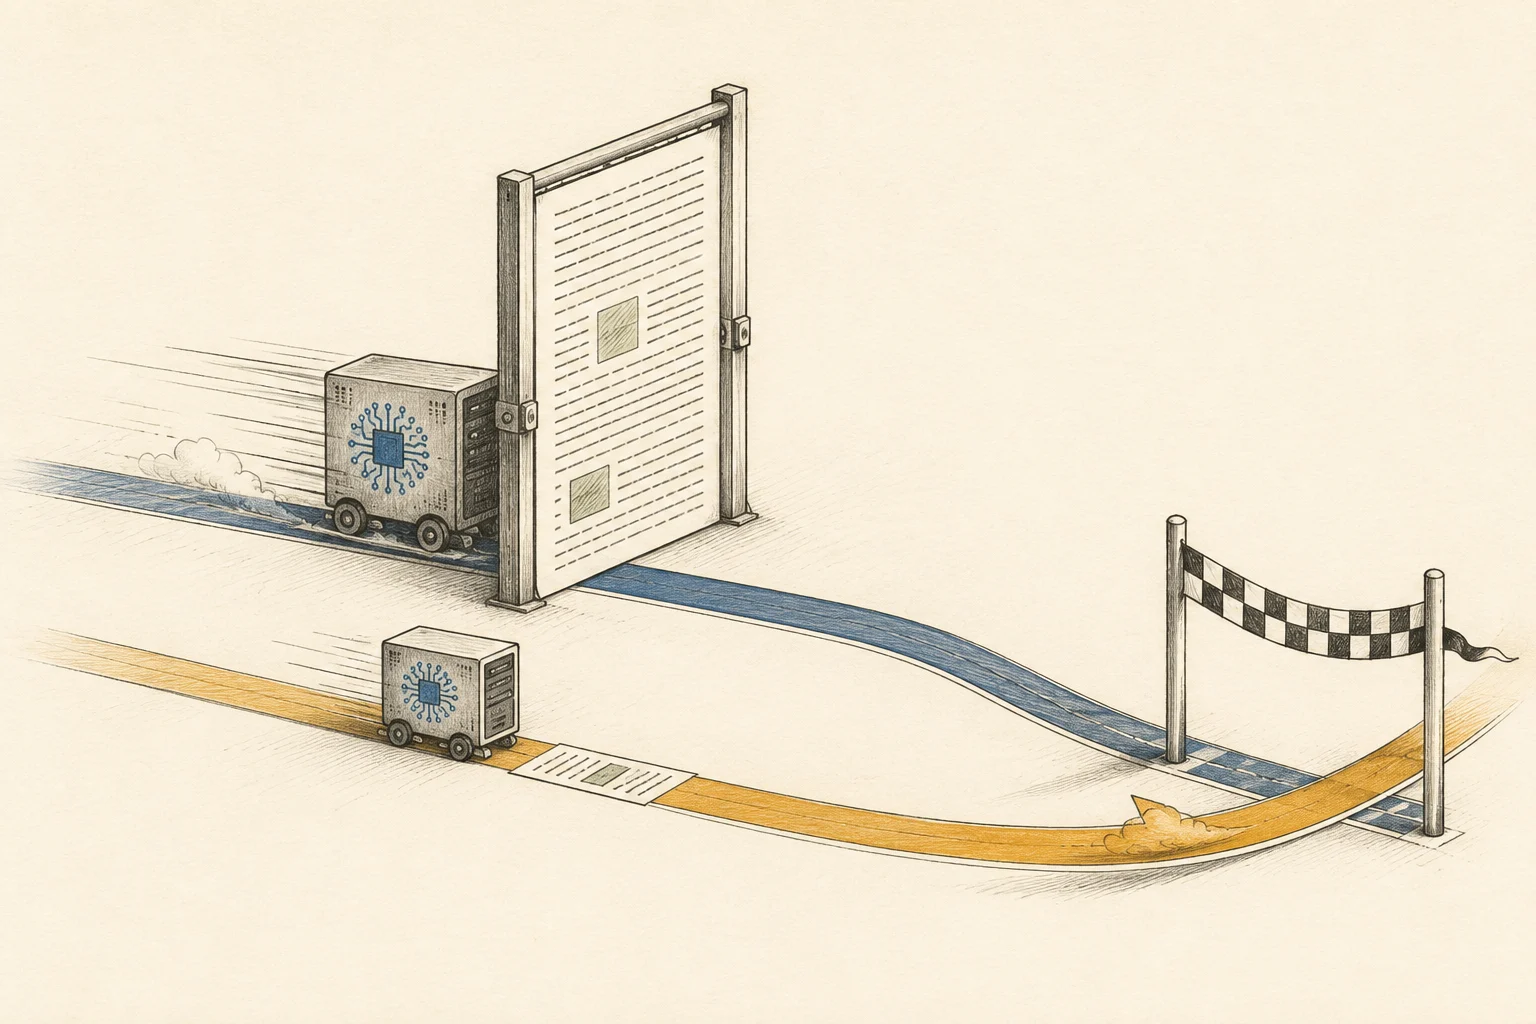
benchに--shareを付けると測定値をリポジトリへ送れます。結果はまず手元に保存され、送る時点でだけ外に出ます。
同じ環境の人は次のリリースでその値を見ます。推定がチェック付きの実測値に変わり、最初から実測で始められます。
モデル一覧が増えても推定が一緒に良くなる構造です。測定が溜まる分だけ推定の空白が減ります。
このツールが答えないこと
llmfitはモデルを実行しません。ダウンロードと実行はOllamaやllama.cpp、MLX10などのランタイムが担います。benchも動いているものに接続する方式です。
速度を保証するわけでもありません。他のアプリがメモリを使ったりドライバが違えば値は変わります。同じ機種でも条件が同じでなければ同じ数字にはなりません。
実際に動かして測るツールもあります。Ollamaでモデルを取得して実行しますが、エキスパートモデルを通常モデルとして計算するためメモリを大きく見積もります。どちらが適切かは確認したい対象によります。
購入判断にはこの一覧を出発点にし、最後の確認はbenchで行うのが安全です。
llmfitが答えない最後の部分は「この環境で実際どれくらい出るか」です。一覧の速度はメモリ帯域から計算した値なので、同じ環境でも量子化ファイルやコンテキスト長が違えば実測とずれます。
このサイトは機種ごとにプリフィル11、トークン生成、最初のトークンまでの時間を条件付きでまとめています。同じモデルを複数の機種で同じ条件のまま比べられます。llmfitで候補を絞り、絞った候補だけを実測値で確認する順番が速いです。
消費電力は計算しません。このサイトは機種ごとに最大電力と待機電力をメーカー基準で分けて書き、出典も残しています。電気料金の計算機では1日の使用時間と家庭の既存使用量を入れて、累進区分や夏・冬の料金まで反映した月額を出します。
用語の注釈
CPU — OSや一般的なプログラム命令を実行する中央処理装置です。AIでは前処理やデータ転送などの汎用処理も担います。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るGGUF — モデル情報を格納するファイル形式で、llama.cpp系のツールで広く使われます。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。
本文に戻るパイプライン — 入力から出力まで続く処理段階のまとまりです。段階ごとに異なるモデルやツールを使うことがあります。
本文に戻るMLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- llmfitは自分の環境を読み取り、動くモデルを絞り込む無料ツールです。メモリ搭載、推定速度、品質、コンテキストの4軸で採点し、推定に使った値はinfoで公開します。benchで測った値を共有すると、同じ環境の人の推定が正確になります。