
モデル別実行レシピ
最終更新
カカオ Kanana-2 3B埋め込みで韓国語RAGの索引を作る
韓国語検索では先行し、ベクトルは128次元まで縮められます。
モデルカードの韓国語検索スコアと3Bの重み・ベクトル容量からMacに合う構成を選び、sentence-transformersで索引を作る例をまとめました。
埋め込みモデルは質問と段落を同じ座標に置きます
韓国語検索のスコアはどのくらいですか
MTEB評価は、タスク別の指示文を入れず原文だけを通した条件です。nano-BEIR(ko)の平均は3Bが0.6088、1.3Bが0.5866で、韓国語検索6タスクの平均(Ko-Retrieval)は3Bが0.8211です。同じ表でQwen3-Embedding-4Bは0.5522と0.7837、Qwen3-Embedding-0.6Bは0.4845と0.7279でした。
英語では順序が変わります。MTEB(eng, v2)でQwen3-Embedding-4Bは0.6661で、3Bの0.6317を上回ります。韓国語文書が中心か、英語文書の比率が大きいかで選ぶモデルが変わります。
左右にスクロールして各項目を比較できます。
| モデル | nano-BEIR(ko) | Ko-Retrieval | MTEB(eng v2) |
|---|---|---|---|
| kanana-2-3b-embedding | 0.6088 | 0.8211 | 0.6317 |
| kanana-2-1.3b-embedding | 0.5866 | 0.7958 | 0.6197 |
| Qwen3-Embedding-4B | 0.5522 | 0.7837 | 0.6661 |
| Qwen3-Embedding-0.6B | 0.4845 | 0.7279 | 0.6311 |
| EmbeddingGemma-300m | 0.4564 | 0.7295 | 0.6247 |
128次元に縮めると保存量が20分の1になります
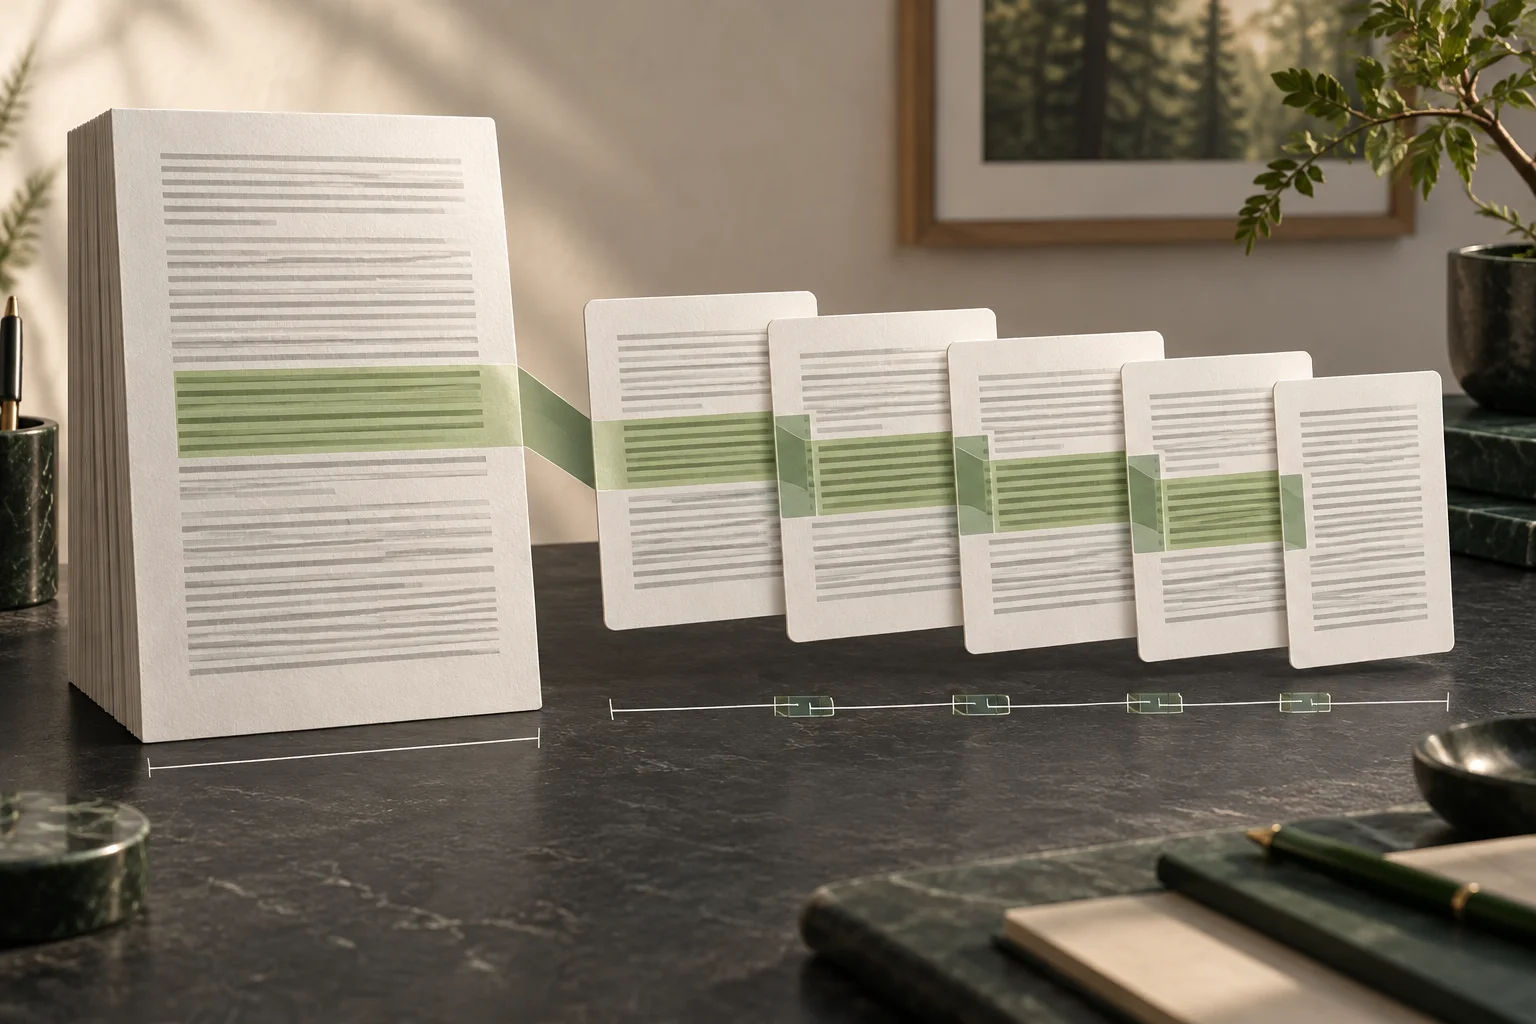
Matryoshka表現学習(MRL)は、ベクトルの先頭部分だけを使っても検索が保つように学習する方式です。3Bモデルは1,024・512・256・128次元に縮められ、256次元でもnano-BEIR(ko) 0.5683、Ko-Retrieval 0.7873を維持します。
保存量は次元数×4バイトで計算します。2,560次元は段落一つで10,240バイト、10万段落なら約1.0GBです。256次元に縮めると102MBで10分の1、128次元なら51MBで20分の1になります。同じディスクに10〜20倍の段落を置けます。
| 次元 | 段落1万 | 段落10万 |
|---|---|---|
| 2,560 | 102MB | 1.0GB |
| 1,024 | 41MB | 410MB |
| 512 | 20MB | 205MB |
| 256 | 10MB | 102MB |
| 128 | 5MB | 51MB |

Macで索引を作る手順
sentence-transformersでモデルを読み込み、truncate_dimに256を渡せば切り詰めまで一度に処理できます。Apple Siliconではdeviceをmpsに指定してGPU4を使います。初回は重みをダウンロードするため、3Bで6GB前後の保存領域とメモリが必要です。
段落は4,096トークンを超えないように分割し、質問と段落に同じモデルと同じ次元を使ってください。検索はコサイン類似度で並べ、上位候補はリランカーで見直せます。索引ファイルにモデル名と次元を残しておくと、ベクトルを混ぜる事故を防げます。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer(
    "kakaocorp/kanana-2-3b-embedding",
    trust_remote_code=True,
    truncate_dim=256,
    device="mps",
)
vectors = model.encode(chunks, batch_size=8, normalize_embeddings=True)
print(vectors.shape) # (段落数, 256)ライセンスと限界
用語の注釈
トークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るAttention — 入力トークン間の関連度を計算し、各位置の情報を現在の表現に反映するニューラルネットワーク演算です。
本文に戻る検索拡張生成 — 質問に関連する資料を検索してモデル入力に加え、その文脈をもとに回答を生成する方式です。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。
本文に戻るBF16 — モデルの数値に使う16ビット浮動小数点形式です。指数部はFP32と同じ幅で、同程度に広い値の範囲を表せます。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- モデルカードの韓国語検索スコアと3Bの重み・ベクトル容量からMacに合う構成を選び、sentence-transformersで索引を作る例をまとめました。
- 必要なメモリはどのくらいですか?
- sentence-transformersでモデルを読み込み、truncate_dimに256を渡せば切り詰めまで一度に処理できます。Apple Siliconではdeviceをmpsに指定してGPUを使います。初回は重みをダウンロードするため、3Bで6GB前後の保存領域とメモリが必要です。