
モデル別実行レシピ
最終更新
韓国語PDF検索に埋め込みとリランカーを追加する
まず埋め込みで候補を絞り、比較的遅いリランカーは上位候補だけに適用します。
BAAI/bge-m3埋め込みモデルはPDFから抽出した段落を検索し、BAAI/bge-reranker-v2-m3は上位候補を再採点して順序を変えます。両方をローカルで実行し、固定した韓国語の質問セットで通常の順位と再ランキング後の結果を比較できます。初回実行ではモデル重みのダウンロードにインターネット接続とディスク容量が必要です。
PDFに答えがあっても検索結果の上位に出ない場合があります。まず埋め込みで候補を取り、リランカーで質問と各段落を読み直して並べ替えます。以下ではBGE-M3とBGE reranker v2-m3でPDFを読み、段落の順位・ページ・処理時間を表示します。
候補検索と再ランキングは異なる計算です
埋め込みモデルは質問と各段落をベクトルに変換し、似た段落をすばやく検索します。リランカーは検索済み候補ごとに質問と本文を一緒に読み、関連度を採点して順序を変えます。PDF全体をリランカーだけで検索せず、埋め込み検索の上位K件を並べ替える構成で比較します。

多言語対応とモデルライセンスを確認する
BAAI/bge-m3のモデルカードは多言語埋め込みとMITライセンスを記載しています。BAAI/bge-reranker-v2-m3のカードは多言語cross-encoderとApache-2.0ライセンスを記載しています。どちらも韓国語で評価できますが、多言語対応の表示だけで特定分野の検索精度が決まるわけではありません。
各モデルカードでリポジトリのライセンス、対応言語、入力長、利用例を確認します。埋め込みモデルによってはquery: ...のような質問接頭辞が必要ですが、BGE-M3の例は同じencodeインターフェースを使います。初回ロードでモデルファイルがダウンロードされ、ローカルキャッシュに保存されます。
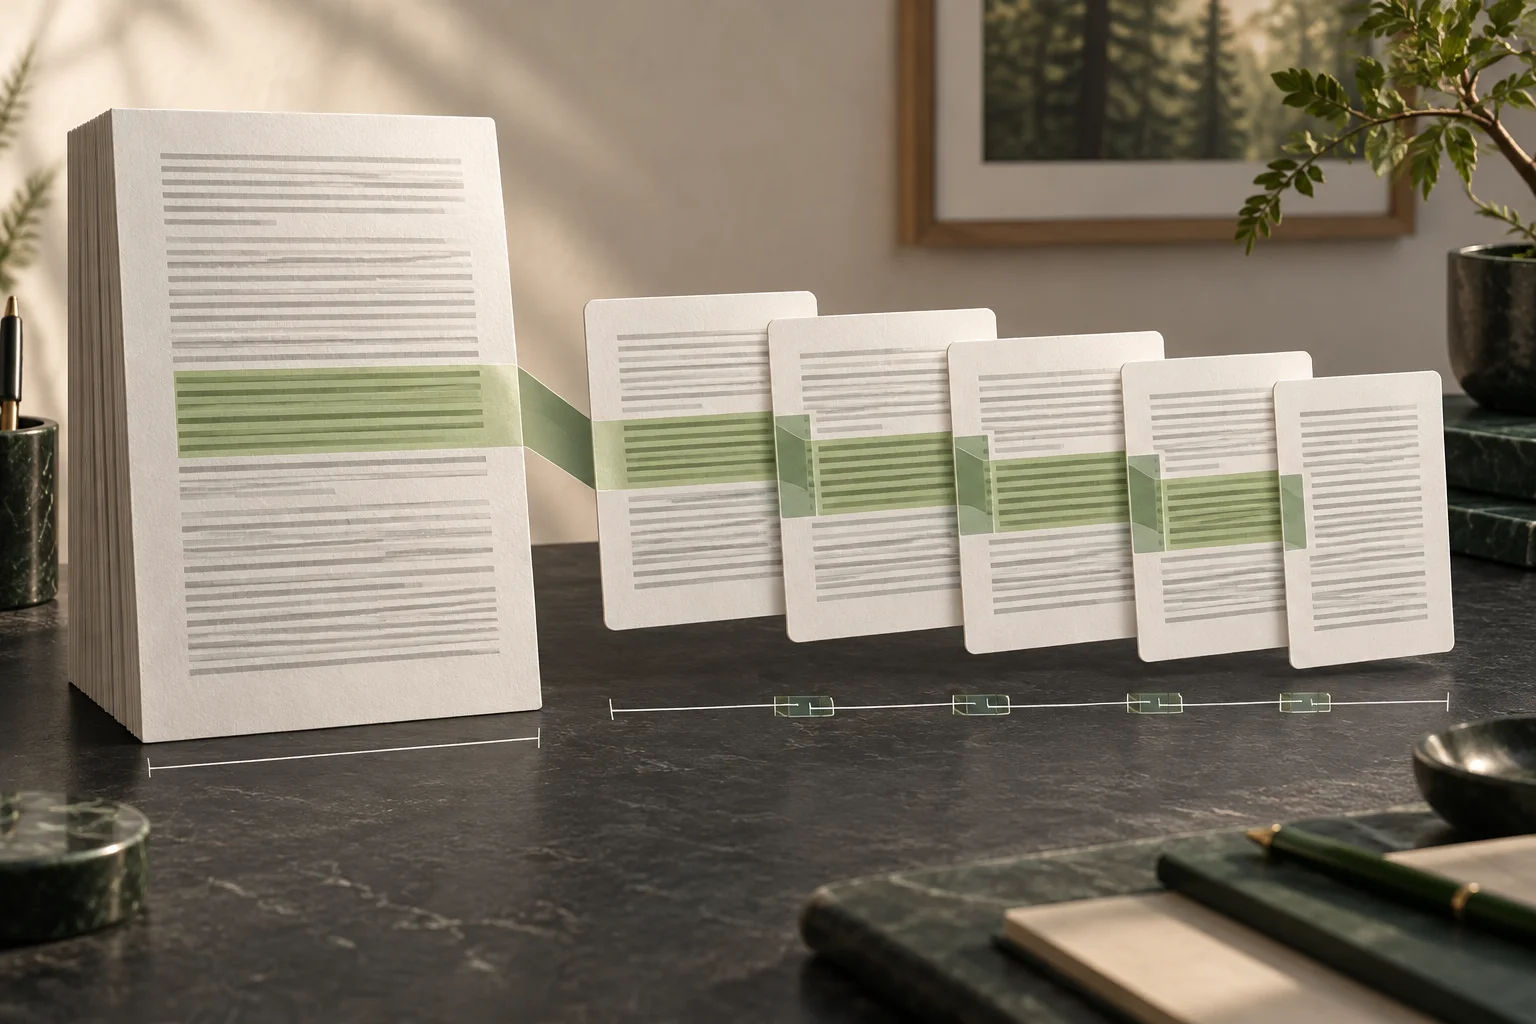
PDFから文字を抽出して検索候補を作ります
最初にスキャンPDFかtext PDFかを確認し、表・ヘッダー・ページ番号を保持するparserを選びます。同じPDF・質問・人手確認済み正解ページを使い、OCR1差がembedding比較へ混ざらないようにします。
段落IDに原本ファイル名とページ番号を結びます。表の抽出ミスが正解のように見える場合は、検索modelより先にparserを直します。
同じ検索質問で順位と時間を記録する
pypdfでsample.pdfのページごとのテキストを読み取り、700文字ごとに分割してsource、page、chunk_idを付けます。スキャン画像だけのPDFではテキストを抽出できず、OCRが必要というエラーになります。検索例は実際のPDF段落を使いますが、正解ラベルがないため品質評価にはなりません。Sentence Transformersとpypdfをインストールし、モデルの重みは初回実行時に取得します。
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -U sentence-transformers pypdf比較では文書ベクトルを一度だけ計算して保持します。質問ベクトルの作成とコサイン順位付けをbaseline検索として計時し、同じ上位候補だけをCrossEncoderに渡します。コードはbaseline順位、再ランキング後の順位、検索時間、リランカーのみの時間、クエリ全体の時間を表示します。
from pathlib import Path
from pypdf import PdfReader
from sentence_transformers import SentenceTransformer, CrossEncoder
from sentence_transformers.util import cos_sim
from time import perf_counter

pdf_path = Path("sample.pdf")
reader = PdfReader(pdf_path)
passages = []
for page_number, page in enumerate(reader.pages, start=1):
    text = " ".join((page.extract_text() or "").split())
    for start_char in range(0, len(text), 700):
        chunk = text[start_char:start_char + 700].strip()
        if chunk:
            passages.append({"chunk_id": f"p{page_number}-{start_char}", "text": chunk, "source": pdf_path.name, "page": page_number})
if not passages:
    raise ValueError("No selectable PDF text found; use a text PDF or run OCR first.")

query = "환불은 며칠 안에 신청해야 하나요?"
embedder = SentenceTransformer("BAAI/bge-m3")
reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")
# One-time indexing is outside both per-query timers.
doc_vectors = embedder.encode([p["text"] for p in passages], normalize_embeddings=True)
start = perf_counter()
query_vector = embedder.encode([query], normalize_embeddings=True)
candidate_scores = cos_sim(query_vector, doc_vectors)[0].tolist()
candidates = sorted(zip(passages, candidate_scores), key=lambda x: x[1], reverse=True)[:3]
baseline_ms = (perf_counter() - start) * 1000
print("baseline ranks:")
for rank, (p, score) in enumerate(candidates, 1):
    print(rank, p["source"], p["page"], p["chunk_id"], round(float(score), 4))

start = perf_counter()
r_scores = reranker.predict([(query, p["text"]) for p, _ in candidates])
rerank_ms = (perf_counter() - start) * 1000
reranked = sorted(zip([p for p, _ in candidates], r_scores), key=lambda x: float(x[1]), reverse=True)
print("reranked ranks:")
for rank, (p, score) in enumerate(reranked, 1):
    print(rank, p["source"], p["page"], p["chunk_id"], round(float(score), 4))
print("baseline_query_ms", round(baseline_ms, 2))
print("reranker_only_ms", round(rerank_ms, 2))
print("query_total_ms", round(baseline_ms + rerank_ms, 2))python rag_compare.pyこのコードには正解ラベルがないため、Recall@5やMRR@10は計算しません。次に韓国語の質問セットで関連段落をラベル付けし、同じ質問でbaselineと再ランキング後の順位を比較します。10〜20問は初回確認用です。p50・p95遅延はウォームアップ後に同じ質問を複数回測り、初回のモデルロードと文書index作成時間は除外します。
検索品質とコストを見て導入を判断する
リランキング前後で正解文書の順位を並べて比較します。10〜20件の質問でRecall@5とMRR@10を計算し、p50・p95遅延を記録すると品質改善と応答時間の増加を一緒に評価できます。モデル間でbatch size2とハードウェアを揃え、同じPDF抽出テキストを使います。
ローカル推論でも初回の重みやライブラリの取得にはネットワークを使います。各モデルリポジトリのライセンスを確認してください。モデル版やchunk設定を変えた場合は再利用する文書埋め込みを作り直します。リランカーは候補検索で漏れた段落を新たに見つけられないため、Recall@Kが低い場合は先にchunkingや埋め込み検索を調整します。
BGE-M3 dense検索とrerankerを分けます
BGE-M3はdense・sparse・multi-vectorを備えますが、最初はdense検索に固定します。同じ上位20候補へBGE rerankerを適用し、1段目の欠落と再順位付けの効果を分けます。
質問ごとにHit@5と正解順位を記録し、全体のHit@5・MRR@10を集計します。rerank時間は質問ごとに記録し、index folder容量は質問単位ではなくmodel・chunk・index設定ごとの行に記載します。初段候補に正解が含まれる割合も計算します。
用語の注釈
よくある質問
- この記事で最初に確認すべきことは何ですか?
- `BAAI/bge-m3`埋め込みモデルはPDFから抽出した段落を検索し、`BAAI/bge-reranker-v2-m3`は上位候補を再採点して順序を変えます。両方をローカルで実行し、固定した韓国語の質問セットで通常の順位と再ランキング後の結果を比較できます。初回実行ではモデル重みのダウンロードにインターネット接続とディスク容量が必要です。
- 条件と出典はどこで確認できますか?
- 各モデルカードでリポジトリのライセンス、対応言語、入力長、利用例を確認します。埋め込みモデルによっては`query: ...`のような質問接頭辞が必要ですが、BGE-M3の例は同じencodeインターフェースを使います。初回ロードでモデルファイルがダウンロードされ、ローカルキャッシュに保存されます。