
画像・動画生成
最終更新
LLaDA-Imageで画像を作り、直す:BaseとTurboの選び方
LLaDA-Image BaseとTurboを同じ生成・編集作業で比べます
LLaDA-Imageはプロンプト1から新しい画像を作り、参照写真と編集指示から写真を修正するモデル群です。公式例のサンプリングはBaseが50ステップ、Turboが4ステップです。同じリクエストで構図、細部、最終画像が完成するまでの時間を比べられます。
季節ドリンクを紹介するカフェ記事には、雰囲気のあるイラストと、ロゴや飲み物の色を保つメニュー写真編集という別々の結果が必要です。イラストは新規生成、写真は参照画像編集で個別に試し、構図と保持条件を確認してください。
新規画像生成と既存写真編集を分けて試します
新しいイラストでは主題が伝わり、タイトル用余白があるかを確認します。製品写真編集ではカップのロゴや飲み物の色など、変えてはいけない部分を基準にします。両方を汎用的な「見栄え」だけで評価せず、作業ごとに保持する要素を決めてください。
イラストでは正確な文字を描かせるより、タイトルを置く余白があるかを見ます。編集では変更箇所と保持箇所を1つの指示で指定し、元画像と並べてロゴ文字・カップの縁・指が変わっていないか確認してください。
Turboで下案を作り、必要に応じてBaseも確認します
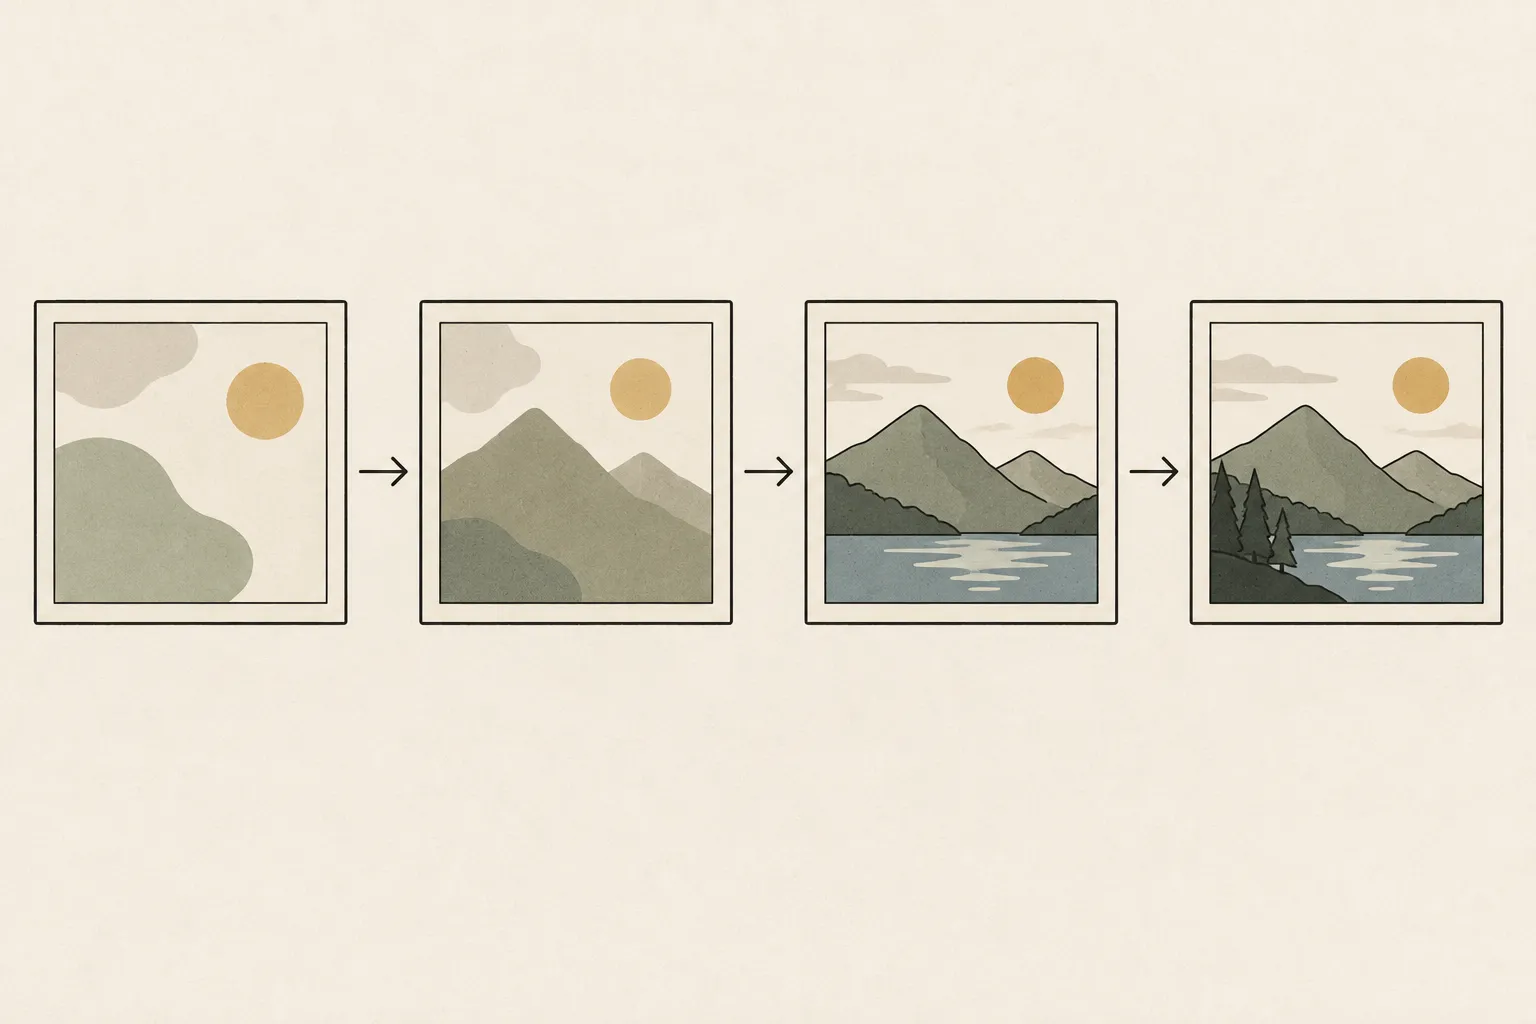
公式例はBaseで50 step、distilled Turboで4 stepを使います。色味や配置の探索にはTurboで下案を作り、気に入ったpromptをBaseにも入力して構図や細部を比べられます。
全体の時間にはモデル読み込み、テキスト処理、解像度に応じた計算、ファイル保存も含まれます。サンプリングと作業全体の時間を両方記録します。構図、色、影など必要な条件を満たすかを比べ、修正は一つずつ行います。
編集では保持する要素とサイズ条件を確認します
参照写真の編集では変更する条件と維持する条件を一緒に書きます。たとえば明るい室内背景にしつつ、カップのロゴと飲み物の色は保つよう指定できます。まず背景だけ変えて確認し、必要なら影などを追加すると変化の原因を追いやすくなります。
公式pipeline2の編集modeは入力画像と出力サイズを受け取り、各辺は32の倍数である必要があります。サイズエラーならこの条件を確認します。サイズが通ってもロゴが変わる場合は、指示と内容保持を別々に調べてください。サイズ条件と元要素の保持は別の検査です。
実行経路とメモリ配置を併せて確認します
公式repositoryにはDiffusers pipelineとBase・Turbo checkpoint3があります。例の環境はPython 3.11とCUDA4を使うPyTorch5です。新規画像はtext mode、参照編集はediting modeを選び、checkpoint・精度・サイズ・step数を記録してください。
ComfyUI workflowは公式commandをそのままgraphにしたものとは限りません。必要node・ファイル名・アプリ版を確認し、最初に成功したgraphを基準として保存してください。重みがディスクに収まってもtext encoder・生成部・中間データ・解像度に十分なメモリがあるとは限りません。普段のアプリを開いた状態で生成と編集が繰り返し完了するか試します。
掲載できる画像が完成するまで比べます
同じリクエストを3回実行し、初回読み込みと、その後の生成・編集を分けて記録します。中央の値を比べると、一時的な遅延の影響を抑えられます。挿画はTurboの構図や雰囲気で判断し、製品写真は元画像と比べてロゴや飲料の色を確認します。
custom nodeはコードを実行するため、提供元と版を確認してください。サイトの待ち時間体験は機器別のsimulationであり、LLaDA-Imageの速度・品質実測ではありません。必要な生成・編集が普段のアプリと併用して安定完了するなら、すぐのupgradeは不要かもしれません。反復待ちやメモリ制限が実務を妨げる場合に、保存graphと同条件で候補機器を比べてください。
用語の注釈
プロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るパイプライン — 入力から出力まで続く処理段階のまとまりです。段階ごとに異なるモデルやツールを使うことがあります。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るCUDA — NVIDIA GPUで汎用計算を行うソフトウェア基盤です。
本文に戻るPyTorch — AIモデルを作成・実行するソフトウェアフレームワークです。モデルと合わせて、対応するPyTorchの版やハードウェアも確認します。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- LLaDA-Imageはプロンプトから新しい画像を作り、参照写真と編集指示から写真を修正するモデル群です。公式例のサンプリングはBaseが50ステップ、Turboが4ステップです。同じリクエストで構図、細部、最終画像が完成するまでの時間を比べられます。
- 必要なメモリはどのくらいですか?
- ComfyUI workflowは公式commandをそのままgraphにしたものとは限りません。必要node・ファイル名・アプリ版を確認し、最初に成功したgraphを基準として保存してください。重みがディスクに収まってもtext encoder・生成部・中間データ・解像度に十分なメモリがあるとは限りません。普段のアプリを開いた状態で生成と編集が繰り返し完了するか試します。