実行プログラムと拡張機能
TransformersでGGUFを直接実行:llama.cpp・MLXとの違い
GGUFはPythonモデルのように扱うことができますが、最速のローカルチャットパスが変わるわけではありません。
GGUF1ファイルを書くには、flama.cppアプリに移動する必要があると思います。新しいTransformersパスは、Apple SiliconでGGUFの重みを圧縮したままMetal2カーネルに読み込み、使い慣れたPythonモデルAPI3とローカルサーバーに接続します。実験コードを深く手にしたい場合に便利ですが、単純なチャット速度と汎用性では、flama.cppはまだデフォルトの選択です。
なぜ同じGGUFを別のパスで実行するのですか?
llama.cppはGGUFの代表的なランチャーで、インストールが簡単なアプリやサーバーがたくさんあります。 Transformersは、モデルの中間出力、カスタムロジット処理、評価コード、Pythonエコシステムをそのまま使用したい人に精通しています。今回のパスの意味は、GGUFを再び大きな浮動小数点重みで完全に解くことなく、Transformers API内で扱えるようになったことにあります。
単純な会話サーバーが目的の場合は、flama.cppの成熟したローカルパスがより簡単になる可能性があります。モデルの内部を調べるか、同じコードでデータセットの評価とカスタム前処理を続ける必要がある場合は、Transformersが有利です。エンジンの優劣ではなく、タスクの次のステップがどこにあるかを選びます。
圧縮状態を維持したことを最初に確認します
公式パスは、Apple SiliconのMPSでggmlカーネルとggml-attnを呼び出し、重みを圧縮したまま計算します。互換性のあるPyTorch4、Transformers、kernelsのバージョンが合わないと、一般的な逆量子化5パスに落ちる可能性があります。モデルが開かれたという事実だけで成功したとは思わず、ロードログと実際のメモリ増加量を一緒に見てください。
Q4 GGUFが小さなファイルであっても、KVキャッシュ6とランタイム7スペースは別々です。圧縮カーネルが適用された基準メモリを保存し、コンテキストを増やすとメモリがどれだけ増加するかを確認します。予想よりも大きく増やすと、ファイル形式よりもカーネルが適用されているかどうか、およびデータ型が最初にチェックされます。
ファイル名まで指定する必要があり、同じモデルを開きます
1つのHugging Faceリポジトリに複数の量子化ファイルを含めることができます。 from_pretrainedにリポジトリIDだけでなく、gguf_fileを指定する必要があるQ4ファイルを選択できます。最新の機能がフルリリースに入る前に、公式記事のインストールコマンドのように、Transformers mainと互換性のあるkernelsバージョンが必要になることがあります。
最初の実行では、小さなモデルと短いプロンプトで確認します。 CPU8メモリとGPU9メモリ、最初のロード時間を記録してから、目的のモデルに移動します。カスタムコードが不要でインストールバージョンとカーネルを引き続き合わせる必要がある場合は、flama.cppまたはMLX10が運用負担を軽減できます。
pip install -U "git+https://github.com/huggingface/transformers.git" kernelsfrom transformers import AutoModelForCausalLM, AutoTokenizer
repo = "bartowski/Qwen2.5-7B-Instruct-GGUF"
file = "Qwen2.5-7B-Instruct-Q4_K_M.gguf"
tokenizer = AutoTokenizer.from_pretrained(repo, gguf_file=file)
model = AutoModelForCausalLM.from_pretrained(repo, gguf_file=file, device_map="mps")
サーバーに書き込むときは、現在の制限を受け入れる必要があります
Transformers serveでOpenAI互換APIを開くことができ、既存のアプリを簡単に接続できます。ただし、公式記事の最初の実装は一度に1つの会話に焦点を当てており、パディングとバッチングはさらにトリミングする必要があると説明します。複数のユーザーが同時に接続するサーバーの場合は、単一の会話が成功した後、並行性2・4・8で最初のトークン11遅延と総スループット12を別々に測定する必要があります。
コードは最初に127.0.0.1にバインドし、外部公開前に認証とプロキシを追加します。 Pythonフックを簡単に配置できるという利点は、任意のコードとモデルストアコードをさらに実行できることです。使用するリビジョンとパッケージのバージョンを固定し、開発環境と運用環境を分割します。
transformers serve "bartowski/Qwen2.5-7B-Instruct-GGUF:Qwen2.5-7B-Instruct-Q4_K_M.gguf"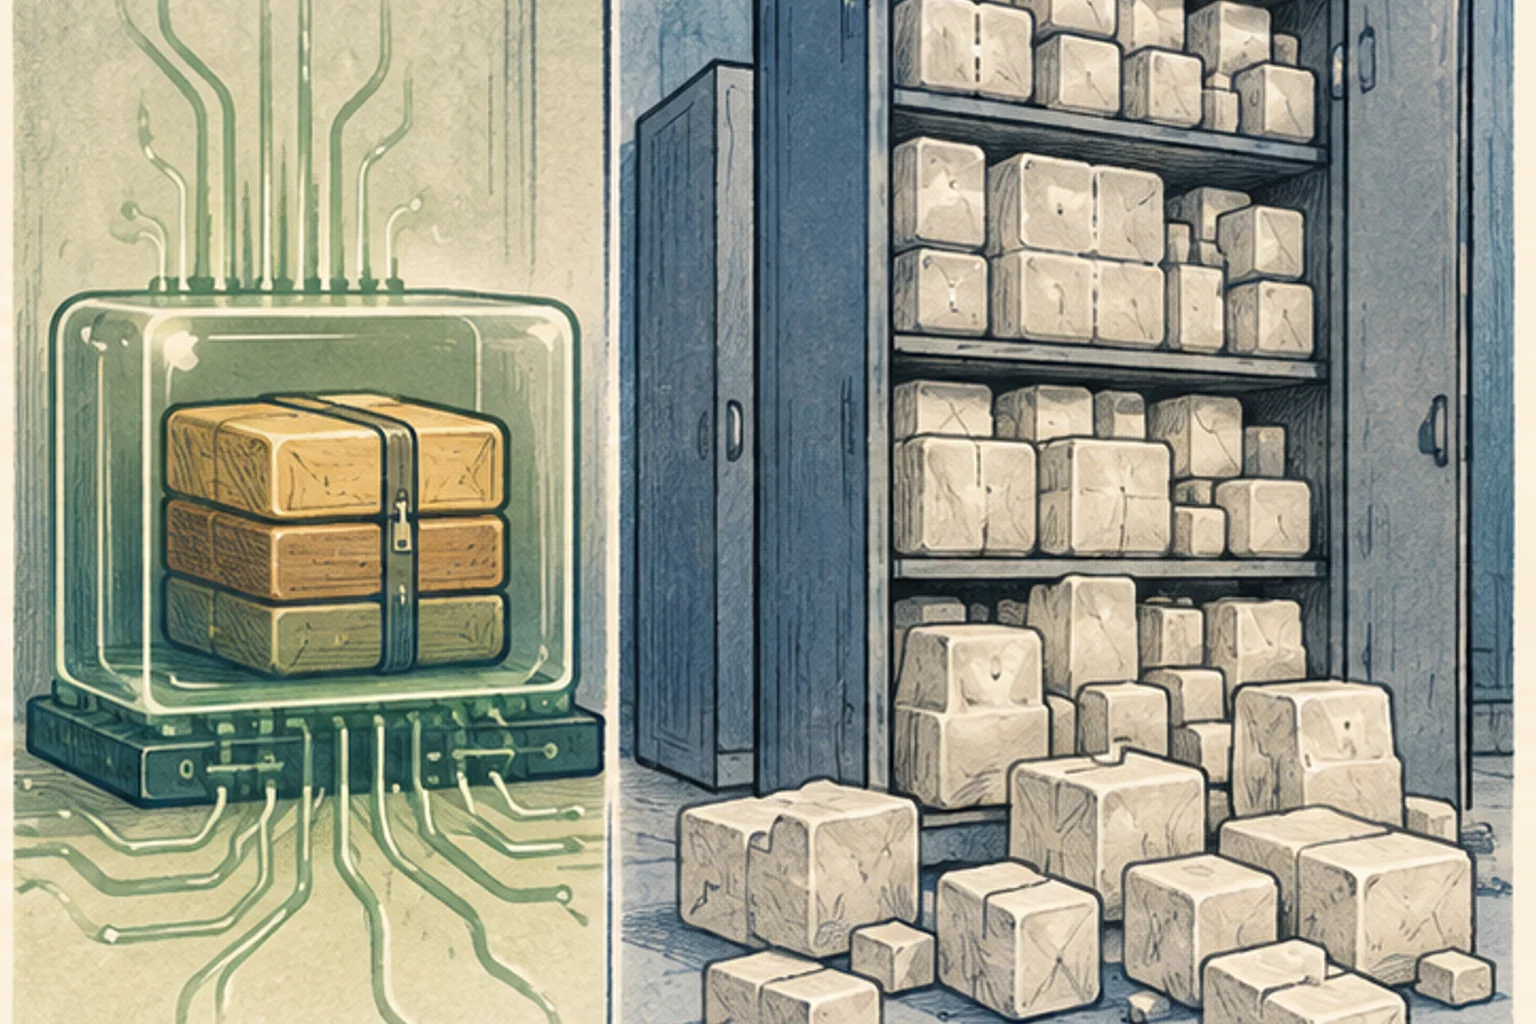
3つのエンジンを選ぶ短い標準
インストールが簡単で、GGUFの選択肢が広いローカルチャットと埋め込みサーバーは、flama.cppが最初の候補です。 Apple Siliconでモデル変換と配列操作を直接扱い、MLXエコシステムの加速を書くには、MLXがうまくフィットします。 Hugging Face評価・パイプライン13・カスタムforwardを維持しながらGGUFメモリー節約を得たいときにTransformers直接実行を選びます。
速度比較は、同じモデルファイルとプロンプト、出力の長さに合わせます。公式記事のTransformers数値はプリフィル14を含む128トークン生成であり、flama-benchのtg128はデコード15中心であり、そのままランク付けすることはできません。私のタスクでは、最初のトークンとデコード、ピークメモリを一緒にプレイする選択が終了します。
用語の注釈
GGUF — モデル情報を格納するファイル形式で、llama.cpp系のツールで広く使われます。形式だけで特定ハードウェアへの対応や速度が保証されるわけではありません。
本文に戻るMetal — Apple機器でグラフィックスやGPUの並列計算を実行する低水準の技術です。モデルを選んで会話するアプリそのものではありません。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。APIという言葉だけで外部サーバーへの送信を意味するわけではありません。
本文に戻るPyTorch — AIモデルを作成・実行するソフトウェアフレームワークです。モデルと合わせて、対応するPyTorchの版やハードウェアも確認します。
本文に戻る量子化 — モデルの数値を少ないビット数で表す方法です。メモリ使用量のほか、精度や実行速度も変わることがあり、影響は形式と実装によります。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあり、GPUランタイムライブラリと完成したサービングアプリは別の構成要素です。
本文に戻るCPU — コンピューターで汎用のプログラム命令を実行する中央処理装置です。AI処理ではGPUなど他のプロセッサーと役割を分けることがあります。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るMLX — Appleが開発する機械学習フレームワークです。Apple siliconでは統合メモリとMetalを活用し、別途Linux向けの実行経路も提供します。対応モデルや機能はMLXを使うツールごとに異なります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。1トークンが1文字や一定の時間に相当するわけではありません。
本文に戻るスループット — 一定時間に処理・生成した作業量です。トークン/秒やリクエスト/秒など、単位を合わせて比較します。
本文に戻るパイプライン — 入力から出力まで続く処理段階のまとまりです。段階ごとに異なるモデルやツールを使うことがあります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るデコード — LLMでは入力処理後に出力トークンを生成する段階です。VAEやオーディオコーデックでは、圧縮表現や符号化データから元の形式を復元する処理を指すことがあります。
本文に戻る