新規モデル · 2026.09.29
K2 Horizon 0.9B〜36B-A4B:自分のハードウェアに合うモデルを選ぶ
最大のK2が正解ではなく、継続して入れることができる最小のK2が出発点です。
K2 Horizonは、0.9Bから32Bの密集型、36B-A4B MoE1まで、1つのファミリ内でサイズが大きく分けられます。小さなモデルはブラウザ・ノートブックの自動化に軽く、大きなモデルはより複雑な答えを狙うことができますが、メモリと最初のトークン2待機が増えます。 512Kコンテキストサポートも、すべての内容を毎回入れるという意味ではありません。頻繁に行う作業と機器のメモリを最初に決めると、候補が急速に絞り込まれます。
モデルサイズよりも預ける事を先に選びます
メールの分類と短いコマンド変換のように、答えが短く、規則が明確なことは0.9Bまたは3.7Bからテストします。個人文書の要約と一般的な会話、簡単なコーディングは、7Bのバランスを取ることができます。複数のファイルの関係を考慮したコーディングと複雑な推論で、小さなモデルの失敗が繰り返されるときに32Bまたは36B-A4Bを確認します。
同じ質問をサイズ別に送信し、正解かどうか、根拠引用、最初のトークンと完了時間を一緒に書きます。より大きなモデルが文を長く書くという理由だけでは選択しません。小さな候補が必要な答えを安定的に出すことは、残りのメモリと高速な応答が大きな利点です。
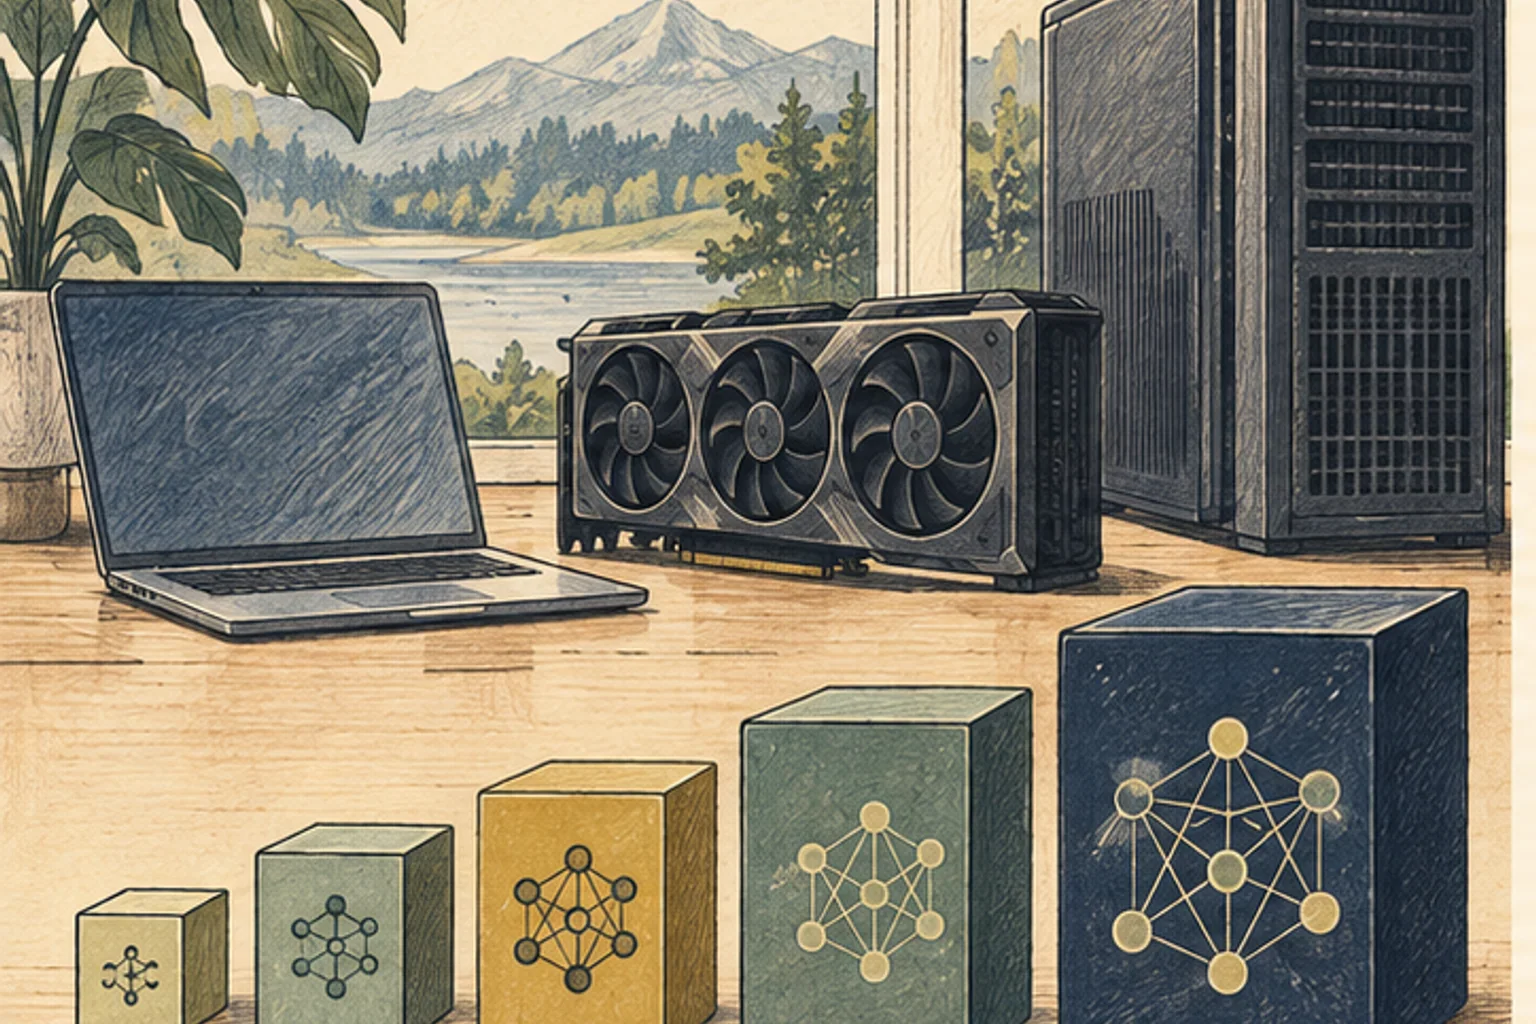
0.9B・3.7B・7Bは常にオンにしておきやすい区間です
32Bの密集型は24GBおよび32GB装置の境界で見る
32B Q4ファイルは24GB GPUから短いコンテキストに入ることができますが、ランタイム5とKVキャッシュの余裕がギリギリかもしれません。 32GB以上のVRAM6または統合メモリは、他のアプリと長いコンテキストを一緒に維持しやすくなります。メモリが不足してシステムRAM7のオフロード8が開始されると、実行可能性と体感速度が大きく異なります。
32Bはすべてのトークンで完全な重み付けを使用するため、シングルユーザーデコード9はメモリ帯域幅10の影響を受けます。同じ32GB表示でも、メモリ帯域幅とエンジンが異なる場合、速度は異なります。サイトの速度比較で機器を変更し、モデルが入っているかどうかとトークン生成速度を別々に確認してください。
36B-A4Bは4Bモデルのように軽くロードされません
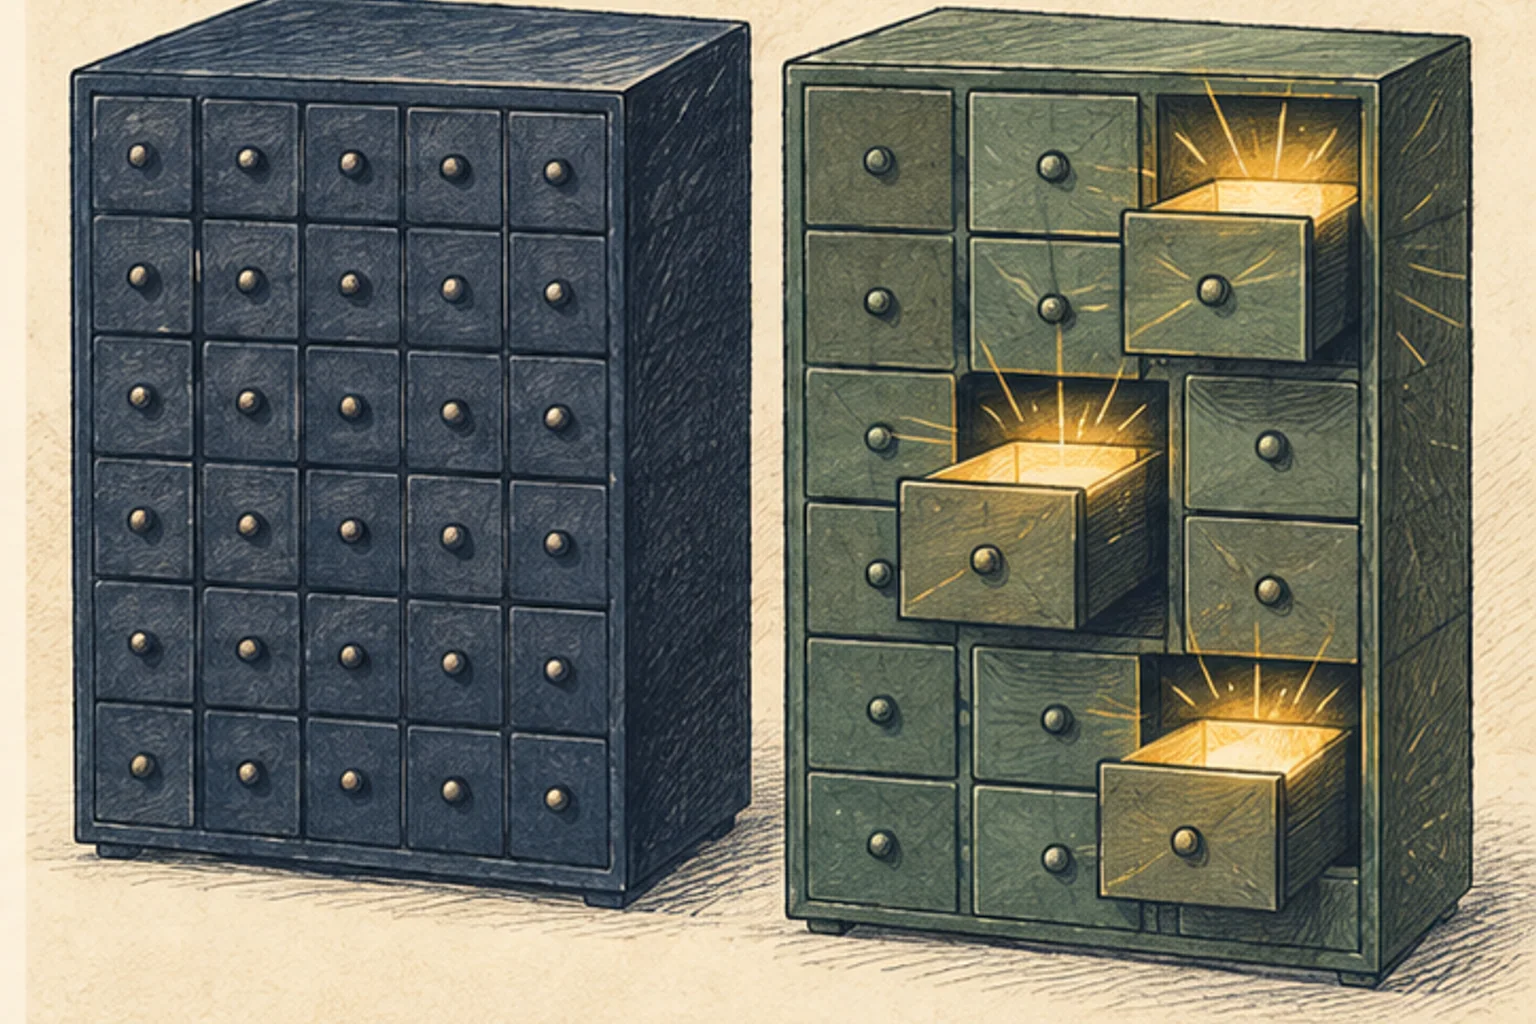
MoVA 36B-A4Bは約36B全体を保持し、トークンあたり約4Bをアクティブにします。アクティブ4Bは計算パスを記述しますが、必要なストレージ容量が4Bになるという意味ではありません。 Q4でも、完全な専門家の重みとKVキャッシュがアクセス可能なメモリに存在する必要があります。
重みが高速メモリに入ると、アクティブ計算量のおかげで、32B密集型よりもデコードが有利な組み合わせが発生する可能性があります。逆に、一部の専門家が遅いRAMまたはストレージから頻繁に呼び出されると、その利点は消えます。公式のvLLMの例では、2つのアクセラレータとエキスパートの並列を使用しているため、デスクトップGGUF11と同じ条件ではありません。
512Kは段階的に開く必要があります書くことができます
長いコンテキストをサポートしても、最初のトークンまで読み取る時間とKVキャッシュが線形に小さくなることはありません。 4Kで答えの品質と速度を保存し、16K・64K順に増やして必要な情報を実際に探しているか確認します。 512Kの数字だけを見てファイル全体を入れると、待ち時間が増え、重要な根拠を見逃すことがあります。
購入前に、頻繁に書き込む入力の長さで3回繰り返した中央値を表示します。 7Bが必要な答えを出し、32Bが大きな違いを生み出すことができない場合、より大きな機器は必要ありません。対照的に、32Bまたは36B-A4Bでのみ繰り返し解決される問題がある場合は、その時点でメモリの余裕と電力、購入コストを一緒に比較します。
用語の注釈
MoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。1トークンが1文字や一定の時間に相当するわけではありません。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあり、GPUランタイムライブラリと完成したサービングアプリは別の構成要素です。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を置き、システムRAMとは区別されます。
本文に戻るシステムRAM — プログラムの実行中にデータを一時保存するシステムメモリです。ストレージや独立GPUのVRAMとは異なります。
本文に戻るオフロード — 容量が足りないとき、モデルデータの一部をGPUメモリからシステムRAMやストレージへ移して処理する方法です。データ転送が追加されます。
本文に戻るデコード — LLMでは入力処理後に出力トークンを生成する段階です。VAEやオーディオコーデックでは、圧縮表現や符号化データから元の形式を復元する処理を指すことがあります。
本文に戻るメモリ帯域幅 — メモリとプロセッサー間で単位時間に転送できるデータ量です。実効処理量はアクセスパターンや他のボトルネックにも左右されます。
本文に戻るGGUF — モデル情報を格納するファイル形式で、llama.cpp系のツールで広く使われます。形式だけで特定ハードウェアへの対応や速度が保証されるわけではありません。
本文に戻る