
実行プログラムと拡張機能
最終更新
Laya-MLX:Macで13msで選択を終える決定モデル
文章を生成せず、確率だけを計算します
Laya-MLXは4億2,100万パラメータの決定モデルをMLX1で実行するPythonパッケージです。文章を生成せず、選択肢ごとの確率を1回の計算で出します。短い質問1件で約13ms、50件をまとめると毎秒146.8件を処理します。
答えを書かず確率だけを計算します
Laya-MLXは文章を作りません。状態と質問を一緒に入れ、決められた選択肢ごとに確率を返します。出力トークン2が0個なのはこのためです。
構造はエンコーダと決定ヘッドに分かれます。双方向エンコーダが状態と質問を一緒に読み、ヘッドが確率を計算します。トークンを1つずつつなぐ処理がないため遅延が短くなります。
生成モデルに選択を任せると、答えを文章で受け取って再び解析する必要があります。形式が崩れれば再試行が増え、その分だけ遅延も増えます。確率を直接受け取れば解析の段階がなくなります。
モデルは4億2,100万と3億2,200万の2系統です。同じMacで生成モデルを動かす場合に比べ、メモリ使用量は1GB未満です。
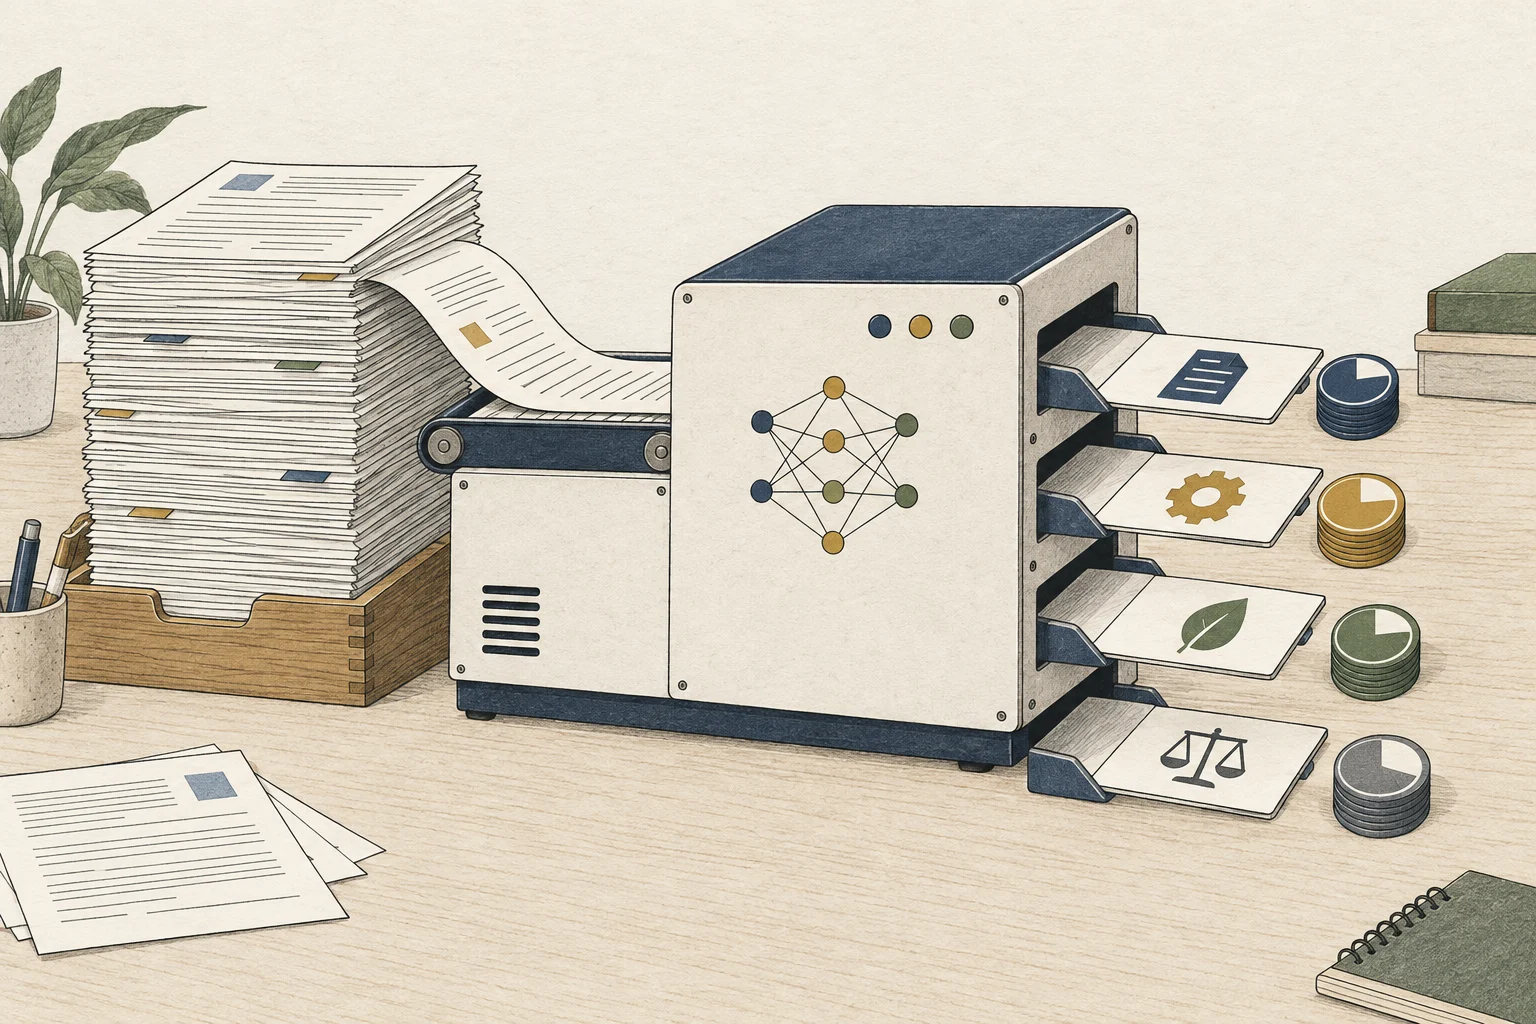
選択・スコア・真偽の3種類の質問です
選択は名前の付いた候補のどれに当たるかを確率で答えます。スコアは決められた段階に当たる確率と期待値を出し、真偽は命題が正しい確率を1つ返します。
| 種類 | 返る値 | 使う場面 |
|---|---|---|
| 選択型 | 候補ごとの確率 | 分類・ルーティング |
| スコア | 段階の確率と期待値 | 品質評価 |
| 真偽 | P(真)を1つ | 条件の確認 |
文章を書いたり複数段階を推論したりする用途には向きません。決められた候補から選ぶ、決められた段階に評価を付ける作業のためのツールです。
インストールして最初の決定を受け取ります
パッケージをインストールし、モデルを読み込んで状態と質問を渡します。以下の例は問い合わせ文を3つの部署のどれかに振り分けるコードです。
pip install laya-mlx初回の読み込みでチェックポイント3を取得し、それ以降はローカルだけで実行されます。Python 3.11以上とmacOS 14以上が必要です。
import laya_mlx as laya

agent = laya.load("aac6fef/laya-mlx")
result = agent.predict(
    "I was billed twice. Please refund the duplicate.",
    {"department": {
        "type": "choice",
        "instructions": "Who should handle this?",
        "criteria": ["billing", "technical", "sales"],
    }},
)
print(result["answers"]["department"])3つのチェックポイントから選びます
英語だけなら421Mモデルで足り、複数言語が混ざるなら多言語チェックポイントが速くなります。コンテキストの上限がそれぞれ違うため、長い指示を入れる前にこの値を確認します。
左右にスクロールして各項目を比較できます。
| チェックポイント | パラメータ | コンテキスト上限 | 使う目的 |
|---|---|---|---|
| Laya | 4億2,100万 | 512トークン | 英語入力 |
| 多言語 | 3億2,200万 | 1,024トークン | 多言語入力 |
| 型付き決定 | 4億2,100万 | 1,024トークン | 上流のワークフロー移植 |
変換済みのFP166チェックポイントが公開されているため、原本から自分で変換しなくてもそのまま読み込めます。
Macで測った遅延と処理量です
測定環境はM3 Maxの40コアGPUと128GBメモリです。時間にはプロンプト7準備、トークン化、同期された推論、キャリブレーション、結果の整形が含まれ、モデルの読み込み時間は含みません。
| 測定項目 | Laya 421M | 多言語 322M |
|---|---|---|
| 短い質問 P50 | 13.42ms | 7.39ms |
| 短い質問 P95 | 13.92ms | 7.79ms |
| 50件まとめた処理量 | 毎秒146.8件 | 毎秒395.0件 |
| 最大メモリ使用 | 943.6MiB | 687.6MiB |
質問の長さと件数が変われば値も変わります。表の数字は短い質問1件と50件のまとめを測ったもので、長い指示を入れると遅延が増えます。
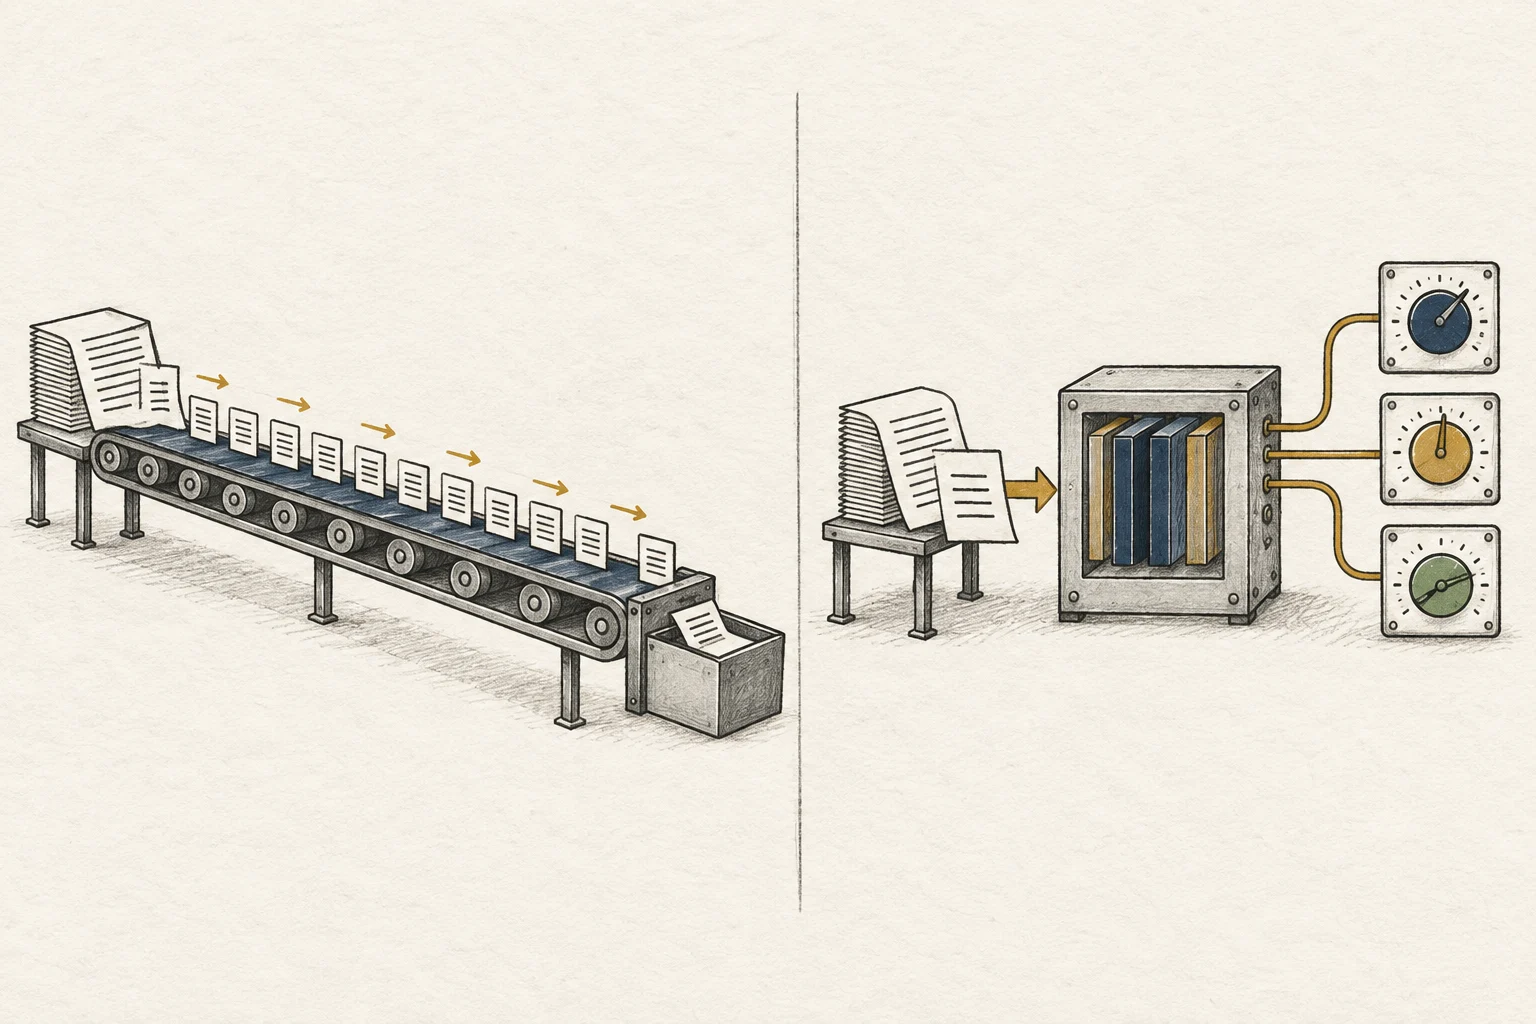
同じ答えを出すかを先に確認しました
MLXに移植した実装が原本と同じ選択をするかを63の検証質問で確認しました。FP328とFP16の両方で63件すべてが一致し、378回の比較がすべて通りました。
同じ呼び出しを100回繰り返しても結果は有限で同一であり、メモリ使用量も増えませんでした。これはそれらの検証質問についての結果で、すべての質問で同じという意味ではありません。
ゲームのデモも同じ検証に使われます。スネークの1プレイで2,400回の移動を処理し、安全装置が2回介入し、途中で止まりませんでした。
速度より先に見たのがこの一致です。確率を使う場面では1%の差が判断を変えるため、移植した実装が原本と同じ答えを出すことが出発点になります。
アプリやサーバーにつなぎます
移植版であることを踏まえて使います
このパッケージは原作者の公式配布ではなく、MLXへ移植した独立ポートです。重みや質問形式、キャリブレーション、出力スキーマは原本のままですが、対応範囲は原本と異なります。
CUDA12やONNXでの実行、学習は含まれていません。学習が必要なら上流のプロジェクトを使い、このパッケージは推論と変換だけを担当します。
原本プロジェクトのどのバージョンに追従しているかがリポジトリに記録されています。その記録を原本の文書と照らせば、まだ無い機能を確認できます。
測定はmacOS 27.2で行われ、より古いmacOSで同じ値になるとは限りません。使い始めるときは短い質問で遅延を自分で測るのが安全です。
用語の注釈
MLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るCPU — OSや一般的なプログラム命令を実行する中央処理装置です。AIでは前処理やデータ転送などの汎用処理も担います。
本文に戻るFP16 — 16ビット浮動小数点形式です。BF16とビット幅は同じですが、指数部と仮数部の配分が異なります。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るFP32 — 32ビット浮動小数点形式です。BF16より値あたりのメモリを多く使い、数値をより細かく表現できます。
本文に戻るMCP — モデルが利用できるツールやデータソースをクライアントに接続するためのプロトコルです。接続可能であることと、個別のツールを実行する権限は別に設定する必要があります。
本文に戻るパイプライン — 入力から出力まで続く処理段階のまとまりです。段階ごとに異なるモデルやツールを使うことがあります。
本文に戻るバッチサイズ — 1回の処理単位にまとめる入力またはリクエストの数です。
本文に戻るCUDA — NVIDIA GPUで汎用計算を行うソフトウェア基盤です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Laya-MLXは4億2,100万パラメータの決定モデルをMLXで実行するPythonパッケージです。文章を生成せず、選択肢ごとの確率を1回の計算で出します。短い質問1件で約13ms、50件をまとめると毎秒146.8件を処理します。
- 必要なメモリはどのくらいですか?
- モデルは4億2,100万と3億2,200万の2系統です。同じMacで生成モデルを動かす場合に比べ、メモリ使用量は1GB未満です。