
モデル別実行レシピ
最終更新
OCRなしでPDFページを探すColPali・ColQwenガイド
ページ画像の視覚表現を検索し、文字抽出は別のツールで行います。
ColPaliはPDFページの画像を受け取り、ページごとの多ベクトル表現を作成して、質問に合うページを検索します。表の配置などの視覚情報も検索の手掛かりになります。
ページ自体を検索対象にします
ColPaliはPDFページの画像を受け取り、ページごとの多ベクトル表現を作成して、質問に合うページを検索します。表の配置などページ上の見た目も手掛かりにできるため、OCR1で抽出したテキストだけを検索する方法よりレイアウトを活用できます。
文書群から「3つ目の表にある保証期間」のような質問を選び、根拠のあるPDFページを先に記録します。検索はページ候補を絞る段階で、最終回答を生成する処理ではありません。
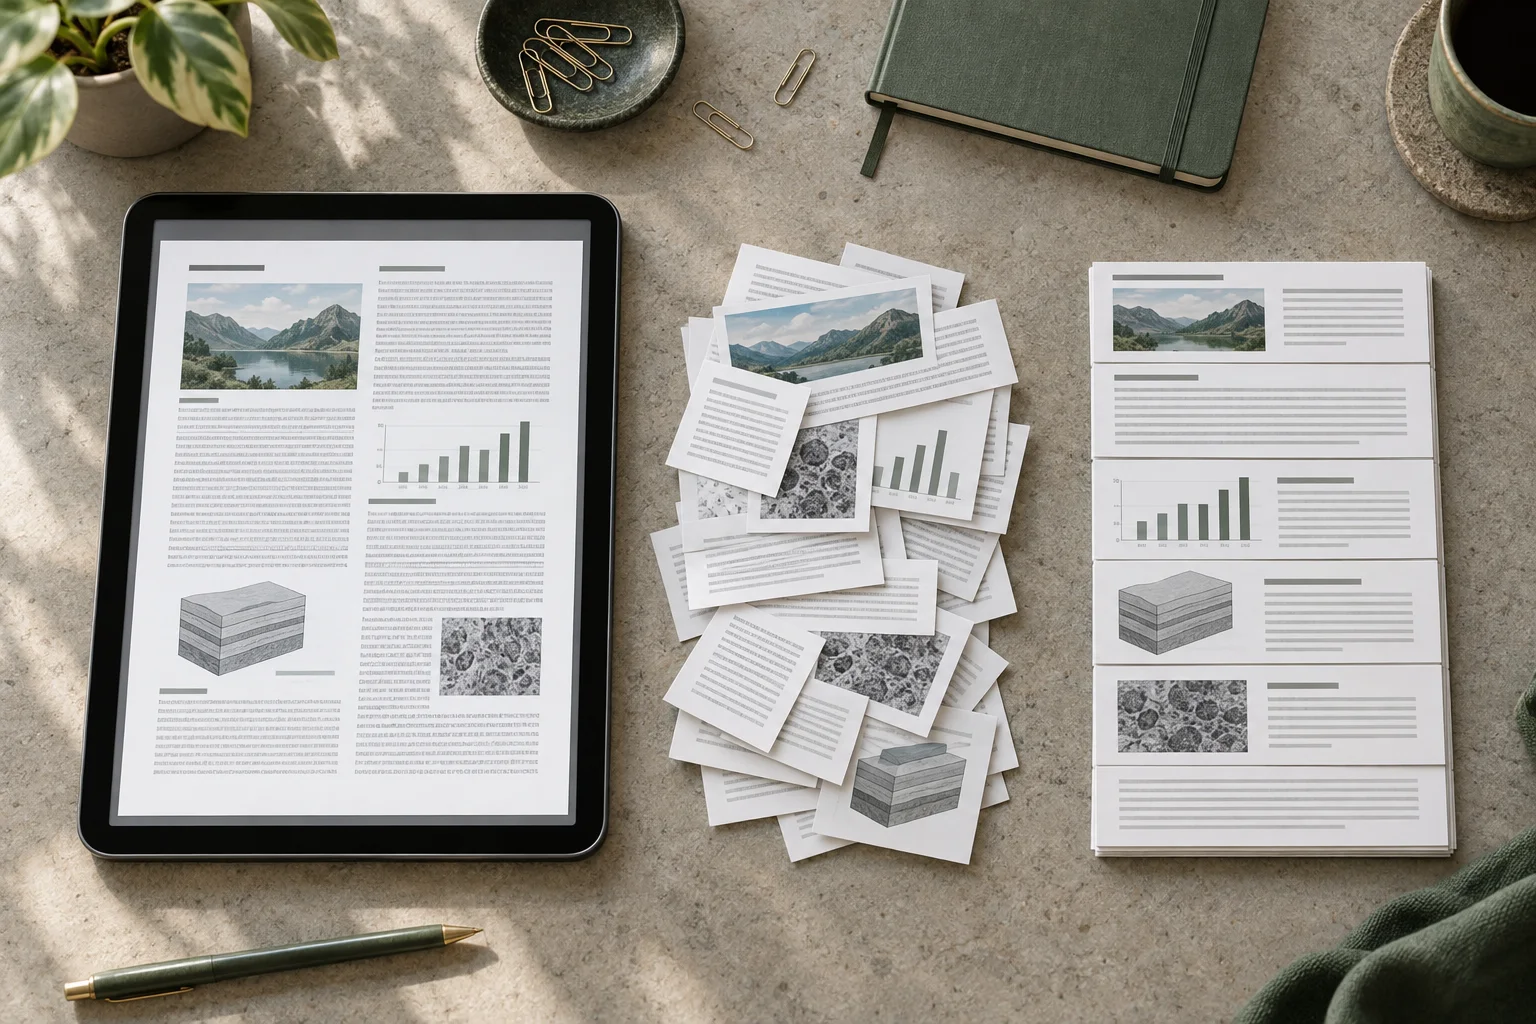
検索と抽出を分けて評価します
検索は正解ページが上位k件に入る割合で評価し、OCRは文字誤り率や項目精度で別に測ります。ページを見つけても、セル境界・読み順・小さな文字が正しく抽出されたとは限りません。
同じPDFでColPaliとColQwenを比較し、ページID・順位・検索時間を保存します。必要な表や文章は原本で確認し、引用用テキストはOCRや文書パーサーで抽出します。
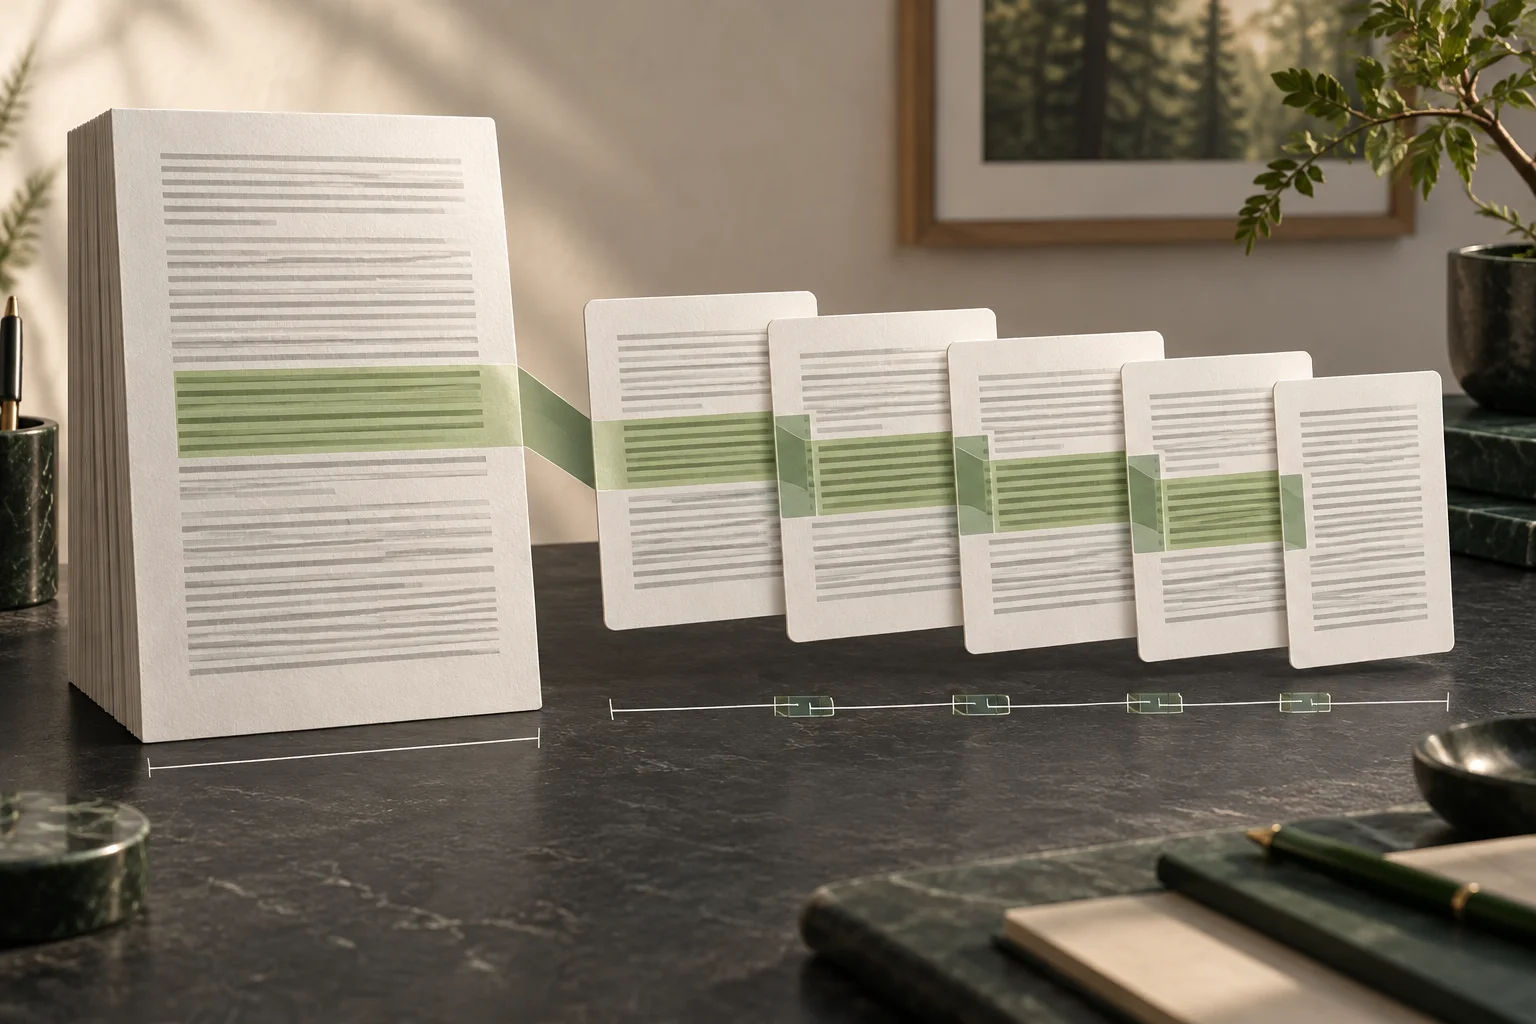
索引容量とページ描画のコストを確認します
このcodeはlayoutや表を手がかりに候補ページを検索します。ColPaliとColQwenを比べる場合は、同じPDF・質問・正解ページ・描画条件を両modelに適用して結果を集めます。
検索例はページ番号とscoreをJSONで返します。OCR文字精度やfield抽出品質は別のparser実験で確認します。
表から数字を一つ取り出す作業が中心なら、ページ検索モデルを先に入れる必要はありません。文書が数枚しかない、またはOCRテキストがすでに整っているなら、まずキーワード検索と文書パーサーで試してください。
python -m venv .venv
source .venv/bin/activate
python -m pip install -U 'sentence-transformers[image]>=6.0.0' pymupdf pillowimport fitz
doc = fitz.open()
page = doc.new_page(width=595, height=842)
page.insert_text((72, 90), "Product comparison", fontsize=20)
page.insert_text((72, 150), "Model | Warranty", fontsize=13)
page.insert_text((72, 185), "Atlas | 2 years", fontsize=12)
page.insert_text((72, 220), "Nova | 1 year", fontsize=12)
page2 = doc.new_page(width=595, height=842)
page2.insert_text((72, 90), "Support contacts", fontsize=20)
page2.insert_text((72, 150), "Email: help@example.test", fontsize=12)
doc.save("report.pdf")
print("saved report.pdf")import fitz, json, time
from PIL import Image
from sentence_transformers import MultiVectorEncoder
pdf_path = "report.pdf"
query = "Which page shows the warranty period in the comparison table?"
model = MultiVectorEncoder("vidore/colqwen2.5-v0.2")
page_images = []
start = time.perf_counter()
with fitz.open(pdf_path) as pdf:
for page_number in range(1, min(len(pdf), 20) + 1):
page = pdf[page_number - 1]
pix = page.get_pixmap(matrix=fitz.Matrix(1.5, 1.5), alpha=False)
image = Image.frombytes("RGB", [pix.width, pix.height], pix.samples)
page_images.append((page_number, image))
query_vectors = model.encode_query([query])
page_vectors = model.encode_document([image for _, image in page_images])
scores = model.similarity(query_vectors, page_vectors)[0]
ranked = scores.argsort(descending=True).tolist()[:5]
print(json.dumps({"query": query, "pages_rendered": len(page_images), "elapsed_s": round(time.perf_counter() - start, 3), "top_pages": [{"page": page_images[i][0], "score": float(scores[i])} for i in ranked]}, indent=2))python make_report.py
python colpali_search.py
用語の注釈
OCR — 画像やスキャン文書の文字を認識してテキストにする処理です。表の配置や読み順は、元の画像を合わせて確認する必要があります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- ColPaliはPDFページの画像を受け取り、ページごとの多ベクトル表現を作成して、質問に合うページを検索します。表の配置などの視覚情報も検索の手掛かりになります。