
モデル別実行レシピ
最終更新
Gemma 4 26B-A4B MTP:単一リクエストと複数リクエストで変わる速度
Gemma 4 26B-A4BでMTP requestを比較します
Gemma 4 26B-A4Bは文書や写真と質問を入力し、テキスト回答を生成するMoE1モデルです。全25.2Bのうちトークン2ごとに約3.8Bで計算し、実行には全重みとコンテキスト用KVキャッシュ3を用意します。MTP4を使うと補助モデルが次のトークン候補を提案し、本モデルが検証することで回答生成時間を短縮できる場合があります。
まず本モデル(target)だけで文書を最後まで処理できるか確認します。その後、同じMLX-VLM環境で補助モデル(assistant drafter)を加え、同じ質問を送ります。最初のトークンまでと、その後の回答生成を分けて比べると、普段の作業にMTPが役立つか分かります。
全重みと活性計算を分けて考えます
長い設計文書から変更点を探す場合、26B-A4Bの「active 3.8B」という数字だけでメモリを見積もらないようにします。token生成時には一部のexpertだけが活性化しますが、runtime5は選択対象となる約25.2B全体の重みを準備します。文脈用KV cacheとOS・runtimeのメモリも加わります。
Q4デスクトップ経路では文脈8K、同時request 1件を比較の出発点にします。これは全機器にとって最適という意味ではありません。まずtarget-onlyで実際の文書質問が完了するか確かめ、基準動作が安定してからassistant drafterを加えます。
Googleが2026年5月に公開したGemma 4 MTP drafterはtargetと組み合わせるassistant checkpoint6です。任意の小型chat modelで代用するものではなく、アプリとruntimeがassistant形式とMTPに対応している必要があります。
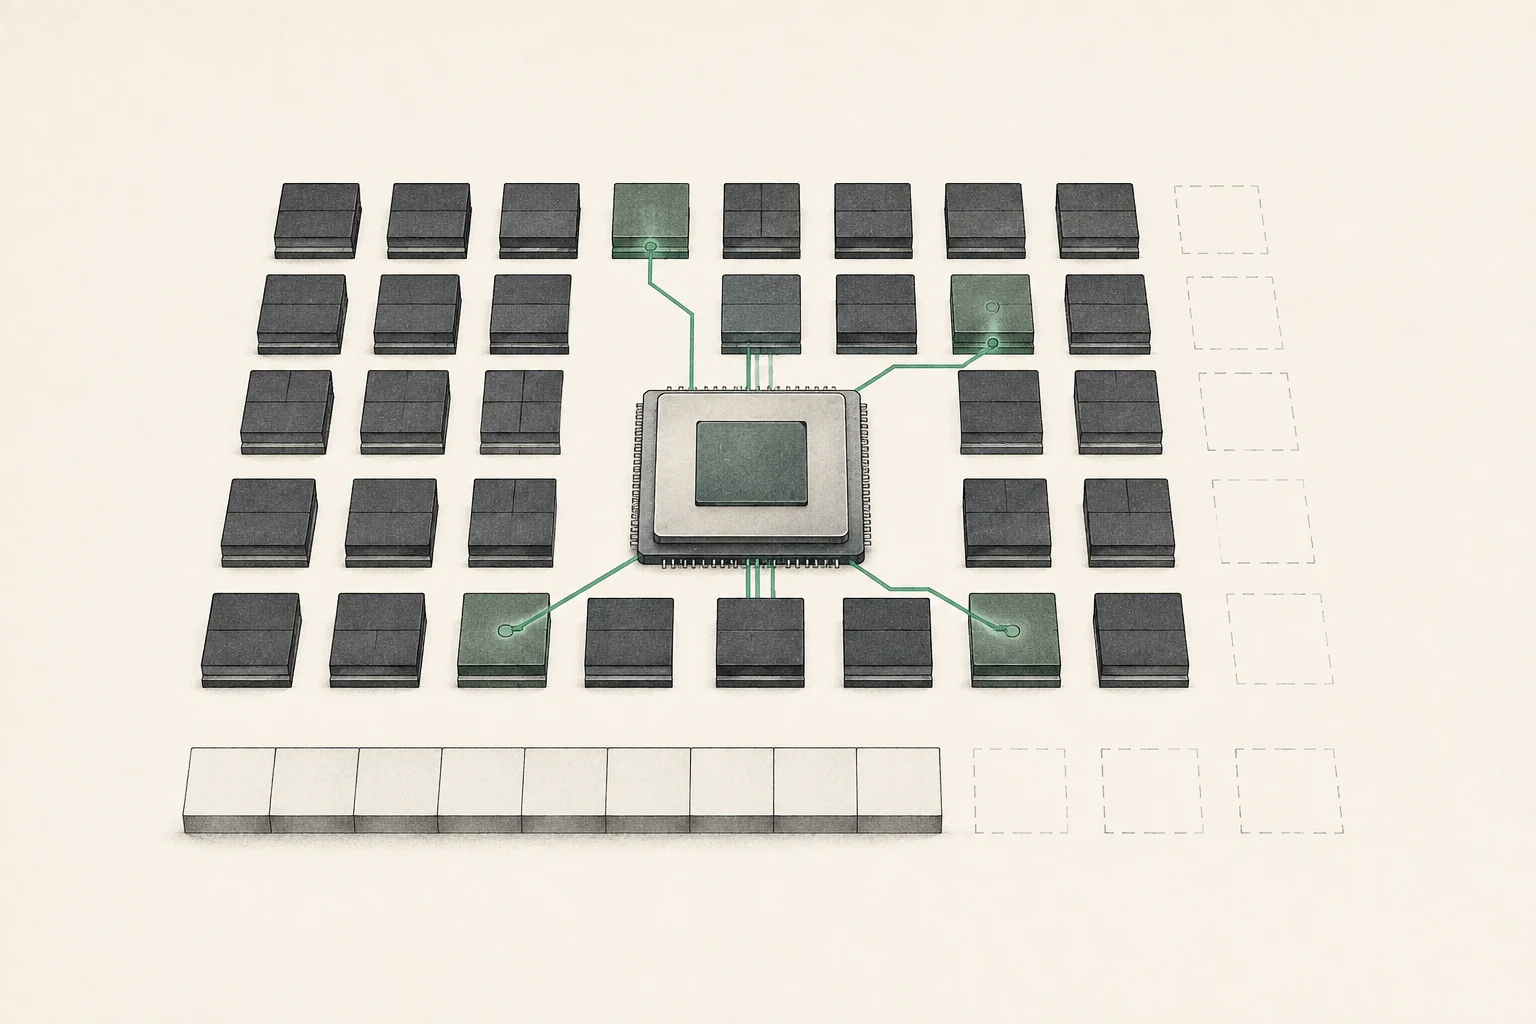
草案候補を検証するMTPの動きを理解します
通常の生成ではtargetが次tokenを一つずつ計算します。MTPでは4層assistant drafterが続くtoken候補を先に提案し、targetが候補群を検証します。候補が合えばtargetの計算1回で複数tokenを確定でき、decode7待ちを減らせる場合があります。不一致の候補は採用せずtargetの出力に続きます。
効果は草案が次tokenとどれほど一致するかで変わります。採用率が高ければdecode時間を短縮できますが、低ければdraft計算とメモリが追加されます。長い入力のprefill8が待ち時間の大半なら、生成部分の改善だけでは全体応答時間があまり短くならない場合があります。
Googleは2026年5月の発表で、Apple Siliconのbatch 1ではrouting challengeがあり、batch 4~8では最大約2.2倍の改善を観測したと述べています。この結果は発表のモデル・runtime・request batch条件に該当します。個人Macの単一requestや別の量子化9アプリに一般化せず、batch size10とprompt11・出力token数を記録します。
| 測定区間 | 確認する内容 | 記録する条件 |
|---|---|---|
| モデル読み込み | targetとassistantをメモリに載せられるか | cold start、重みの精度、ピークメモリ |
| Prefill / TTFT | 長文書を読み最初のtokenを出すまでの時間 | 入力token数、warm/cold prefix、文脈 |
| デコード | 最初のtoken後にどれほど速く生成が続くか | 出力長、採用token、temperature |
| request全体 | 開始から完了までの時間 | batch、同時実行数、warmupと反復回数 |
MLX-VLMでtarget-only基準を作ります
この手順ではApple Silicon上のMLX-VLMで同じBF1612 targetを先に実行し、対応するBF16 assistant drafterを加えたMTPと比較します。2つのモデルfileを準備するメモリが必要です。Q4 LM Studioの結果を混ぜず、同じMLX-VLM内でtarget-onlyとMTPを比較します。
初回にはモデルdownloadと読み込み時間が含まれる場合があります。読み込み完了と応答を確認した後、同じpromptと256 token上限でtarget-onlyを3回記録します。続いてdrafter付きcommandを同条件で実行します。logでassistantの読み込みとdraft acceptance統計も確認します。
両方の実行で回答が出て、MTP logに採用情報があるか確認します。temperature 0でも出力文が異なる場合は記録し、runtime version・checkpoint・prompt template・logを調べます。公開された効率と自分の測定値は分けます。
python -m pip install -U mlx-vlm
mlx_vlm.generate --model mlx-community/gemma-4-26B-A4B-it-bf16 --prompt "Design note: The Northstar launch moves from May 12 to May 19. The API freeze remains May 5. Summarize the changed date and the unchanged milestone." --max-tokens 256 --temperature 0
mlx_vlm.generate --model mlx-community/gemma-4-26B-A4B-it-bf16 --draft-model mlx-community/gemma-4-26B-A4B-it-assistant-bf16 --draft-kind mtp --draft-block-size 6 --prompt "Design note: The Northstar launch moves from May 12 to May 19. The API freeze remains May 5. Summarize the changed date and the unchanged milestone." --max-tokens 256 --temperature 0
単一requestとbatch処理を分けて測ります
target-onlyとMTPをそれぞれ単一requestとして実行します。同じpromptと出力上限を使い、warm-up後に3回以上繰り返し、初回file読み込みをwarm測定と分けます。中央値、回答漏れ、採用token数、peak memoryを記録します。長い入力では生成速度だけでなく最初のtokenと全体完了時間も見ます。
複数requestを処理するserverは別に試験します。batchを変える際はprompt・出力長・request数だけを調整し、model fileとdraft block sizeは保ちます。個人の応答性が目的なら単一requestの待ち時間、server容量が目的ならrequestごとの遅延と総処理量を合わせて見ます。
採用率が低い、またはdraft overheadで遅くなる場合、その作業ではtarget-onlyの方が適することがあります。throughput13増加だけで各利用者の応答が速くなったと判断せず、実際のrequest構成で決めます。
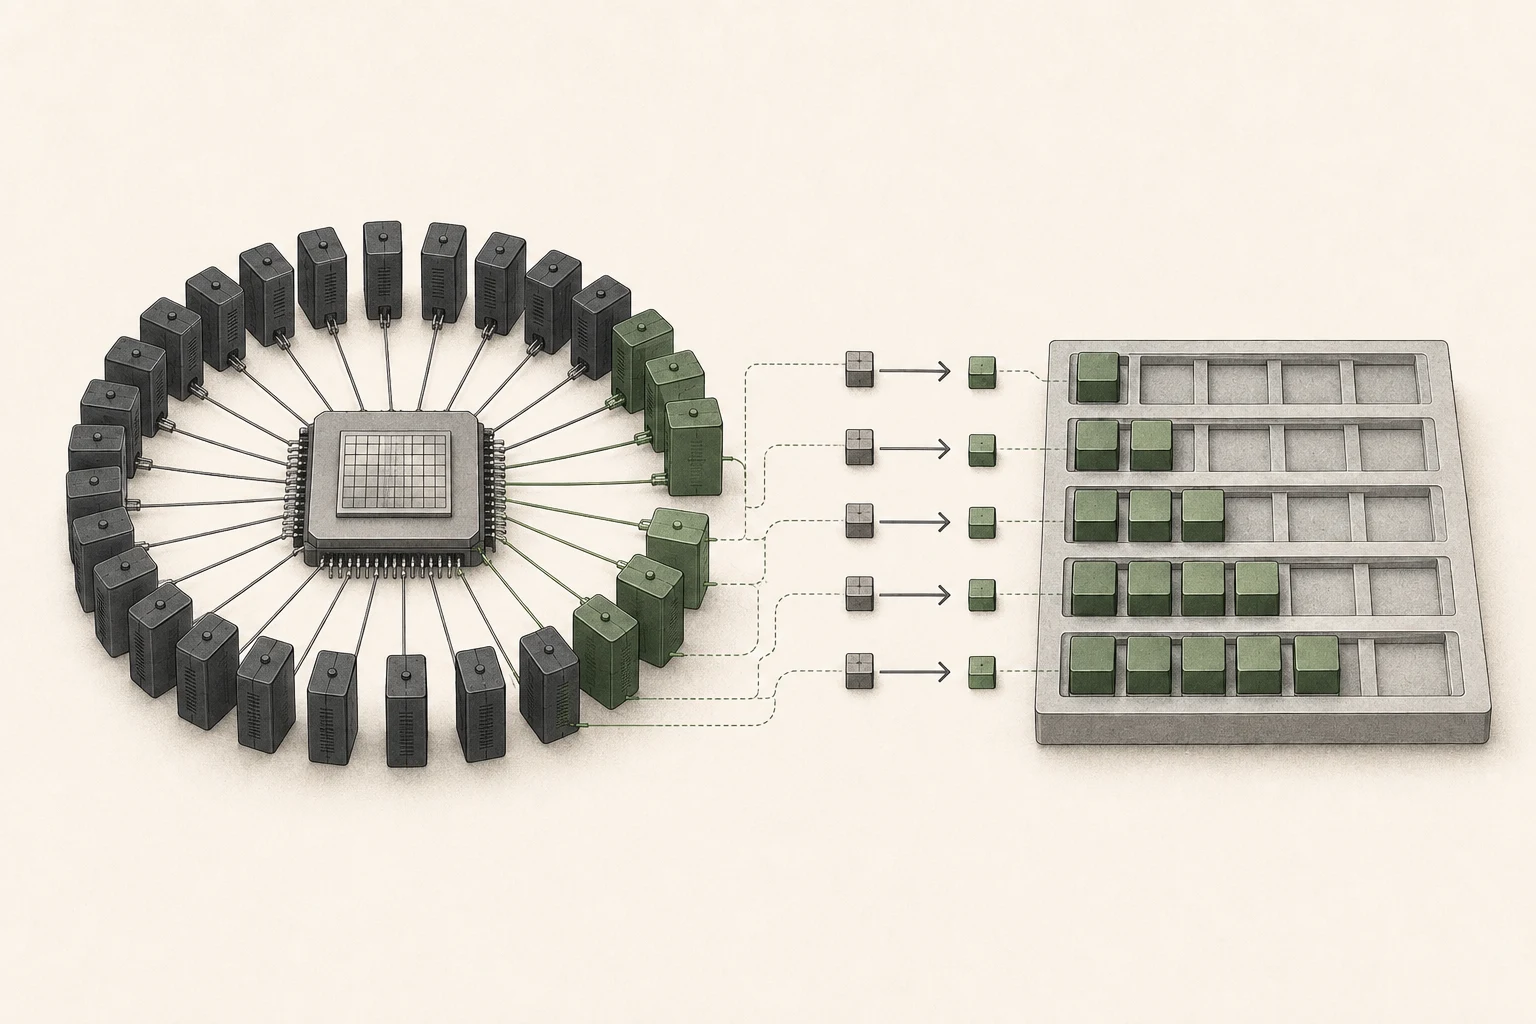
メモリ問題と生成待ちに合わせて機能を選びます
QATは重み表現と圧縮効率を変えてメモリ要求を下げる選択肢で、MTPは生成中に候補tokenを検証して待ち時間を減らす選択肢です。QAT targetでMTPを使うには、両機能に対応したtarget/drafterの組を確認します。ファイル名にQATやMTPがあるだけでは互換性は分かりません。
target自体が読み込めないなら、まずfile精度とメモリ余裕に対処します。targetが動作し、回答生成が主なボトルネックならMTPを比較します。入力を読む時間が長いならprefillとcache条件を先に確認します。target-onlyの方が速ければ、そのworkloadにassistantを加えない方が適しています。
公式発表と実行資料を確認します
MTPの仕組みとApple Siliconのbatch結果はGoogleが2026年5月に公開した条件です。CLI14例はMLX-VLMの公開commandとGemma 4 pairingに従っています。本稿は機器別性能を新たに測定していないため、個人の測定値はモデル・runtime・request条件とともに記録します。
用語の注釈
MoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るMTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るバッチサイズ — 1回の処理単位にまとめる入力またはリクエストの数です。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るBF16 — モデルの数値に使う16ビット浮動小数点形式です。指数部はFP32と同じ幅で、同程度に広い値の範囲を表せます。
本文に戻るスループット — 一定時間に処理・生成した作業量です。トークン/秒やリクエスト/秒など、単位を合わせて比較します。
本文に戻るCLI — Command-Line Interfaceの略です。ターミナルにコマンドを入力してプログラムを操作する方式です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Gemma 4 26B-A4Bは文書や写真と質問を入力し、テキスト回答を生成するMoEモデルです。全25.2Bのうちトークンごとに約3.8Bで計算し、実行には全重みとコンテキスト用KVキャッシュを用意します。MTPを使うと補助モデルが次のトークン候補を提案し、本モデルが検証することで回答生成時間を短縮できる場合があります。
- 必要なメモリはどのくらいですか?
- この手順ではApple Silicon上のMLX-VLMで同じBF16 targetを先に実行し、対応するBF16 assistant drafterを加えたMTPと比較します。2つのモデルfileを準備するメモリが必要です。Q4 LM Studioの結果を混ぜず、同じMLX-VLM内でtarget-onlyとMTPを比較します。
実行レシピ
機器別の設定
1人で使う場合
使う機器を選ぶと、起動コマンドと調整できる設定が表示されます。
プロファイル
Apple MacBook Pro M5 Pro (64GB)
メモリに収まる推奨ランタイム: LM Studio (MLX 4ビット(GGUF Q4_K_Mとは別形式)) · ドキュメントに基づくランタイム設定
インストール後の初回実行や、毎日安定して使いたいときに
プロファイルのコンテキスト長
16,384 トークン
ランタイムのドキュメントに基づく初期設定です。下の手順に沿って調整し、速度を比べてください。
デコード速度の推定値
26.9 ~ 65.4 tok/s
1人で使う場合の推定値
最初のトークンまでの推定時間
8.8 ~ 21.5秒
プリフィル: 765 ~ 1,861 tok/s
推定メモリ使用量
約 16.34GB / 56GB
残余の余裕:少ない 39.7GB
サーバーアドレス
http://127.0.0.1:1234
ローカルのみ · 127.0.0.1
推定値は、計算ツールが推奨する量子化・高速化設定と 16,384トークンを基準にしています。上記の実行設定を測定した値ではありません。
このプロファイルの設定
| 設定値 | この設定にする理由 |
|---|---|
| 重みMLX 4ビット(GGUF Q4_K_Mとは別形式) | MLXモデルのディレクトリを使います。Q4_K_MのGGUFとはファイル形式が異なります。 |
| 入力長の確認16,384 | lms loadのcontext-length設定と、実際に読み込まれたコンテキスト長を合わせて確認します。 |
| KVキャッシュモデル設定で確認 | この起動コマンドではKVキャッシュの精度を指定していません。 |
| プリフィルのバッチサイズランタイム設定で確認 | llama.cppのbatch-sizeとubatch-sizeを、MLXの設定値としてそのまま使わないでください。 |
| 同時リクエスト数1 | 1件のリクエストの速度を測ります。複数リクエストを合わせた処理量とは分けて確認します。 |
| メモリの余裕2GB以上 | モデルの読み込み後に、実際のメモリ使用量とスワップの有無を確認します。 |
MBP M5 Pro 64GB 実行コマンド(LM Studio)
# lms ls에서 확인한 MLX 4비트 모델 식별자를 입력
MODEL_ID=""
lms ls
: "${MODEL_ID:?MLX 모델 식별자를 입력하세요}"
lms load "$MODEL_ID" --gpu=max --context-length=16384
lms server start --port 1234起動後の確認
- 01起動ログで、モデルの読み込み完了と実際のコンテキスト長を確認します。
- 02ウォームアップ後はリクエストを1件ずつ送ります。同じ長さの異なる入力を3つ使い、キャッシュを再利用しない初回の処理時間を記録します。
- 03同じ入力を繰り返した結果は、キャッシュ再利用の記録として分けます。初回入力の結果と混ぜないでください。
- 04プリフィルtok/s、デコードtok/s、ピークメモリをまとめて記録し、その後は一項目ずつ変更します。
変わる点と注意点
- コンテキスト長と同時リクエスト数を控えめにしているため、機器の最大処理量より低い結果になることがあります。
1つずつ調整
高速化の手順
複数の値を一括で変更すると原因を特定するのが難しいです。
- STEP 1
基準値を保存
初回入力とキャッシュ再利用を分け、それぞれ3回記録します。プリフィル、デコード、ピークメモリを一緒に比較します。
とき: エラーがある場合やメモリの余裕が2GB未満の場合は、次の段階へ進まないでください。
- STEP 2
プリフィルのチャンクサイズを調整
1,024 → 2,048 → 4,096の順に増やし、長い入力のTTFTとピークメモリを比べます。
とき: TTFTが短くならない場合やピークメモリが急増する場合は、直前の値へ戻します。
- STEP 3
KVキャッシュ調整
コンテキスト長を確保したいときだけ、同じ質問でQ8キャッシュとF16/BF16の基準値を比較します。
とき: 出力に差が出る場合や、必要なコンテキスト長をすでに確保できている場合は、標準の精度を維持します。
- STEP 4
MTP・投機的デコーディング
対応モデルだけで有効にし、コードと通常の文章を分けて、採用率と実際のデコードtok/sを測定します。
とき: 3回の中央値が基準値より良くならなければ、無効に戻します。
- STEP 5
コンテキスト拡張
実際に必要な長さまで段階的に2倍ずつ伸ばし、入力途中の情報を見つけられるかと、スワップの有無を確認します。
とき: 情報を探す精度が落ちたり、スワップ・メモリ圧縮が始まったりしたら、一段階短くします。
自分の機器の測定記録を送る
同じ条件で3回以上測定したJSONを読み込んでください。送信ボタンを押すまでは、このブラウザ内でのみ確認します。
受け付けるのは機器・モデル・実行条件と測定値だけです。プロンプト・回答・元のログ・ファイルパスは含めないでください。
記録ファイルがなければ、起動中のローカルサーバーと測定ツールで作成できます。Node.js 20以上が必要です。結果の自動送信は行いません。
内容を確認したユーザーの投稿記録です。このサイトが直接測定した結果とは区別しています。
設定の問題を報告
この設定でどこにつまずいたかを教えてください。報告を読めるのは管理者だけです。
報告する設定 · MBP M5 Pro 64GB · Gemma 4 26B-A4B (MoE) · バランス
変更履歴
サイトの説明を変更した記録です。インストール済みのエンジンやモデルのバージョンを自動で確認した結果ではありません。
Macのモデル形式と実行設定を訂正
MacのMLX実行経路をGGUF Q4_K_Mと区別し、エンジン名・モデル形式・コマンドの表記を揃えました。コマンドで指定していないKVキャッシュ精度とプリフィルのバッチ設定は、モデル・ランタイム設定で確認する案内に変更しました。
コマンドは同じなのにバッチだけが大きくなるように見えていたMLX速度プロファイルも削除しました。
初回入力とキャッシュ再利用の記録を分離
検証手順を変更し、初めて読む入力と同じ入力を繰り返した結果を別々に記録するようにしました。キャッシュの効果を初回プリフィル処理量や機器の差に含めません。
機器・プロファイルの保存と再表示を追加
実行可能なプロファイルを機器の選択と一緒にこのブラウザに最大5件保存し、ガイド一覧から再び開けるようにしました。保存後に公開設定が変わったりプロファイルの提供が終了したりした場合は、実行前の再確認を案内します。
実行エンジンの説明へのリンクを追加
設定に表示されるエンジン名から、該当する実行プログラムの説明へ移動できるようにしました。エンジンを特定できない経路に、推測で別のプログラムをリンクすることはありません。