
新規モデル · 2026.10.23
最終更新
LFM2.5-24B-A2BのローカルLLM:韓国語対応24B MoEを自分のPCで
韓国語に対応した24B MoEをMacとNVIDIA PCで動かします
LFM2.5-24B-A2Bは、Liquid AIが2026年10月12日に公開した推論モデルです。64のエキスパートのうち4つだけを選ぶMoE1構造なので、重みは24Bを占めますが、1トークン2の計算量は約2.45Bです。韓国語を含む16言語に対応し、公式のGGUF3とMLX4 4bitファイルが同時に配布されているため、MacでもNVIDIA PCでも試せます。ただしモデルカードの184 tok/sはApple M5 Maxで測った値なので、自分の環境の速度として読んではいけません。
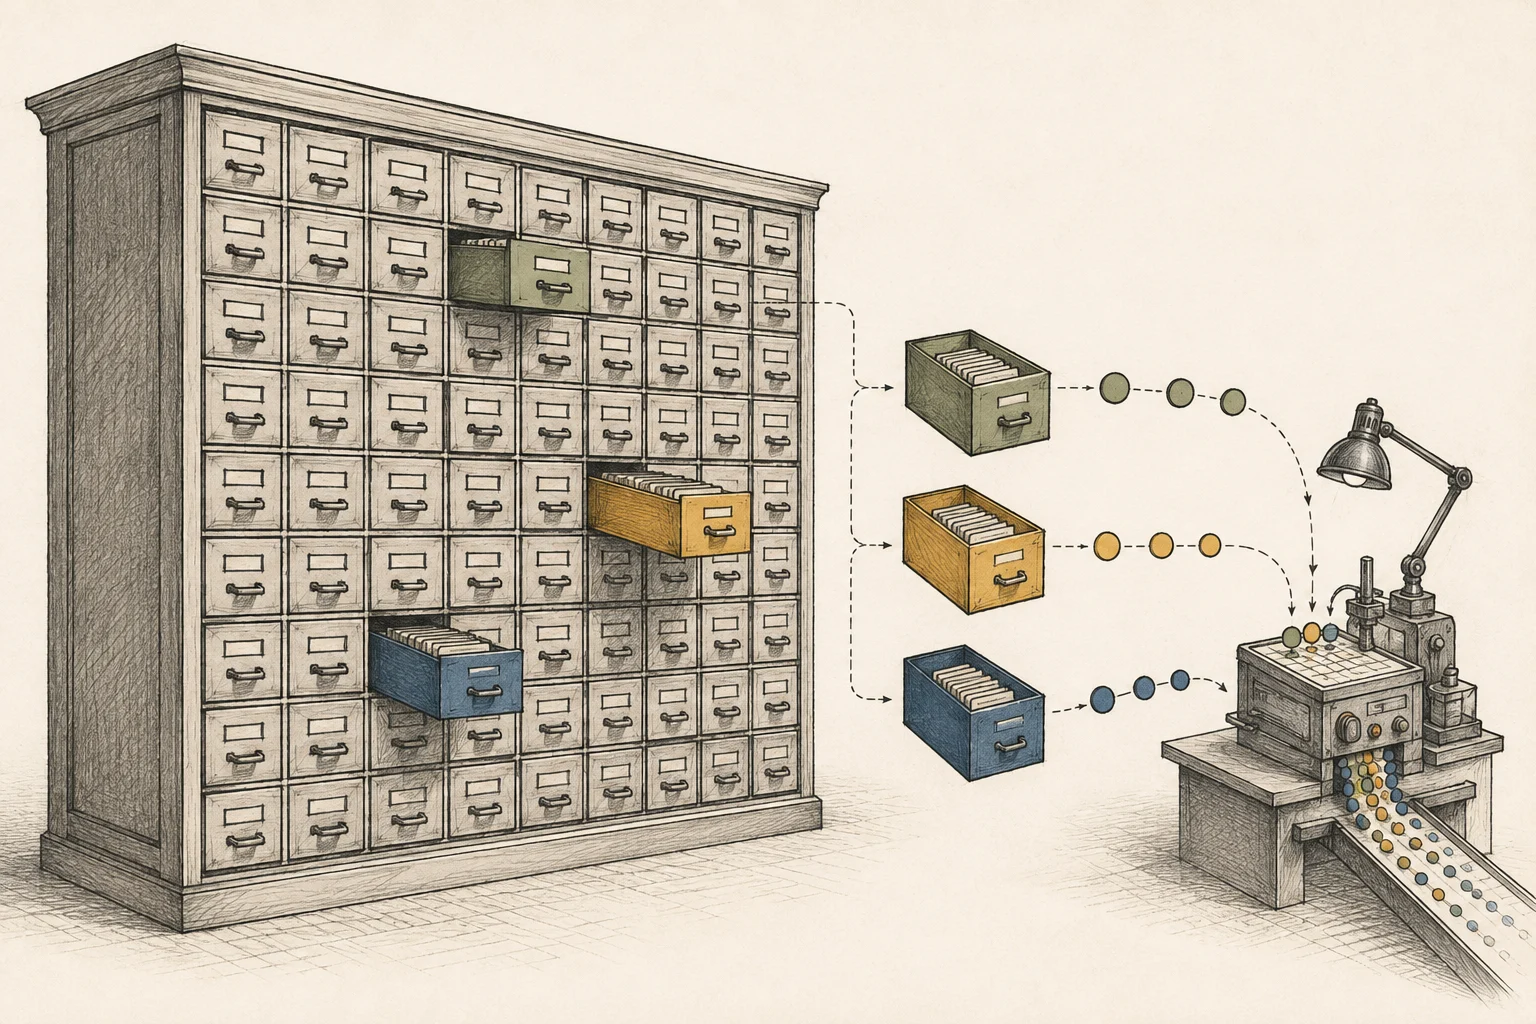
ファイルは24B、計算は2.45Bのモデルです
LFM2.5-24B-A2Bは、質問を受けて回答を生成するテキスト推論モデルです。名前の24Bはモデルが持つ総パラメータ数、A2Bは1トークンを処理するときに実際に計算へ使う有効パラメータが約2B台であることを示します。モデルカードは有効パラメータを2.45Bと記載しています。40層のうち30層は短い畳み込みブロック、10層は通常のアテンション5を使い、各MoEブロックでは64のエキスパートから4つを選びます。
この構造が実用的なのは、メモリと速度が別々に動くからです。読み込むには24B分の重み領域が必要ですが、トークン生成の速度は有効2.45Bの計算量に近づきます。同じ24Bの密モデルと比べれば同じメモリでより多くのトークンが期待でき、逆に7Bクラスの軽いメモリではこのモデルを載せられません。両方の数字を見る必要がある理由です。
韓国語に対応するローカルLLM6を探すなら、対応言語の一覧と実際の韓国語品質を分けて見る必要があります。このモデルは16言語の一覧に韓国語を含め、無料利用の範囲も定めています。
韓国語を含む16言語に対応しています
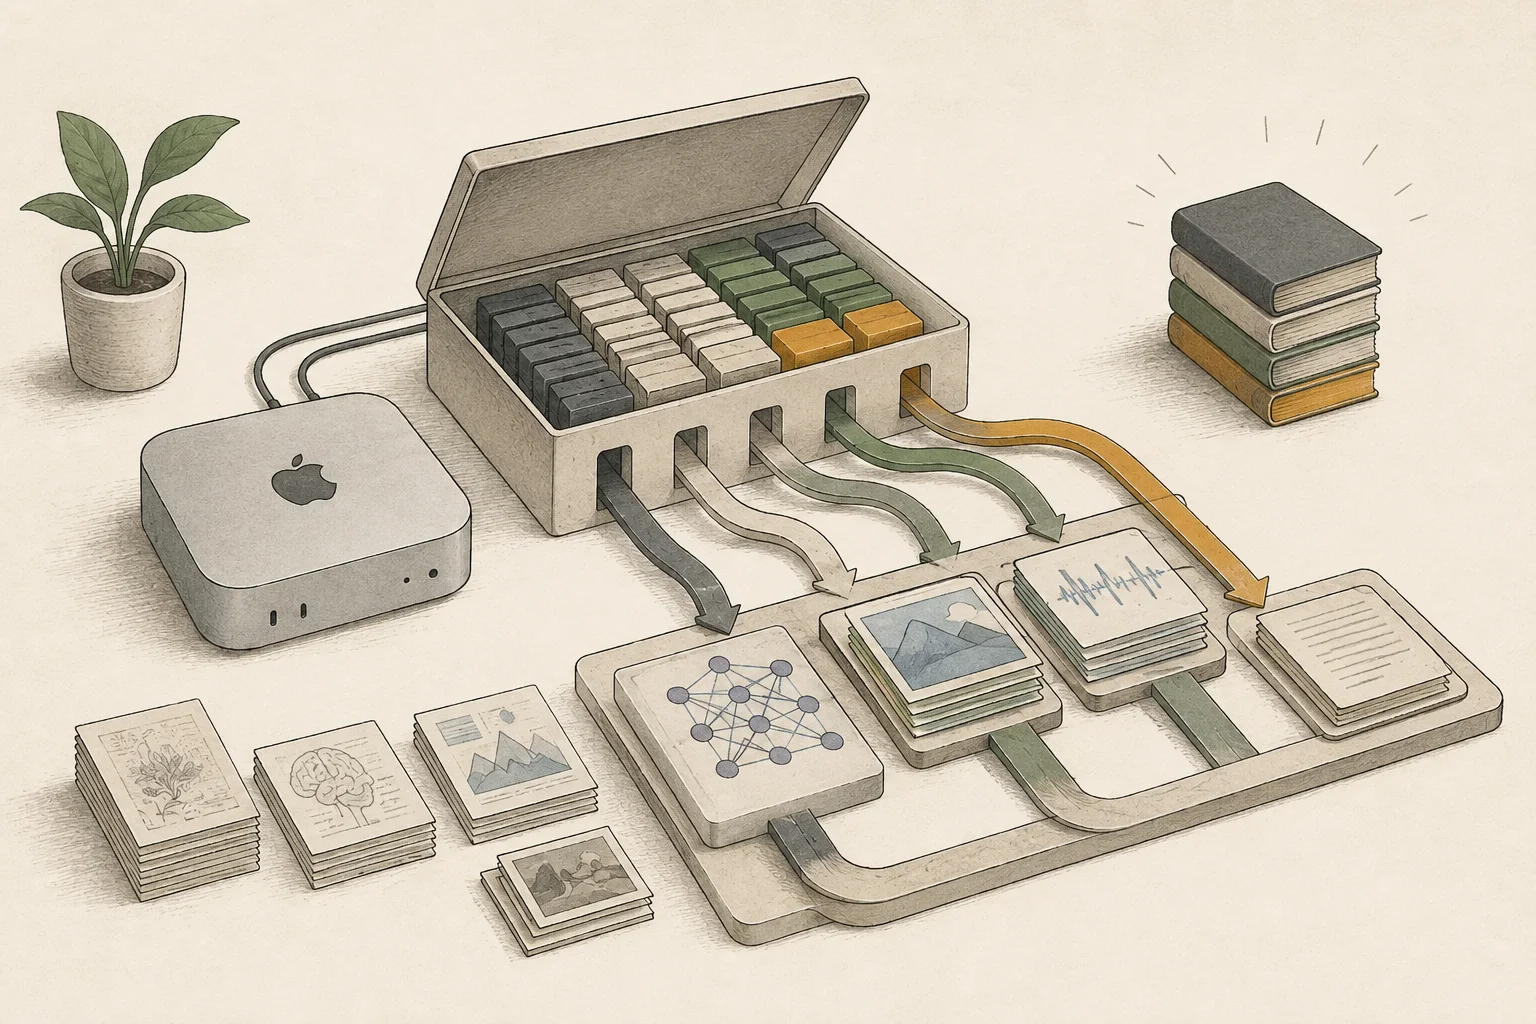
モデルカードは英語、アラビア語、中国語、フランス語、ドイツ語、イタリア語、日本語、韓国語、ポルトガル語、スペイン語、ベトナム語、タイ語、インドネシア語、ヒンディー語、ロシア語、ポーランド語を対応言語として挙げています。韓国語が含まれる点は韓国の利用者にとって重要です。ただし対応言語の一覧は学習データに含まれていたという意味で、韓国語の品質が韓国語特化の24Bモデルと同じという保証ではありません。
用途に合わせて取得するファイルを選びます
公式リポジトリは同じモデルを複数の形式で配布しています。Transformers・vLLM・SGLang向けの元チェックポイント7、ブロック単位のFP88、GGUF、ONNX、Apple Silicon向けのMLX 4bitがあります。llama.cppやOllamaで動かすならGGUF、MシリーズのMacでMLX系ツールを使うならMLX 4bitを選びます。両者は互換性がありません。
ファイルサイズは形式によって大きく変わります。4bit系は元の重みより小さいものの、量子化9の方式によって回答品質と速度も変わります。最初の実行でどのファイルを使ったかを記録しておけば、後で別の形式と比べるときに条件をそろえられます。
ベンダーの測定値と自分の環境の速度を区別します
モデルカードは、同規模の他のMoEより最大1.7倍速く、Apple M5 Maxで184 tok/s、NVIDIA B300 1枚で出力21K tok/sまで出るとしています。この数値はベンダーが決めた条件で測ったものです。自分の環境の速度として読むには、同じハードウェアか、どの量子化ファイルを使ったか、コンテキスト長はいくつか、考えるトークンが出力に含まれたかをまずそろえる必要があります。
推論モデルなので、同じ質問でも考えるトークンが先に出ます。体感の待ち時間を比べるには、最初の回答が出るまでの時間と全体の完了時間を別々に測ってください。考えるトークンを出力に含めるかで2つ目の数値は大きく変わります。
エージェント向けで、知識の質問には向きません
ライセンスと実行条件を確認します
このモデルのライセンスは一般的なオープンソースではなく、Liquidが定めたLFM Open License v1.0です。個人利用と研究は自由ですが、商用利用には条件があります。年間売上が1,000万米ドル未満であれば商用利用でき、この基準を超えると別途の許可が必要です。ライセンスはこの基準をThresholdと定義し、商用利用の権利を超えない条件に結び付けています。
用語の注釈
MoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るGGUF — モデル情報を格納するファイル形式で、llama.cpp系のツールで広く使われます。
本文に戻るMLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻るAttention — 入力トークン間の関連度を計算し、各位置の情報を現在の表現に反映するニューラルネットワーク演算です。
本文に戻る大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るFP8 — 一つの値を8ビットで表す浮動小数点形式です。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻る検索拡張生成 — 質問に関連する資料を検索してモデル入力に加え、その文脈をもとに回答を生成する方式です。
本文に戻るツール呼び出し — ファイル読み取り、検索、コマンド実行などの外部機能を、名前と引数でモデルが要求する形式です。実行の有無はエージェントランタイムと権限設定が決めます。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- LFM2.5-24B-A2Bは、Liquid AIが2026年10月12日に公開した推論モデルです。64のエキスパートのうち4つだけを選ぶMoE構造なので、重みは24Bを占めますが、1トークンの計算量は約2.45Bです。韓国語を含む16言語に対応し、公式のGGUFとMLX 4bitファイルが同時に配布されているため、MacでもNVIDIA PCでも試せます。ただしモデルカードの184 tok/sはApple M5 Maxで測った値なので、自分の環境の速度として読んではいけません。
- 必要なメモリはどのくらいですか?
- この構造が実用的なのは、メモリと速度が別々に動くからです。読み込むには24B分の重み領域が必要ですが、トークン生成の速度は有効2.45Bの計算量に近づきます。同じ24Bの密モデルと比べれば同じメモリでより多くのトークンが期待でき、逆に7Bクラスの軽いメモリではこのモデルを載せられません。両方の数字を見る必要がある理由です。
- 条件と出典はどこで確認できますか?
- モデルカードは、同規模の他のMoEより最大1.7倍速く、Apple M5 Maxで184 tok/s、NVIDIA B300 1枚で出力21K tok/sまで出るとしています。この数値はベンダーが決めた条件で測ったものです。自分の環境の速度として読むには、同じハードウェアか、どの量子化ファイルを使ったか、コンテキスト長はいくつか、考えるトークンが出力に含まれたかをまずそろえる必要があります。