
新規モデル · 2026.10.23
最終更新
KRAFTON Raon-1 miniのローカルLLM:韓国語30B MoEをRTX 5090 32GBで
韓国製の韓国語モデルをRTX 5090 32GB 1枚で試せます
Raon-1 miniは、KRAFTON AIが韓国語とエージェント作業を狙ってゼロから学習した30B-A4BのMoE1モデルです。総30Bのうち1トークン2あたりの有効パラメータは4Bで、コンテキストは262,144トークンまで対応します。韓国語・英語・日本語・中国語・スペイン語・フランス語・タイ語で学習しました。モデルカードは、NVFP43量子化4によりRTX 5090の32GB 1枚で推論できると案内しています。ただし最終版ではないプレビュー配布で、Hugging Faceでアクセス承認を得なければファイルを取得できません。
韓国語を狙ってゼロから学習しました
Raon-1 miniは、KRAFTON AIが設計し、ゼロから学習した30B-A4BのMoE言語モデルです。30Bは総パラメータ数、A4Bは1トークンあたりの有効パラメータ約4Bを意味します。モデルカードは韓国語の対話とエージェント作業で高い性能を示すと説明しています。他のオープンモデルを再学習したものではなく、自社で学習したモデルである点が特徴です。
学習言語は韓国語、英語、日本語、中国語、スペイン語、フランス語、タイ語です。モデルカードは韓国語が強く、英語も堅実だと記載しています。韓国の利用者にとって、韓国語が学習言語に含まれること自体に意味があります。ただし各言語への学習配分は公開されていないため、韓国語の品質は自分で確認するほうが正確です。
このモデルが韓国の利用者にとって重要なのは、韓国語を学習に含む韓国製モデルだからです。韓国語のローカルLLM5を探しているなら、RTX 5090 32GB 1枚でまず試せます。
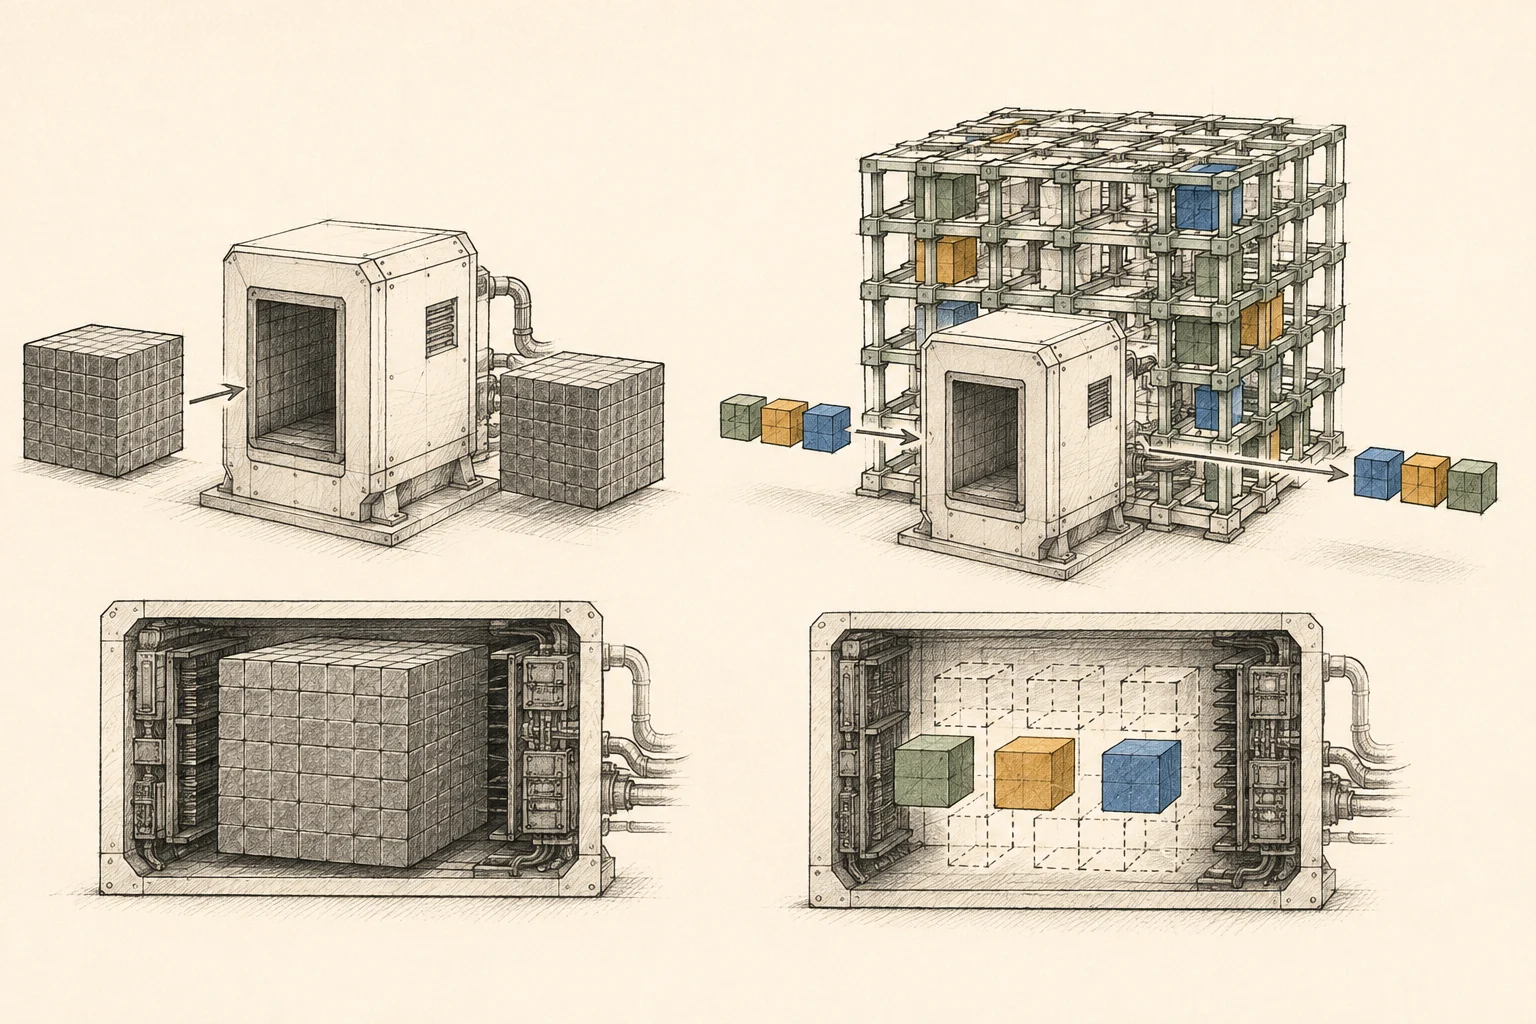
アテンション構造を変えて長い文脈のコストを下げました
アクセス承認を受けてからファイルを選びます
プレビューである点を結果の解釈に反映します
モデルカードは、この配布が最終版ではなく、仕様と結果が最終版で変わり得ると明記しています。ベンチマーク表もプレビュー基準です。数週間後に同じ名前の正式版が出ればスコアや推奨仕様が変わる可能性があるため、業務に組み込む前にバージョンと測定日を一緒に記録しておいてください。
比較表はRaon-1 miniをQwen3.6-35B-A3B、Gemma 4 26B-A4B、Qwen3.8-27B、Muse Glimmer 30Bと並べています。同じ表にあっても測定環境が同じとは限らないため、別途確認が必要です。特に知識系ベンチマークでは他モデルより低い項目もあるため、発表が強調する推論・指示追従・エージェントの項目と合わせて見るべきです。

韓国語の文書作業なら、早めに比較する理由があります
韓国の利用者にとって魅力的なのは、韓国語を学習言語に含むモデルをRTX 5090クラスの環境で試せることです。議事録の要約、社内文書の分類、韓国語の顧客対応の下書きのように韓国語の入力が核心となる作業なら、既存のQwenやGemma系と同じ文で比較する価値があります。
逆に英語のコード作成や長い英語文書の処理だけを行うなら、このモデルを先に選ぶ理由は弱くなります。同じメモリで既に検証済みの別モデルと比べて優位が見えたときだけ切り替えるのが安全です。プレビューモデルを業務の基準にせず、検証用の候補として置いてください。
Apache 2.0の条件を確認します
Raon-1 miniはApache 2.0ライセンスで配布されています。商用利用、改変、再配布が認められ、売上の基準はありません。アクセスゲートは配布方法にすぎず、ライセンス条件を狭めるものではありません。ただしApache 2.0は著作権表示と変更の明示を求めるため、製品に組み込むときはライセンスとNOTICEを一緒に保管してください。
用語の注釈
MoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るNVFP4 — NVIDIAが定義した4ビット浮動小数点データ形式です。対応状況はGPU世代、モデル、ソフトウェア実装によって異なります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻る大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るAttention — 入力トークン間の関連度を計算し、各位置の情報を現在の表現に反映するニューラルネットワーク演算です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るBF16 — モデルの数値に使う16ビット浮動小数点形式です。指数部はFP32と同じ幅で、同程度に広い値の範囲を表せます。
本文に戻るGGUF — モデル情報を格納するファイル形式で、llama.cpp系のツールで広く使われます。
本文に戻るMLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Raon-1 miniは、KRAFTON AIが韓国語とエージェント作業を狙ってゼロから学習した30B-A4BのMoEモデルです。総30Bのうち1トークンあたりの有効パラメータは4Bで、コンテキストは262,144トークンまで対応します。韓国語・英語・日本語・中国語・スペイン語・フランス語・タイ語で学習しました。モデルカードは、NVFP4量子化によりRTX 5090の32GB 1枚で推論できると案内しています。ただし最終版ではないプレビュー配布で、Hugging Faceでアクセス承認を得なければファイルを取得できません。
- 必要なメモリはどのくらいですか?
- 長い文脈が必要な作業では、この構造によってメモリ使用量を予測しやすくなります。ただし実行環境がこのアテンション構成に対応していてこそ意味があります。llama.cpp、Ollama、vLLMがそれぞれいつ対応したかを確認してからファイルを選んでください。
- 条件と出典はどこで確認できますか?
- 学習言語は韓国語、英語、日本語、中国語、スペイン語、フランス語、タイ語です。モデルカードは韓国語が強く、英語も堅実だと記載しています。韓国の利用者にとって、韓国語が学習言語に含まれること自体に意味があります。ただし各言語への学習配分は公開されていないため、韓国語の品質は自分で確認するほうが正確です。