
まず読み込み
最終更新
RTX SparkノートPC、DGX Spark・MacBook Proと何が違う?
モデル互換性と携帯性のどちらを優先するか、比較表から考えましょう。
RTX SparkノートPCは、CUDA1対応Blackwell GPU2とCPU3・GPU共有メモリを備えるWindows on Armプラットフォームです。DGX SparkはLinuxベースのデスクトップAIシステム、MacBook ProはmacOSとApple SiliconのMLX4・Core ML5エコシステムを使います。購入するSKUでGPUが利用できるメモリと、必要なアプリ・モデルレシピで比較します。
RTX Sparkは複数メーカーのノートPCに採用されるWindows on Armプラットフォームです。Blackwell RTX GPUとGrace CPUがunified memory6を共有します。選ぶSKUでGPUが利用できる容量と、Windows・アプリ・model runtime7が使うメモリを合わせて確認してください。Microsoft Surface構成
比較対象のDGX SparkはGB10、128GB coherent unified memory、DGX OSを備えたデスクトップシステムです。MacBook ProはmacOSで動作し、Apple Silicon unified memory構成とMLX・Core MLアプリを選べます。メモリ容量が近く見えても、OS、アプリ互換性、runtime recipe、電力・熱設計は異なります。NVIDIA DGX Spark・Apple MacBook Pro仕様
RTX SparkノートPCと最大仕様
RTX Spark ノート PC は、Windows on Arm、Grace CPU、Blackwell RTX GPU、ユニファイドメモリを備えたプラットフォームです。Microsoft が公開した Surface Laptop Ultra の最大構成は、15 インチ画面、最大 20 コアの Grace CPU、最大 6,144 個の Blackwell GPU コア、最大 128GB のユニファイドメモリです。
AI 性能の最大値は FP4 と sparsity を適用した理論値です。実際の処理時間は、使用する runtime、モデル、入力をそろえて測定します。Surface の発表と SKU 仕様
GPU が使用できるメモリは、システムのユニファイドメモリ 128GB 全体より少なくなります。モデルの重みや KV cache8 のほか、Windows、ブラウザー、IDE、画像・動画フレーム9も同じメモリプールを共有します。
製品 SKU の総メモリと GPU が使用できるメモリを区別し、モデル recipe の最小メモリ要件と context の割り当ても確認します。
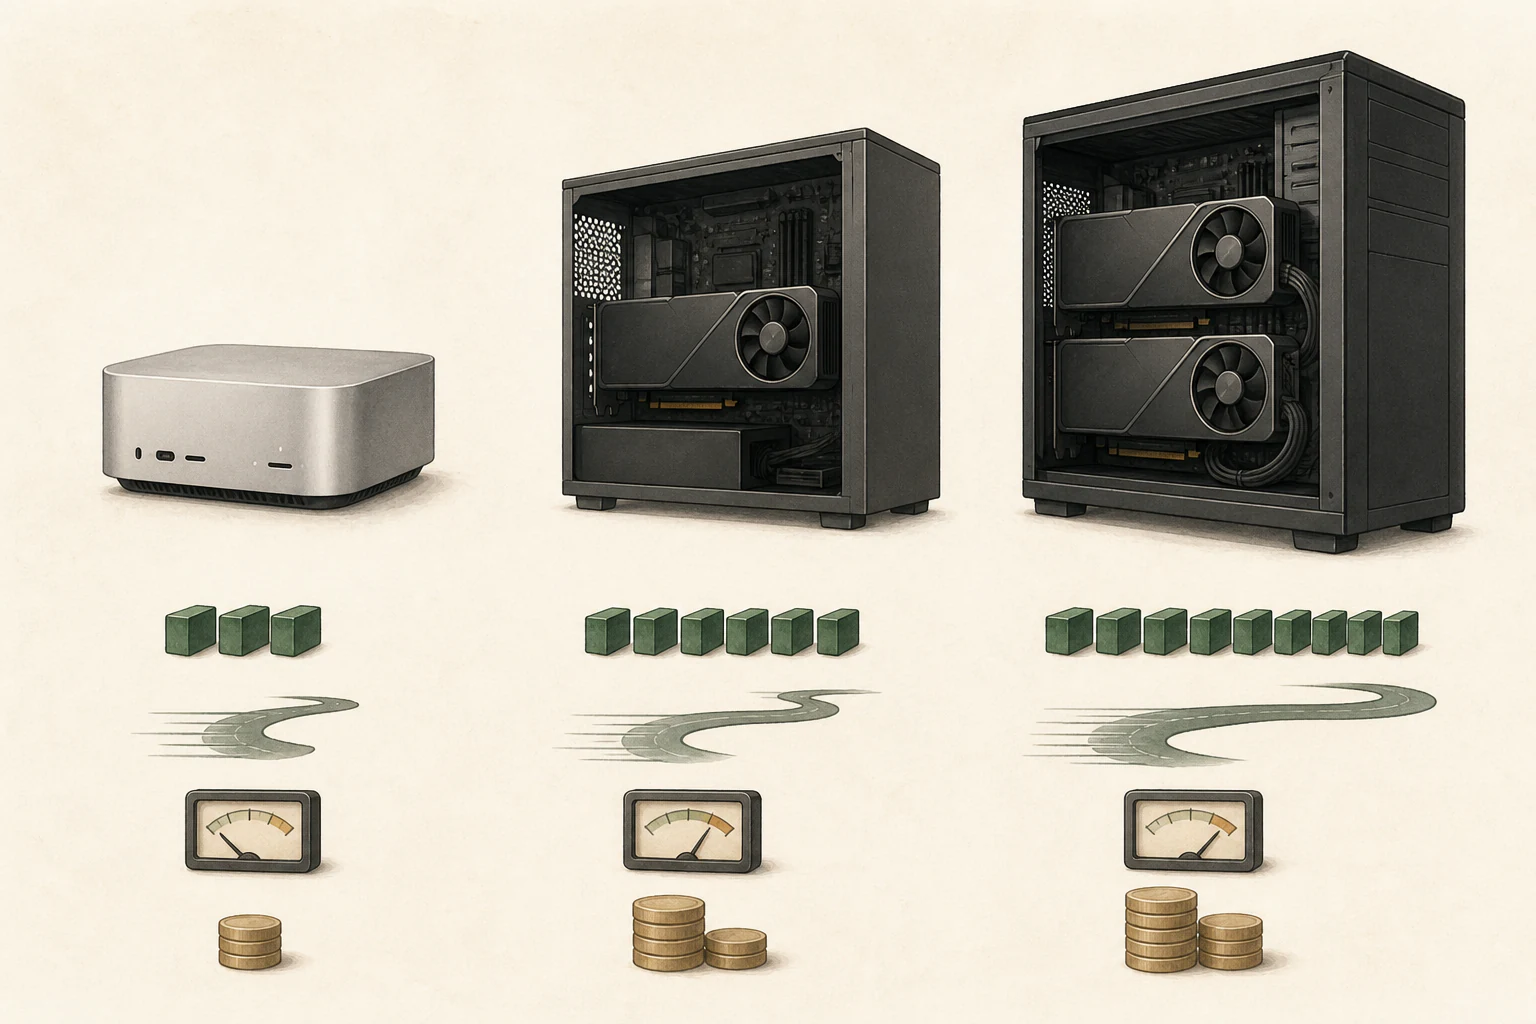
DGX Spark・MacBook Proと比較して選ぶ
3つのプラットフォームでは、ローカル推論という共通点よりOSとruntimeの互換性が選択を左右します。ノートPCでCUDAとWindows制作アプリを使うならRTX Spark、LinuxとNVIDIA serving recipeを中心とするデスクトップならDGX Spark、macOSアプリとMLX・Core ML中心ならMacBook Proの構成を確認します。
| 機器 | OS・設置形態 | メモリ・AIアプリ経路 |
|---|---|---|
| RTX SparkノートPC | Windows on Arm・携帯型 | SurfaceのSKU別unified memory。GPU利用可能量はその一部 |
| DGX Spark | DGX OS/Linux・デスクトップ | GB10・128GB coherent unified memory。NVIDIA DGX/vLLMの開発経路 |
| MacBook Pro | macOS・ノートPC | Apple Silicon unified memoryはSKU別。MLX・Core MLエコシステム |
MacBook Proのメモリ構成はchipによって異なります。NVIDIAとAppleの数値は各社のplatform仕様であり、性能比較ではありません。
AppleはMacBook Proのunified memory容量がchipとGPU SKUで異なると案内しています。2026年M5 Pro/M5 Max仕様では、40-core GPUのM5 Max構成は最大128GB、M5 Pro構成は最大64GBです。MacではMLXやCore MLなどアプリが対応するモデル形式、RTX SparkではWindows on Arm・CUDA経路を確認して選びます。Apple MacBook Pro仕様
Windows on Armとアプリの版を確認
Windows には Arm64 アプリと Prism 経由で動作する x86 アプリがあります。NVIDIA と Microsoft は RTX Spark で CUDA と開発ツールをサポートすると発表しました。使用するパッケージ、プラグイン、コンテナが Windows on Arm の CUDA 経路に対応するか、各製品のドキュメントで確認します。
x86 のコマンドラインアプリが動作しても、CUDA 拡張やドライバーが同じように動作するとは限りません。RTX Spark の Windows 開発環境
2026年10月16日のRTX SparkノートPC発売は、地域やSKUによって入手状況が異なる場合があります。発表メーカー一覧から候補を探し、最終判断は製品ページのメモリ、ストレージ、画面・熱設計、Armアプリ互換性で行います。NVIDIA COMPUTEXプラットフォーム発表

購入前:正確なSKUとアプリ対応を確認
購入前に使うモデルのcheckpoint10容量、必要なcontext、画像・動画入力の有無を決め、候補SKUのGPU利用可能メモリと照らし合わせます。モデルとアプリのWindows Arm64・CUDA対応も各ドキュメントで確認してください。実際の要求を使う試験は購入後に行い、展示機を使える場合は事前に試してもよいでしょう。
公開されている Surface Laptop Ultra の仕様は、発表済み RTX Spark ノート PC の中で確認できる最大構成の例です。他の RTX Spark モデルは同じプラットフォームを使っていても、メモリ、ディスプレイ、バッテリー、冷却構成が異なる場合があります。
購入する製品の正確な注文 SKU とメーカー仕様に基づいて、メモリと AI 作業性能を比較します。
購入後:使うモデルとworkloadで実行を確かめる
NVIDIA は Windows 11 ARM と llama.cpp を使い、128GB の Surface Laptop Ultra で Bolt IQ2_XXS と LiLiCorr を測定しました。AIPerf SPEED-Bench-Coding の結果は 83.99 TPS で、同じテストの AA-AgentPerf Local の再生時間は 600.80 秒でした。
これは公開された RTX Spark ノート PC の数値のうち、実際のモデルと runtime の組み合わせ例です。DGX Spark や MacBook Pro の測定値とは分けて比較します。Bolt のテスト条件
機器を受け取ったら使用予定のcheckpointを用意し、同じ短い要求を繰り返して初回読み込みと以後の応答を分けて確認します。次に普段のアプリを開き、context、画像解像度、動画フレームを増やしながらGPUメモリ、完了時間、ファン音、電源状態を記録します。MacBook Proとの比較でもモデル、量子化11、context、要求をそろえると実作業の判断材料になります。
用語の注釈
CUDA — NVIDIA GPUで汎用計算を行うソフトウェア基盤です。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るCPU — OSや一般的なプログラム命令を実行する中央処理装置です。AIでは前処理やデータ転送などの汎用処理も担います。
本文に戻るMLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻るCore ML — Apple機器で機械学習モデルを実行するフレームワークです。
本文に戻るユニファイドメモリ — CPUとGPUが同じ物理メモリ領域を共有する構造です。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るフレーム — 動画を構成する1枚の画像です。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- RTX SparkノートPCは、CUDA対応Blackwell GPUとCPU・GPU共有メモリを備えるWindows on Armプラットフォームです。DGX SparkはLinuxベースのデスクトップAIシステム、MacBook ProはmacOSとApple SiliconのMLX・Core MLエコシステムを使います。購入するSKUでGPUが利用できるメモリと、必要なアプリ・モデルレシピで比較します。
- 必要なメモリはどのくらいですか?
- RTX Spark ノート PC は、Windows on Arm、Grace CPU、Blackwell RTX GPU、ユニファイドメモリを備えたプラットフォームです。Microsoft が公開した Surface Laptop Ultra の最大構成は、15 インチ画面、最大 20 コアの Grace CPU、最大 6,144 個の Blackwell GPU コア、最大 128GB のユニファイドメモリです。